
Кратко
- Fable 5.1 — не про то, что модель «стала умнее вообще», а про то, что она научилась работать часами самостоятельно: на научных задачах в терминале прирост более чем вдвое.
- Контекст — миллион токенов (около 1,5 тыс. страниц), знания по июнь 2026, на входе текст и изображения, на выходе только текст.
- В общей эрудиции без инструментов прогресс почти незаметен — плюс 1,2 балла к предыдущей версии.
- У Fable 5.1 нельзя отключить рассуждения, можно только выбрать их глубину — для короткого бытового вопроса это делает модель избыточной.
Claude Fable 5 что умеет — и чем 5.1 отличается от предыдущей версии? Коротко: главный рывок не в общих знаниях, а в самостоятельной работе — модель дольше держит план действий, реже ошибается в агентных сценариях и заметно лучше справляется с научными задачами в терминале. Разбираем, что умеет fable 5.1 по бенчмаркам и на практике, а не по формулировкам из релиза. Про дату выхода и технические характеристики модели мы уже писали в материале про релиз Claude Fable 5.1 — здесь только про возможности.
Fable 5.1 что это: паспортные данные
Контекстное окно Claude Fable 5.1 — 1 000 000 токенов, это около полутора тысяч страниц текста в одном разговоре. Максимальная длина ответа — 128 000 токенов, знания актуальны по июнь 2026 года. На входе модель принимает текст и изображения, на выходе — только текст. Формально это тот же паспорт, что и у прошлой версии, разница начинается там, где кончаются цифры контекста, — в том, как модель ведёт себя на длинных самостоятельных задачах.
Именно поэтому вопрос «claude fable 5 что умеет» и вопрос «что нового в fable 5.1» — это, по сути, два разных вопроса. Контекст, модальности входа и формат ответа не изменились: миллион токенов был и у прошлой версии. Изменилось поведение модели внутри этого окна на длинных самостоятельных прогонах — а это как раз то, что напрямую не видно в таблице характеристик и проявляется только на практике или в специализированных бенчмарках.
Главный рывок: самостоятельная работа без присмотра
Заявленное новое умение Fable 5.1 — многочасовые автономные прогоны, где модель сама держит в голове план и не теряет его на середине задачи. Нагляднее всего это видно на бенчмарке Terminal-Bench-Science 0.1, который проверяет решение научных задач прямо в терминале: Fable 5.1 набирает 52,6% против 24,7% у Fable 5 — больше чем вдвое. Для сравнения, у конкурентов на этом же тесте результат заметно ниже: у Opus 5 — 29,0%, у GPT-5.6 Sol — 22,4%.
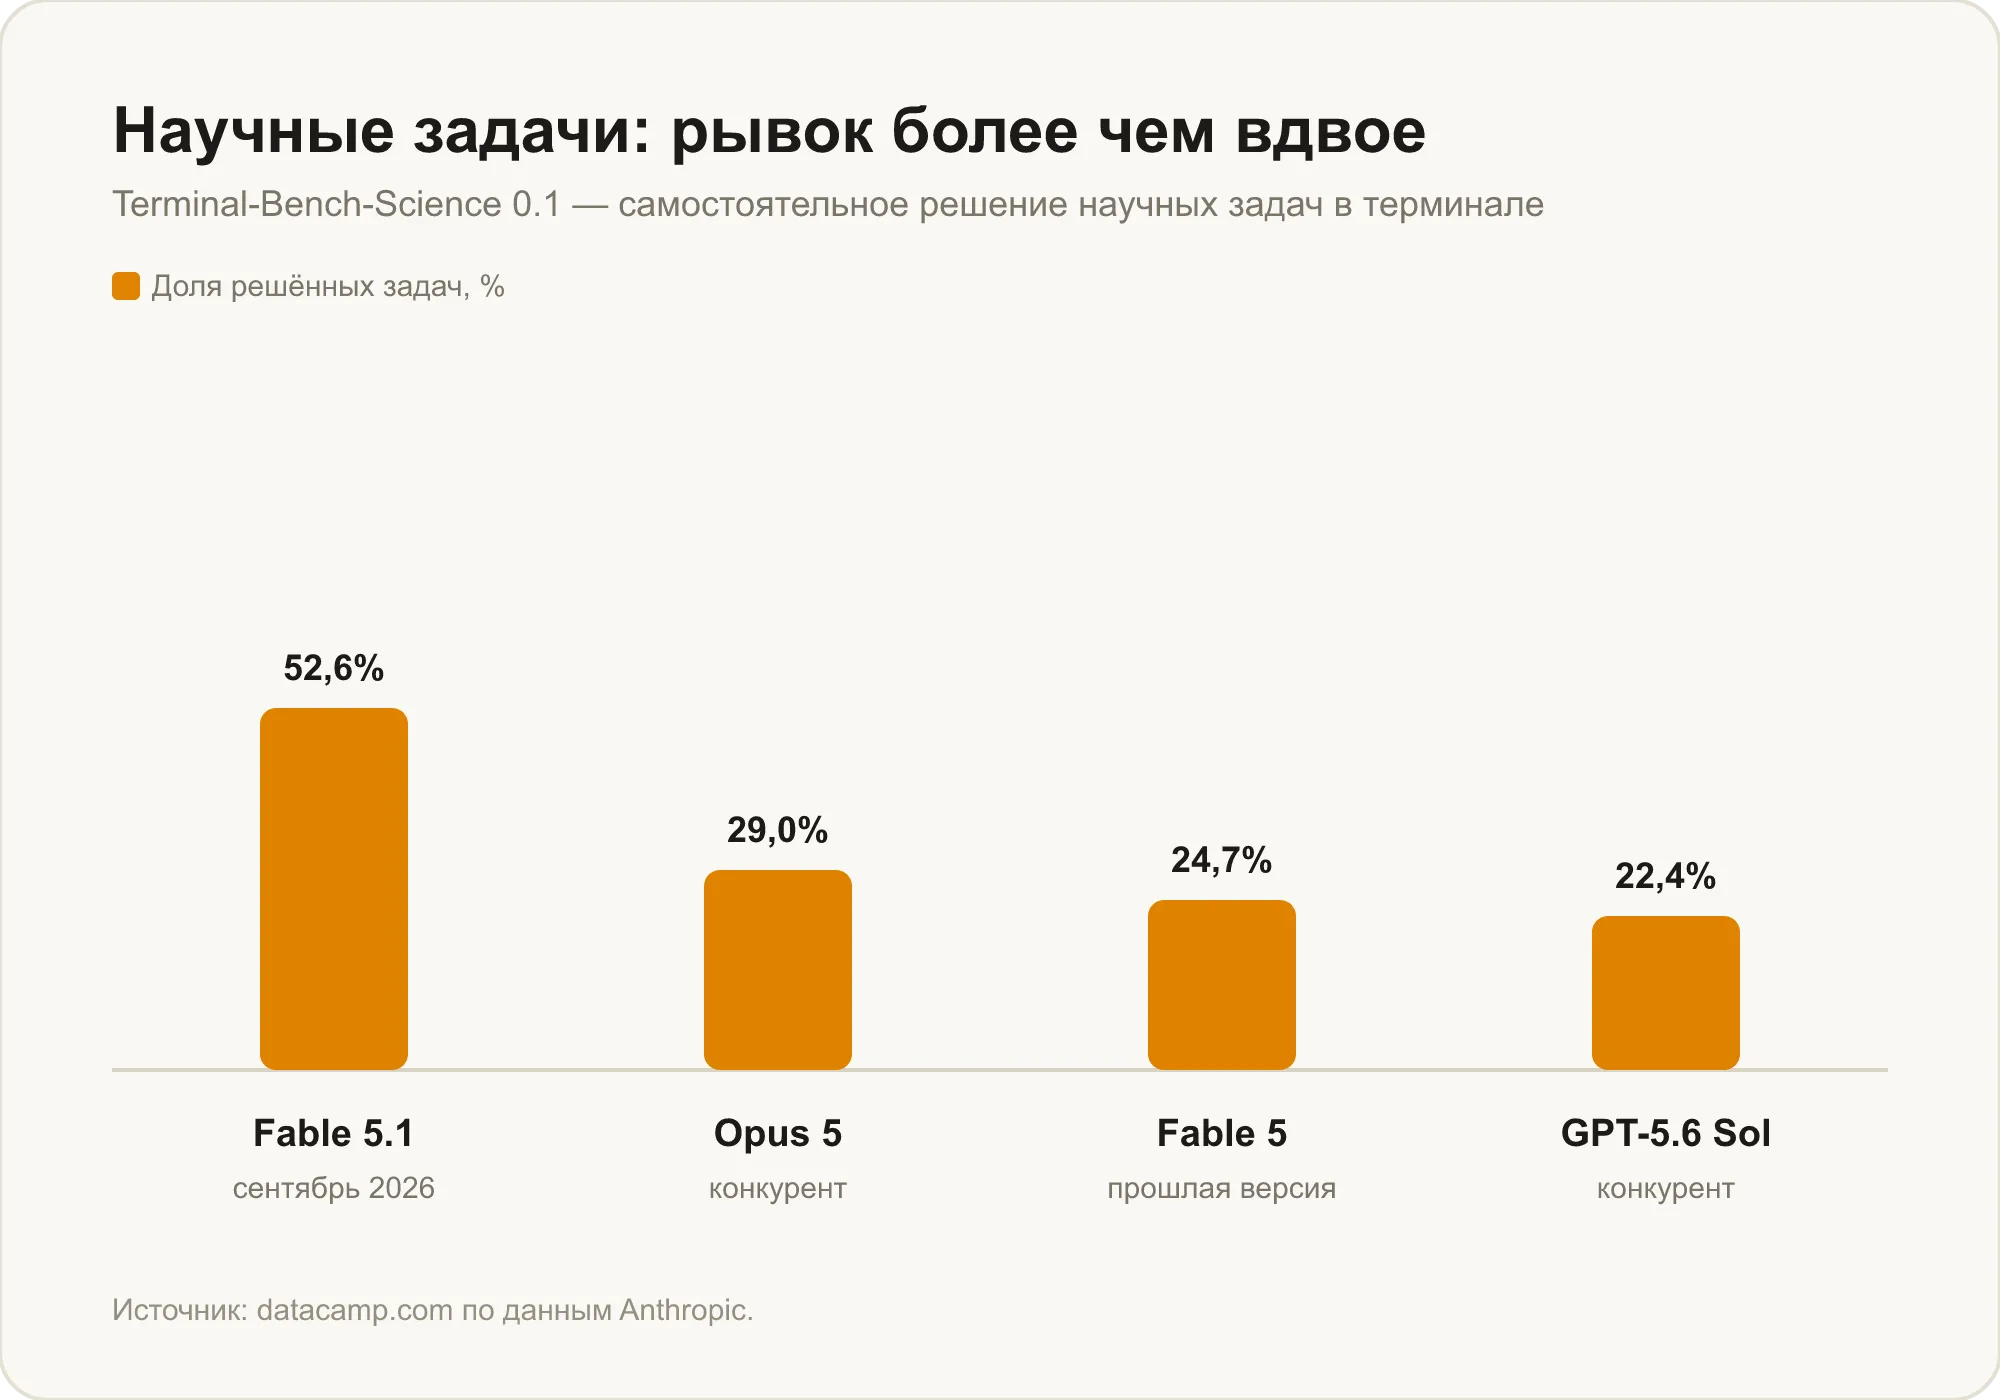
Разрыв больше чем вдвое на одном тесте — это не погрешность, а смена класса задач, которые модель способна вытянуть без пошагового контроля со стороны человека.
Остальные агентные бенчмарки: не только наука
Прирост в самостоятельности подтверждается и на других тестах — если собрать все fable 5.1 benchmarks в одну таблицу, картина везде похожая. В терминале в целом (Terminal-Bench 4.0) Fable 5.1 набирает 55,8% против 42,0% у Fable 5 и 52,3% у Opus 5. В автоматизации рутинных операций (AutomationBench) — 31,4% против 17,1% у предыдущей версии, почти вдвое. В работе внутри программ (OSWorld 2.0, строгий режим) — 41,7% против 36,1% у Fable 5 и 39,6% у Opus 5. В правках уже существующего кода (CursorBench 3.2.0) — 73,4% против 70,5% и 70,0% соответственно.
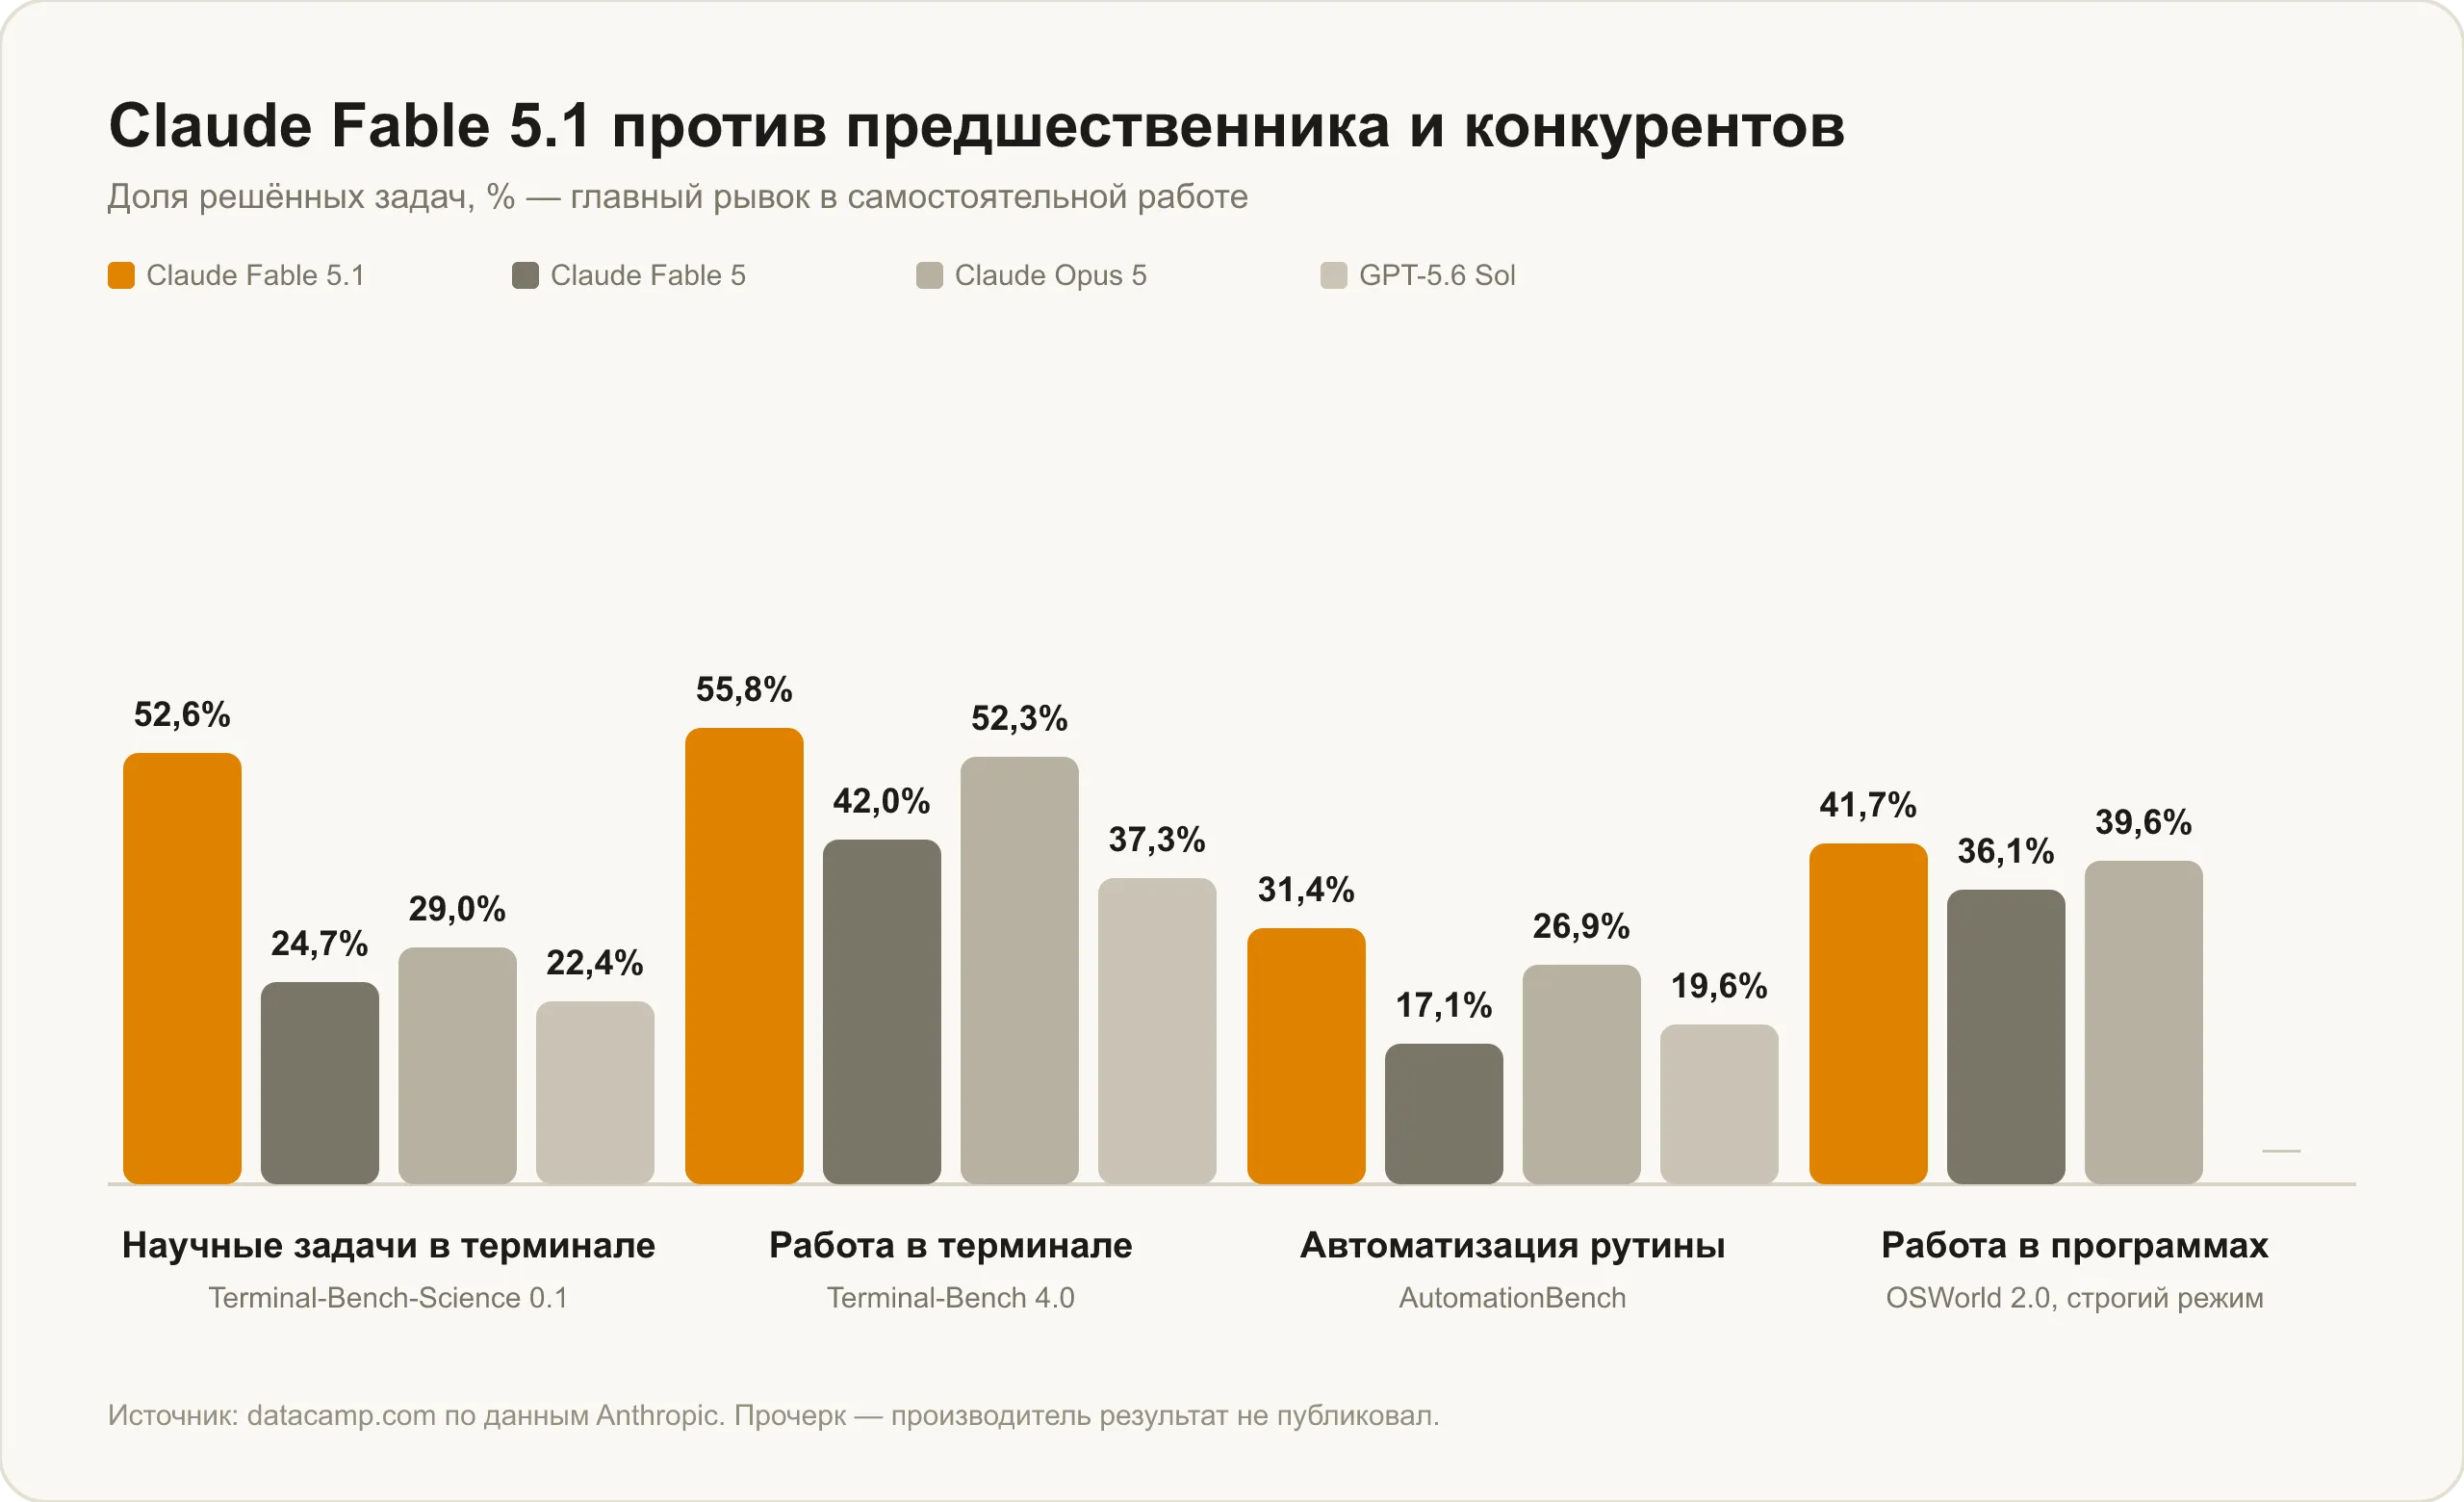
Отдельно выделяется результат на GDPval-AA — тесте, который оценивает выполнение задач, близких к реальной профессиональной работе, через рейтинг Elo: у Fable 5.1 он 1853 против 1723 у Fable 5 и 1824 у Opus 5. В сумме эти цифры и дали модели первое место в общем индексе Artificial Analysis — 66 баллов из 196 моделей в рейтинге (у Opus 5 — 63,1, у Fable 5 — 62,1). Индекс кодинга у Fable 5.1 вырос до 81,6 с 76,5, агентный индекс — до 61,3 с 56,6.
Практическая причина этого рывка тоже названа в описании модели: удешевление кэша делает длинные агентные циклы экономически осмысленными — раньше многочасовой прогон агента обходился дорого именно из-за повторной обработки контекста, теперь это не так критично. Отдельно заявлено снижение числа ложных срабатываний: на 60% меньше в задачах по поиску уязвимостей и на 85% меньше на элементарных вопросах по биологии — обе цифры о том, что модель реже «видит» проблему там, где её нет, а не о том, что она стала точнее в целом.
Тем, кто выбирает модель именно под кодинг, полезно свериться с более широким разбором — какая нейросеть лучше пишет код в разных сценариях, от чат-ассистентов до IDE-агентов, потому что один бенчмарк редко описывает всю картину.
Где прироста почти нет: широкая эрудиция
Здесь честность важнее эффектных цифр. В тесте на широкую эрудицию с использованием инструментов (Humanity's Last Exam) Fable 5.1 набирает 65,0% против 63,8% у Fable 5 — прирост всего 1,2 балла. Это резко контрастирует с двукратными скачками на агентных задачах.
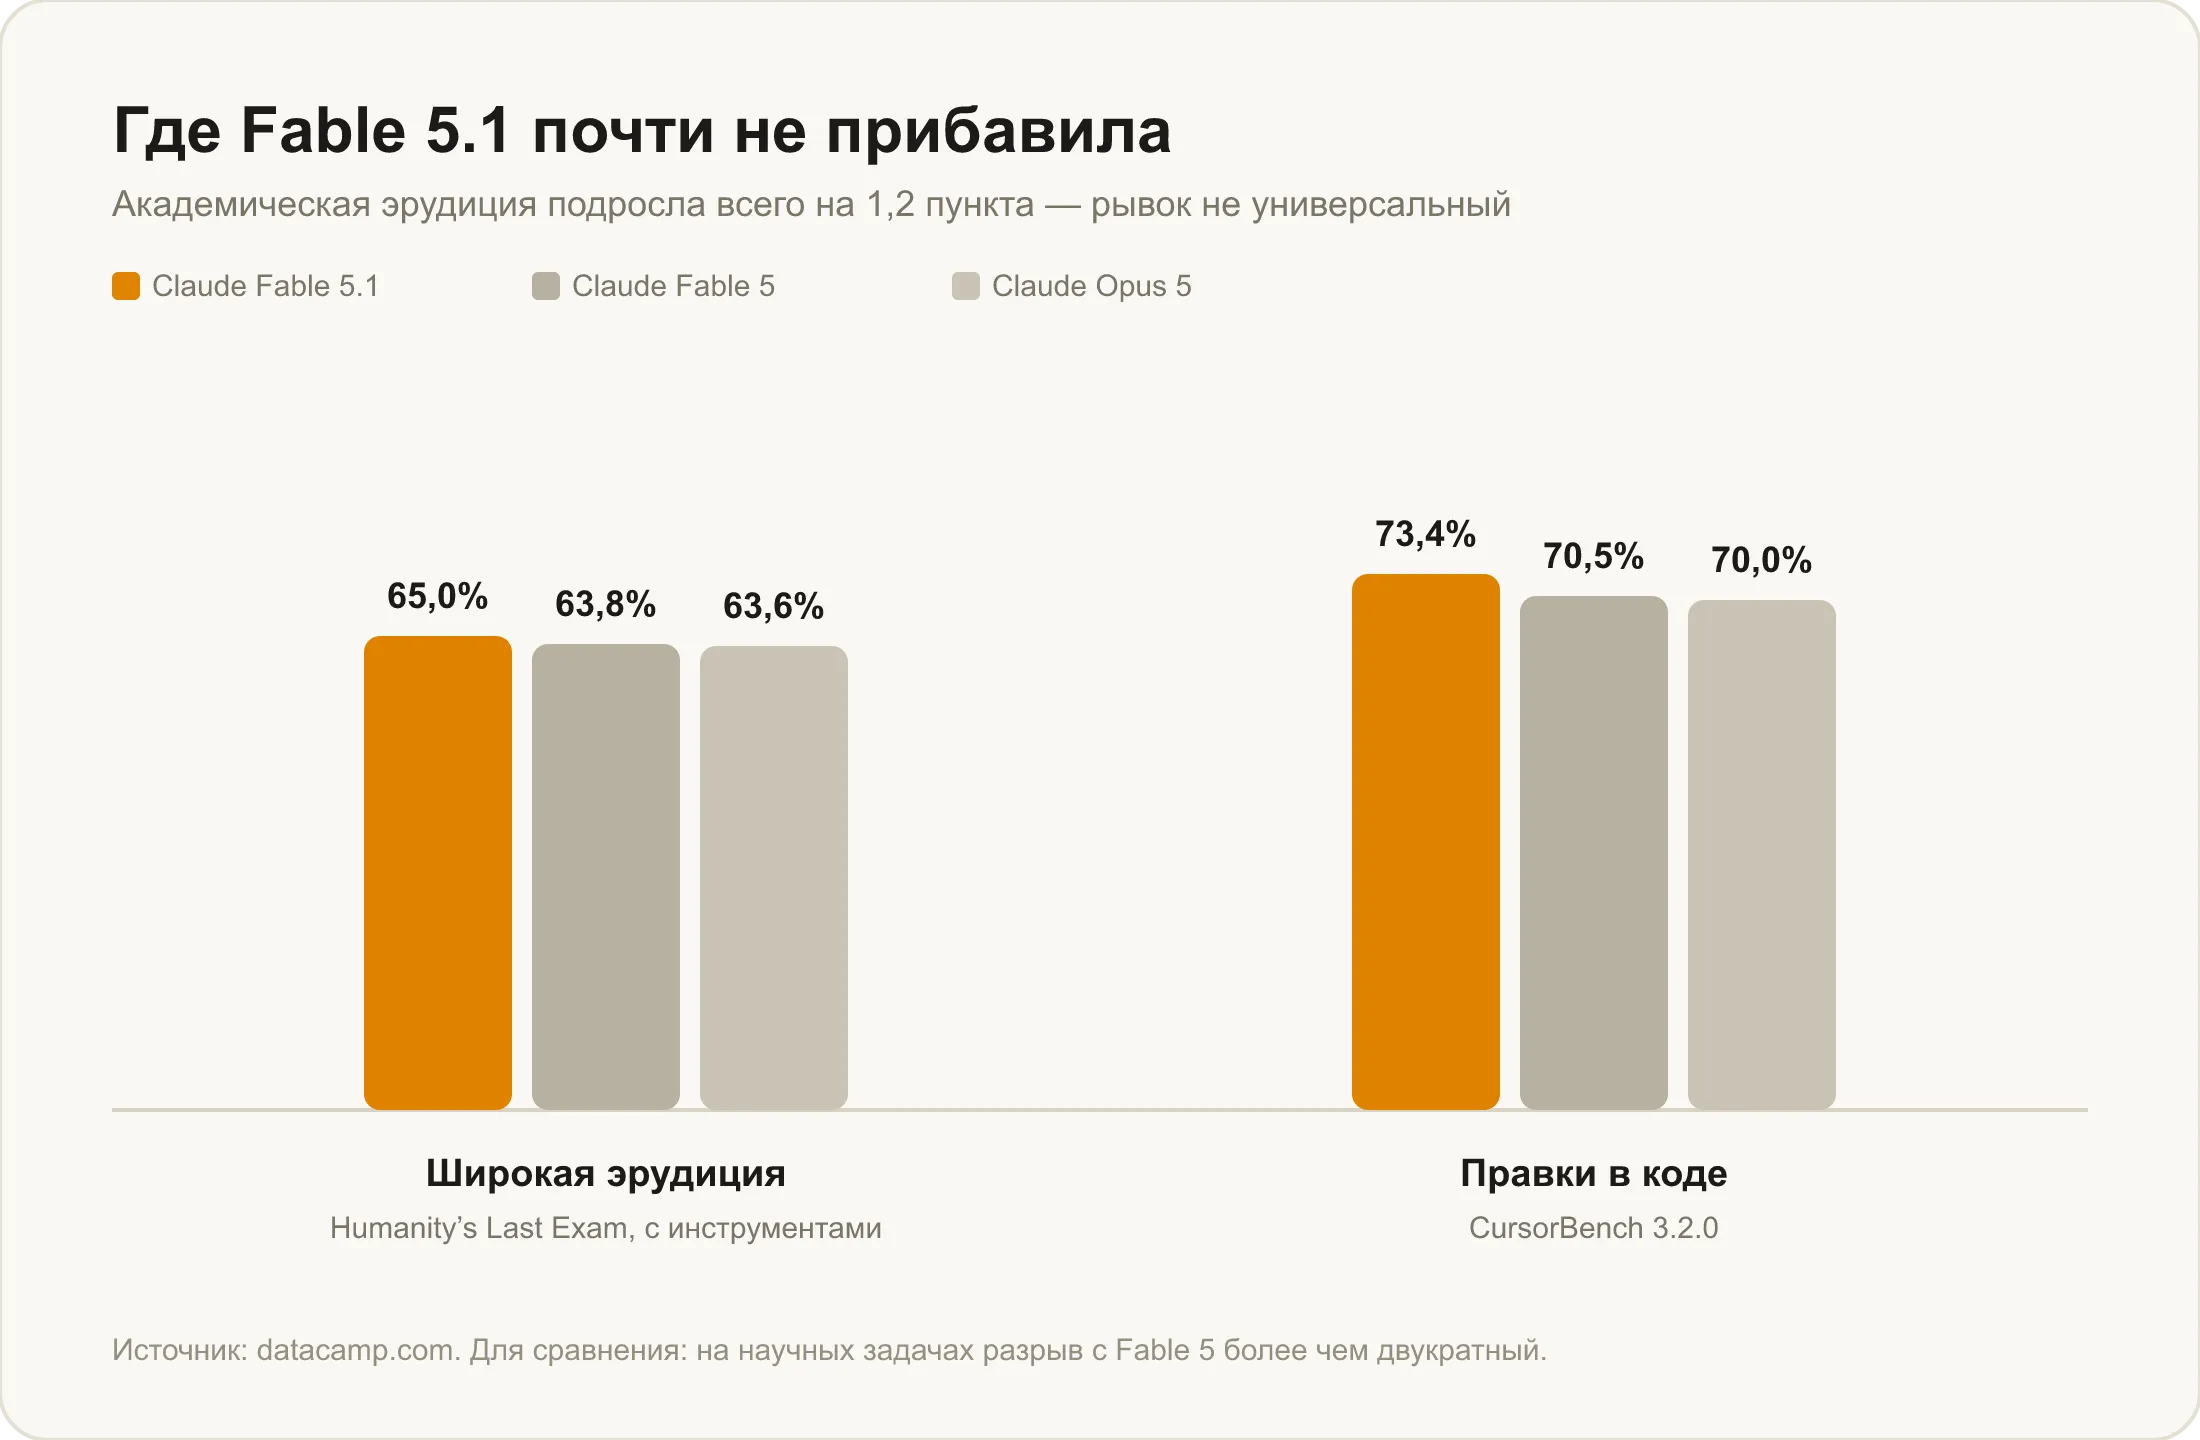
Вывод из этого простой: рывок Fable 5.1 узкий и предметный — он в самостоятельной, многошаговой, агентной работе, а не в том, что модель стала «умнее вообще». Если задать ей произвольный вопрос на общую эрудицию, разницы с предыдущей версией читатель скорее всего не заметит — и это не повод считать обновление слабым, просто оно решает другую задачу.
Для каких задач Fable 5.1 подходит, а для каких избыточна
Из бенчмарков складывается достаточно чёткая картина применимости. Fable 5.1 стоит брать под задачи, где решение растягивается на много шагов и требует удержания плана без постоянного участия человека: длительная работа в терминале, автоматизация цепочки рутинных операций, самостоятельные действия в интерфейсах программ, доработка объёмного кода, научные и инженерные расчёты с несколькими этапами. Именно за такие сценарии модель всё чаще называют нейросетью для агентов, хотя формально это по-прежнему универсальный чат-ассистент.
Общая логика простая: чем длиннее и самостоятельнее сценарий, тем заметнее разрыв с предыдущей версией. На разовом запросе — «напиши функцию», «объясни термин», «сократи абзац» — Fable 5.1 отработает не хуже Fable 5, но и не сильно лучше: там, где не нужно долго держать план и возвращаться к предыдущим шагам, преимущество новой версии просто не успевает проявиться.
А вот для короткого бытового вопроса, разовой правки текста или простого уточнения модель, скорее всего, избыточна — и дело не только в том, что прирост в эрудиции минимален. У Fable 5.1 нельзя отключить рассуждения — можно выбрать только их глубину: низкую, среднюю или высокую. Это мы проверили сами при подключении модели в каталог. Следствие честное: даже на элементарный вопрос ответ идёт с ощутимой задержкой, потому что модель обязана хотя бы немного «подумать» перед ответом. Для таких сценариев разумнее взять модель полегче — благо в одном чате их можно переключать без потери контекста разговора.
Как попробовать Claude Fable 5.1 в Veruna AI
Claude Fable 5.1 добавлена в каталог моделей Veruna AI и открыта на подписке Max — актуальные условия смотрите на странице тарифов. Без VPN, оплата в рублях: подключение к модели устроено так же, как и к остальным в каталоге. Про сам процесс доступа из России мы подробно разбирали в статье как пользоваться Claude Fable 5.1.
Практический смысл платформы не в отдельной функции, а в самом формате: модели переключаются в одном окне. Тяжёлую Fable 5.1 логично брать под задачу, где нужна многошаговая самостоятельная работа, а на короткий вопрос — переключаться на модель полегче, не открывая для этого второй сервис.
Короткие сценарии
Многошаговая работа в терминале или агентный сценарий без пошагового контроля. По этим задачам Fable 5.1 показывает разрыв с предшественником больше чем вдвое.
Научная или инженерная задача с несколькими этапами вычислений — область, где модель набрала наибольший прирост среди всех бенчмарков.
Доработка объёмного существующего кода — прирост заметный, но не революционный, стоит свериться с другими моделями каталога под конкретный проект.
Быстрый бытовой вопрос или короткая правка — здесь обязательные рассуждения только замедлят ответ, разумнее взять модель полегче.
Частые вопросы
Что умеет Claude Fable 5.1? Fable 5.1 умеет держать в контексте документ на миллион токенов, самостоятельно вести многошаговые задачи в терминале и программах без постоянного присмотра человека, доводить до конца автоматизацию рутинных операций и решать научные задачи с несколькими этапами. При этом в широкой эрудиции без инструментов прирост к предыдущей версии минимален.
Для каких задач подходит фейбл 5.1? Для всего, что требует долгой самостоятельной работы: терминальные сценарии, автоматизация цепочки действий, работа в интерфейсах программ, доработка объёмного кода, научные и инженерные расчёты. Именно здесь модель показывает разрыв в разы с предыдущей версией.
Может ли Fable 5.1 работать сама, без присмотра? Да, это заявленное новое умение модели — многочасовые автономные прогоны с сохранением контекста и плана действий. Именно поэтому запрос «claude агент» в поиске всё чаще ведёт на Fable 5.1: бенчмарки на терминал, автоматизацию и работу в программах подтверждают этот прирост числами, а не только формулировками из релиза.
Можно ли отключить рассуждения у Fable 5.1? Нет. У модели нет режима без рассуждений — можно выбрать только глубину: низкую, среднюю или высокую. Из-за этого даже короткий вопрос обрабатывается с задержкой.
Для каких задач модель избыточна? Для простых бытовых вопросов и коротких правок текста. Прирост модели сосредоточен в сложных многошаговых сценариях, а на элементарных вопросах общая эрудиция выросла всего на 1,2 балла — разницы с предыдущей версией здесь почти не заметно, а обязательные рассуждения добавляют задержку без пользы.