
Кратко
- Главное умение Opus 5 — доводить до конца длинную задачу в коде и в интерфейсах программ: на работе внутри программ 70,2% против 55,7% у предыдущей версии.
- Контекст — миллион токенов, знания по май 2026, на входе текст и изображения, на выходе только текст.
- На правках реального кода модель идёт вровень с GPT-6 Astra (74,0% против 74,1%), но тратит на ту же задачу втрое больше шагов и почти втрое больше денег.
- Претензия, которая повторяется у разных пользователей: ответы стали длиннее и многословнее, а мелкую проблему модель склонна лечить как крупную.
Что умеет Claude Opus 5 на самом деле, за вычетом релизных формулировок? Коротко: главный рывок не в общих знаниях, а в самостоятельной работе — модель дольше удерживает план, сама себя перепроверяет и заметно лучше справляется с действиями внутри программ. Разбираем, что умеет opus 5 по бенчмаркам и на практике, а не по формулировкам из релиза, — включая то, за что модель критикуют. Про дату выхода и технические характеристики мы уже писали в материале про релиз Claude Opus 5, здесь только про возможности.
Паспортные данные: контекст, модальности, пределы
Контекстное окно Claude Opus 5 — 1 000 000 токенов, это около полутора тысяч страниц текста в одном разговоре. Максимальная длина ответа — 128 000 токенов, а через пакетный Batch API в бета-режиме можно получить до 300 000. Знания актуальны по май 2026 года. На входе модель принимает текст и изображения, на выходе выдаёт только текст.
Формально паспорт почти совпадает с соседями по линейке — то же окно контекста, тот же предел ответа. Разница начинается там, где кончается таблица характеристик: в том, как модель ведёт себя на длинных самостоятельных прогонах. Anthropic описывает это так: Opus 5 держится в задаче через длинные циклы обращений к инструментам, доделывает многофайловые фичи и рефакторинги без заглушек и плейсхолдеров, а в многоагентных сценариях реже затирает работу параллельных исполнителей.
Главное умение: работа в программах и длинный код
Нагляднее всего прирост виден там, где модель действует, а не рассуждает. На OSWorld 2.0 в обычном режиме, где нужно самостоятельно выполнять задачи в реальных программах — открывать файлы, кликать по интерфейсу, переключаться между окнами, — Opus 5 набирает 70,2% против 55,7% у Opus 4.8. У того же теста есть и строгий режим, где планка выше и цифры у всех моделей заметно ниже: там у Opus 5 39,6%. На Frontier-Bench v0.1, наборе особенно трудных задач, разрыв больше чем двукратный: 43,3% против 18,7%. На правках в реальных кодовых базах DeepSWE v1.1 — 74,0% против 59,0%.
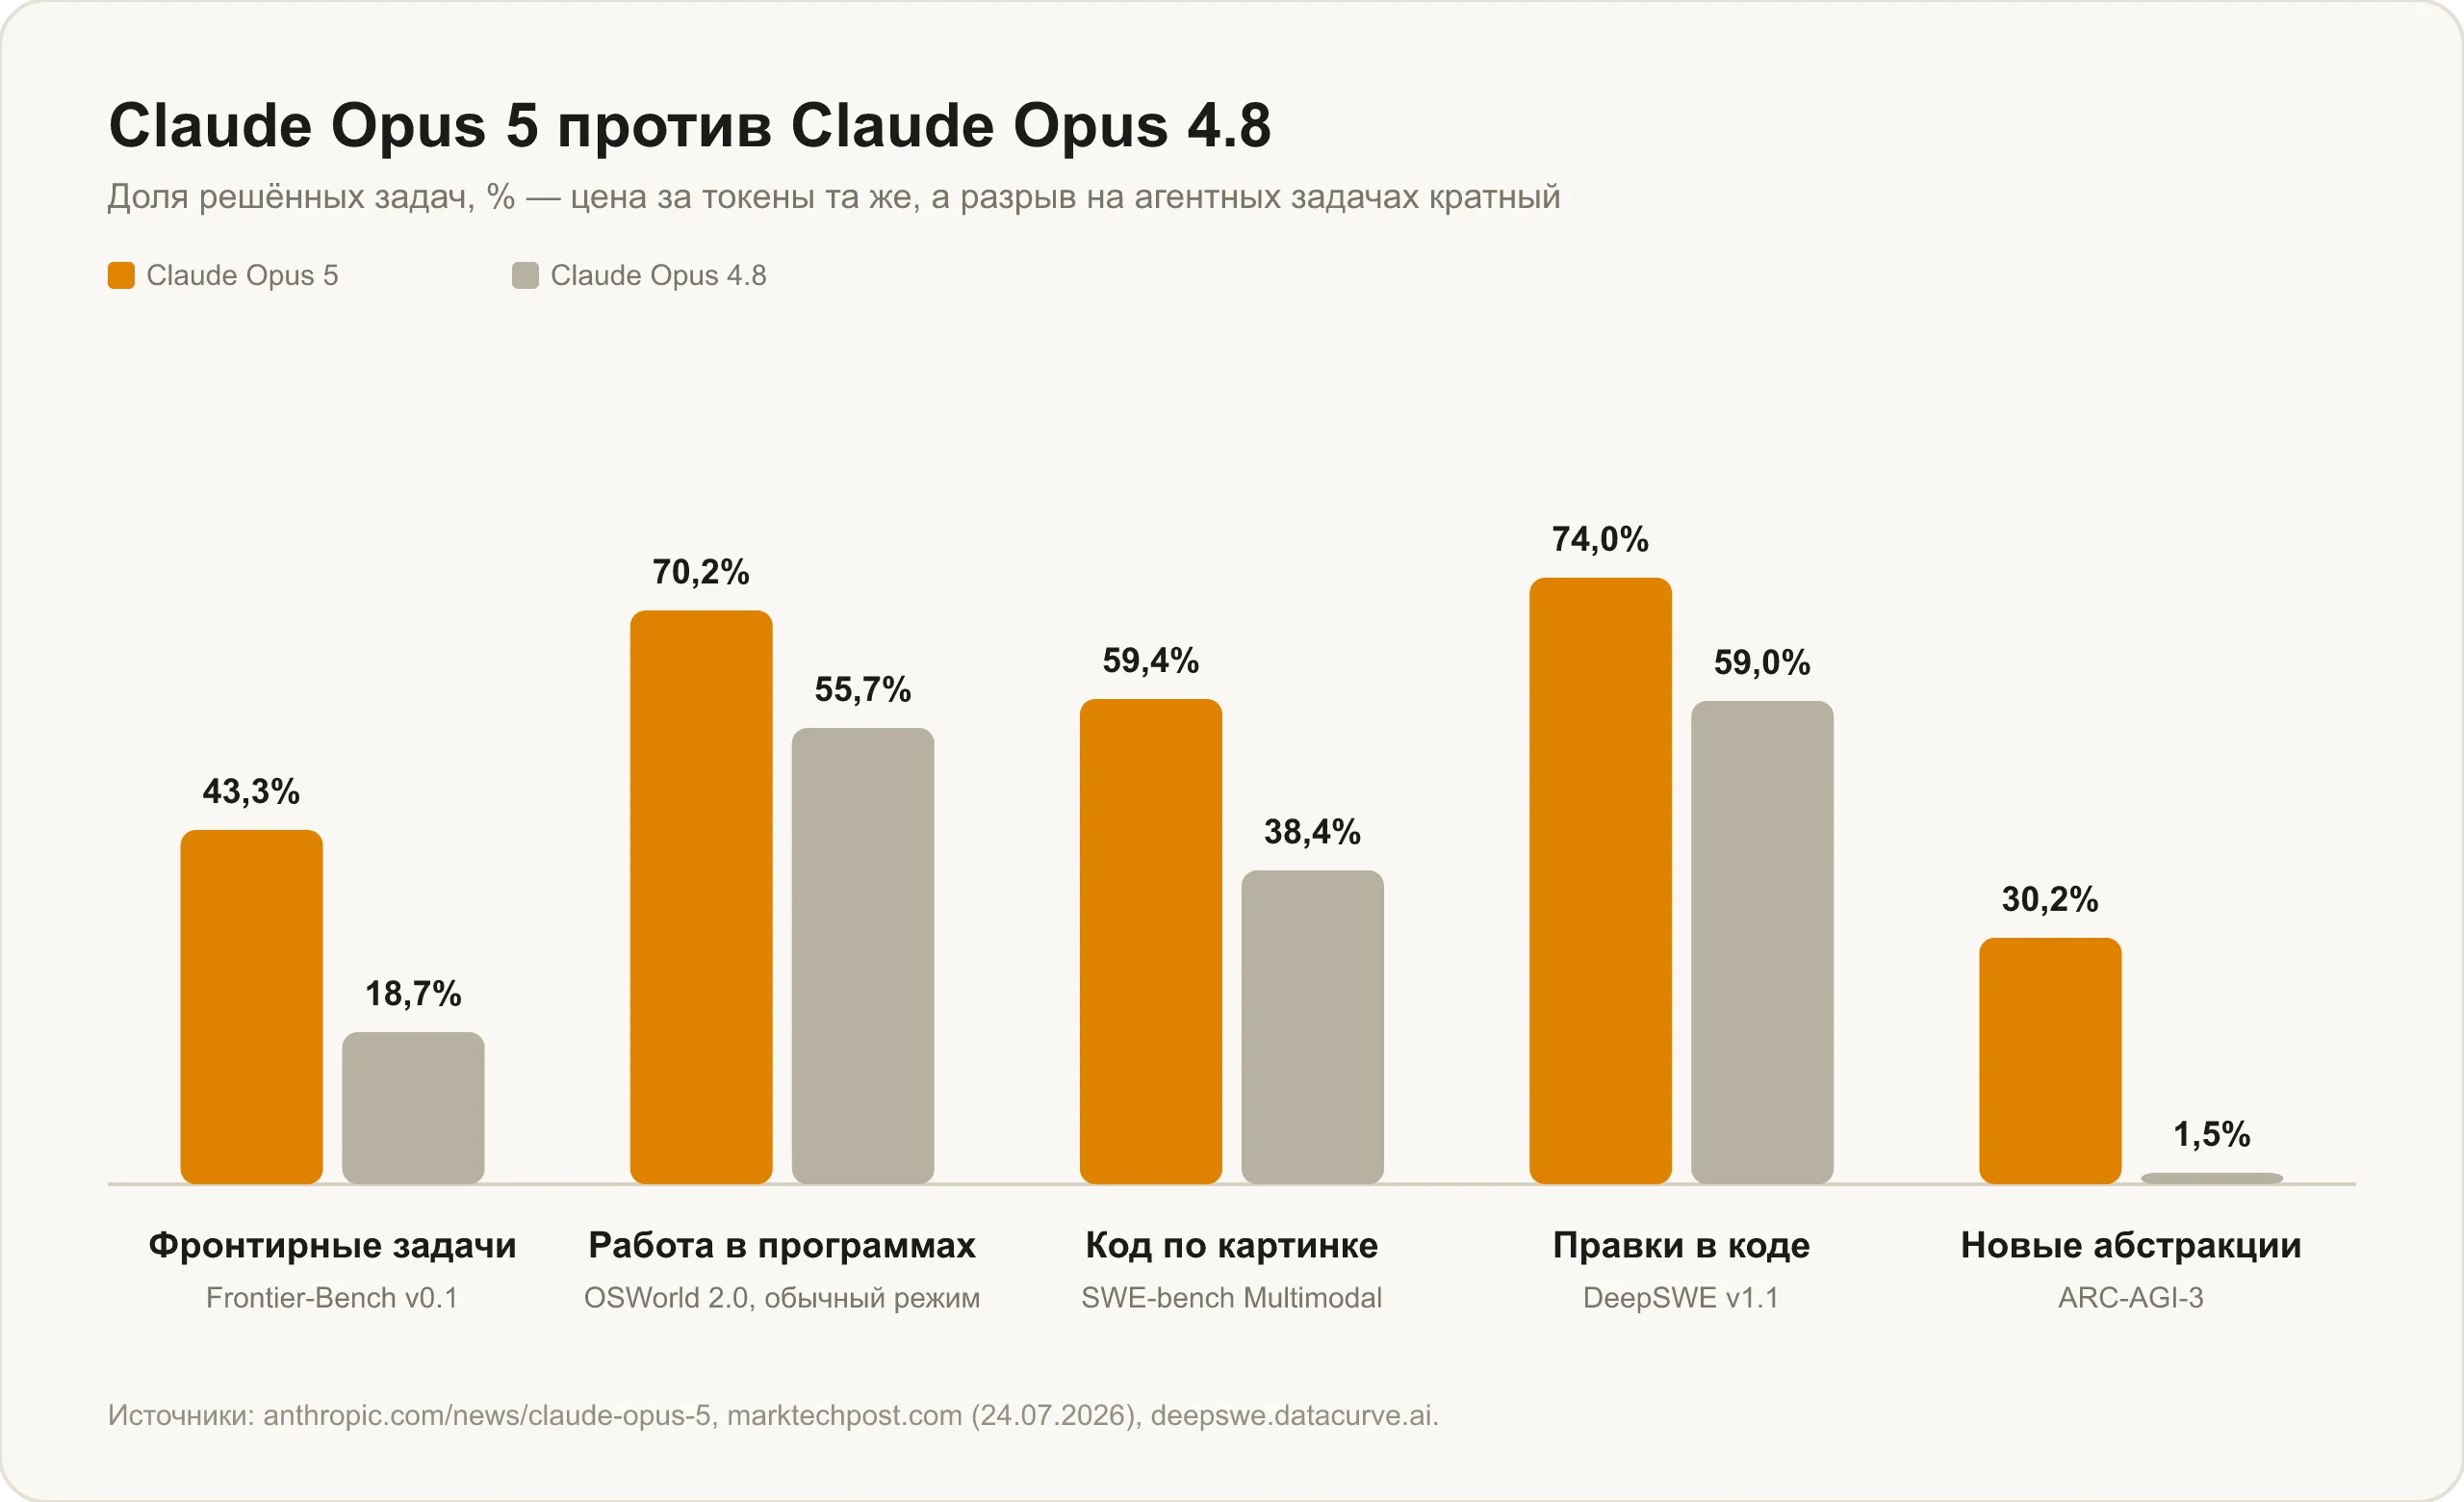
Отдельно стоит вынести работу с изображениями. Opus 5 разбирает графики, схемы, сканы документов и умеет воспроизводить фронтенд по скриншоту: на SWE-bench Multimodal, где код нужно написать по картинке, результат 59,4% против 38,4% у предыдущей версии. Anthropic уточняет, что лучше всего это работает в связке с инструментами, которые позволяют модели самой кропнуть картинку и перепроверить результат, — то есть опять в агентном режиме, а не одним запросом.
Два результата из релиза, которые чаще всего цитируют: 96,0% на SWE-bench Verified и золото Международной математической олимпиады 2026 года с идеальным счётом 42 из 42, без агентской обвязки и внешних инструментов. Первую цифру Anthropic заявила сама, но независимая лаборатория Vals AI намерила на своём стенде 97,00% и поставила модель второй из 59 в собственном сводном индексе (Vals AI). Там же у Opus 5 первое место по пониманию изображений и документов — 89,88% на MMMU.
Правки в коде: место в общем зачёте
Внутри собственной линейки разрыв выглядит убедительно, а вот на общем поле картина скромнее. DeepSWE v1.1 — независимый тест на правки в реальных репозиториях, специально собранный так, чтобы модель не могла подсмотреть эталонное решение (DeepSWE). На нём Opus 5 даёт 74,0% — практически вровень с GPT-6 Astra (74,1%) и чуть ниже лидера Muse Spark 1.3 (75,4%).
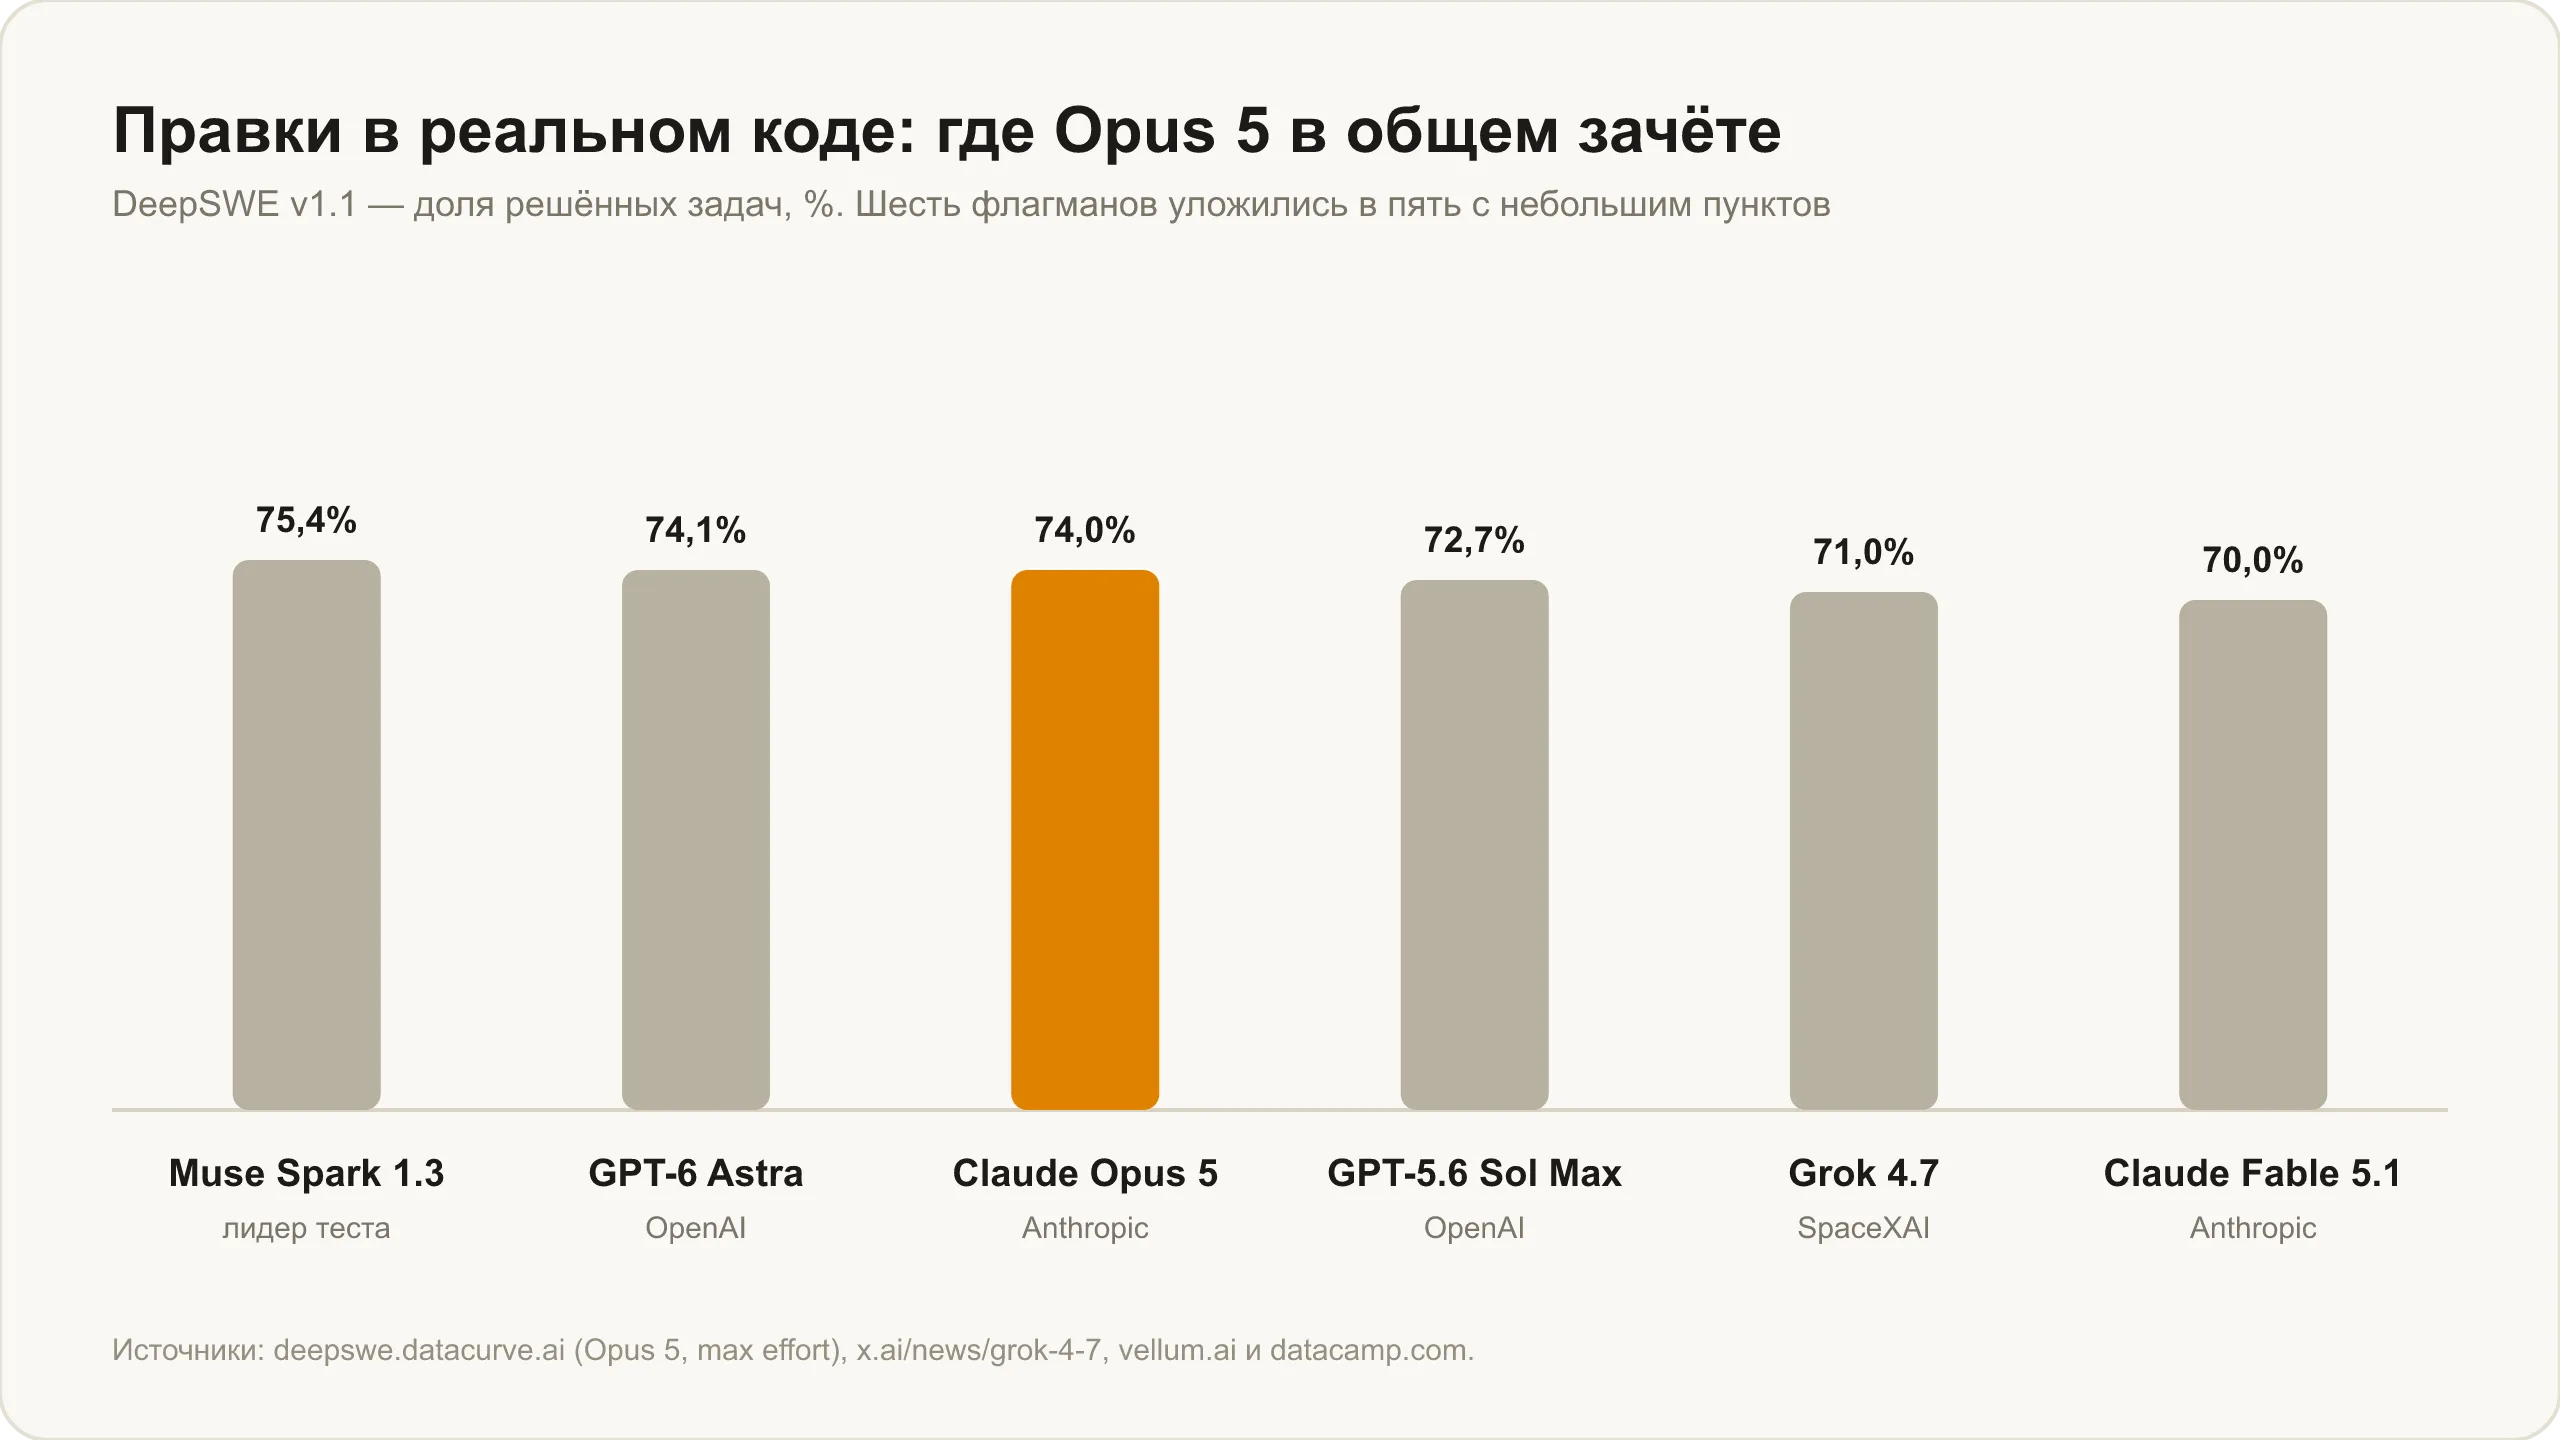
Шесть современных флагманов уложились в пять с небольшим процентных пунктов. Вывод отсюда неудобный: выбирать модель под код по проценту из одного бенчмарка бессмысленно, разница легко перекрывается качеством промпта или особенностями конкретного проекта. Тем, кто выбирает именно под разработку, полезно свериться с более широким разбором — какая нейросеть лучше пишет код в разных сценариях, от чат-ассистентов до IDE-агентов.
Цена вопроса: одинаковый результат, разный счёт
У этого паритета есть неприятная изнанка, и о ней стоит знать до того, как считать бюджет. В том же прогоне DeepSWE Opus 5 добирается до своих 74% за 118 тысяч выходных токенов и 99 шагов, тогда как GPT-6 Astra берёт тот же результат за 30 тысяч токенов и 29 шагов. В деньгах это $11,84 за задачу против $4,43. Для масштаба: Claude Fable 5.1 на том же прогоне стоит ещё дороже — $13,41 при 70,0% решённых задач.
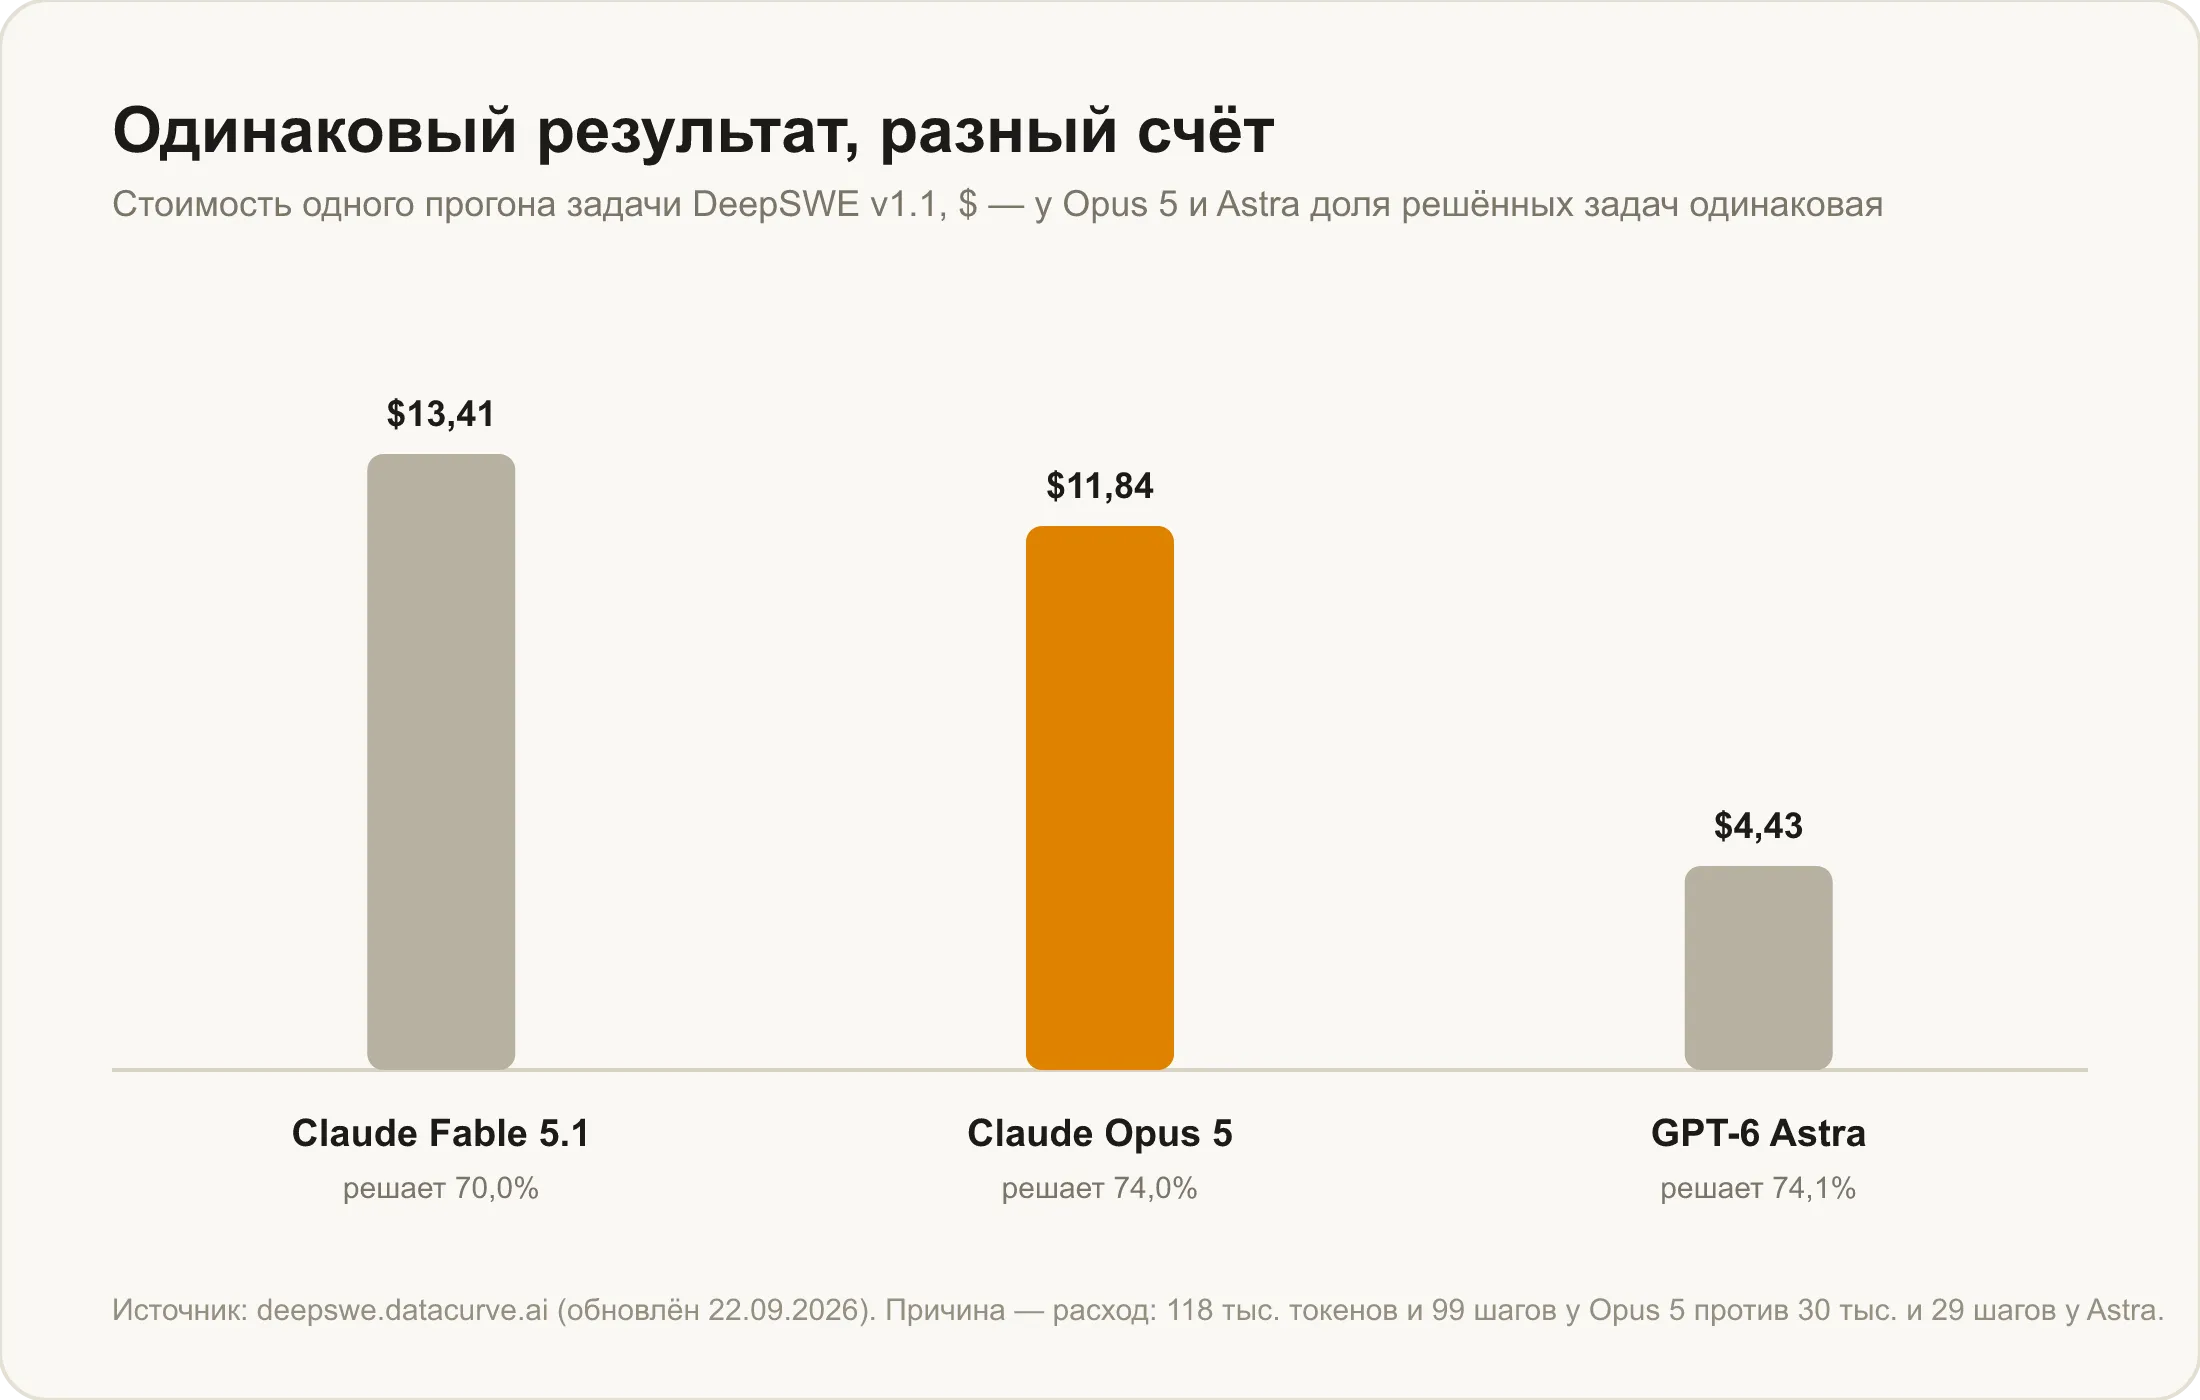
Причина в характере модели: рассуждения включены по умолчанию, токены размышления тарифицируются как выходные, а сама Opus 5 склонна к самопроверке и повторным заходам. Это одновременно её сила на сложных задачах и её главный минус на простых. Практический вывод простой: дешёвый прайс за миллион токенов у Opus 5 не означает дешёвую задачу, и на коротких сценариях низкие уровни рассуждений экономят заметно больше, чем кажется.
Где Opus 5 не выигрывает
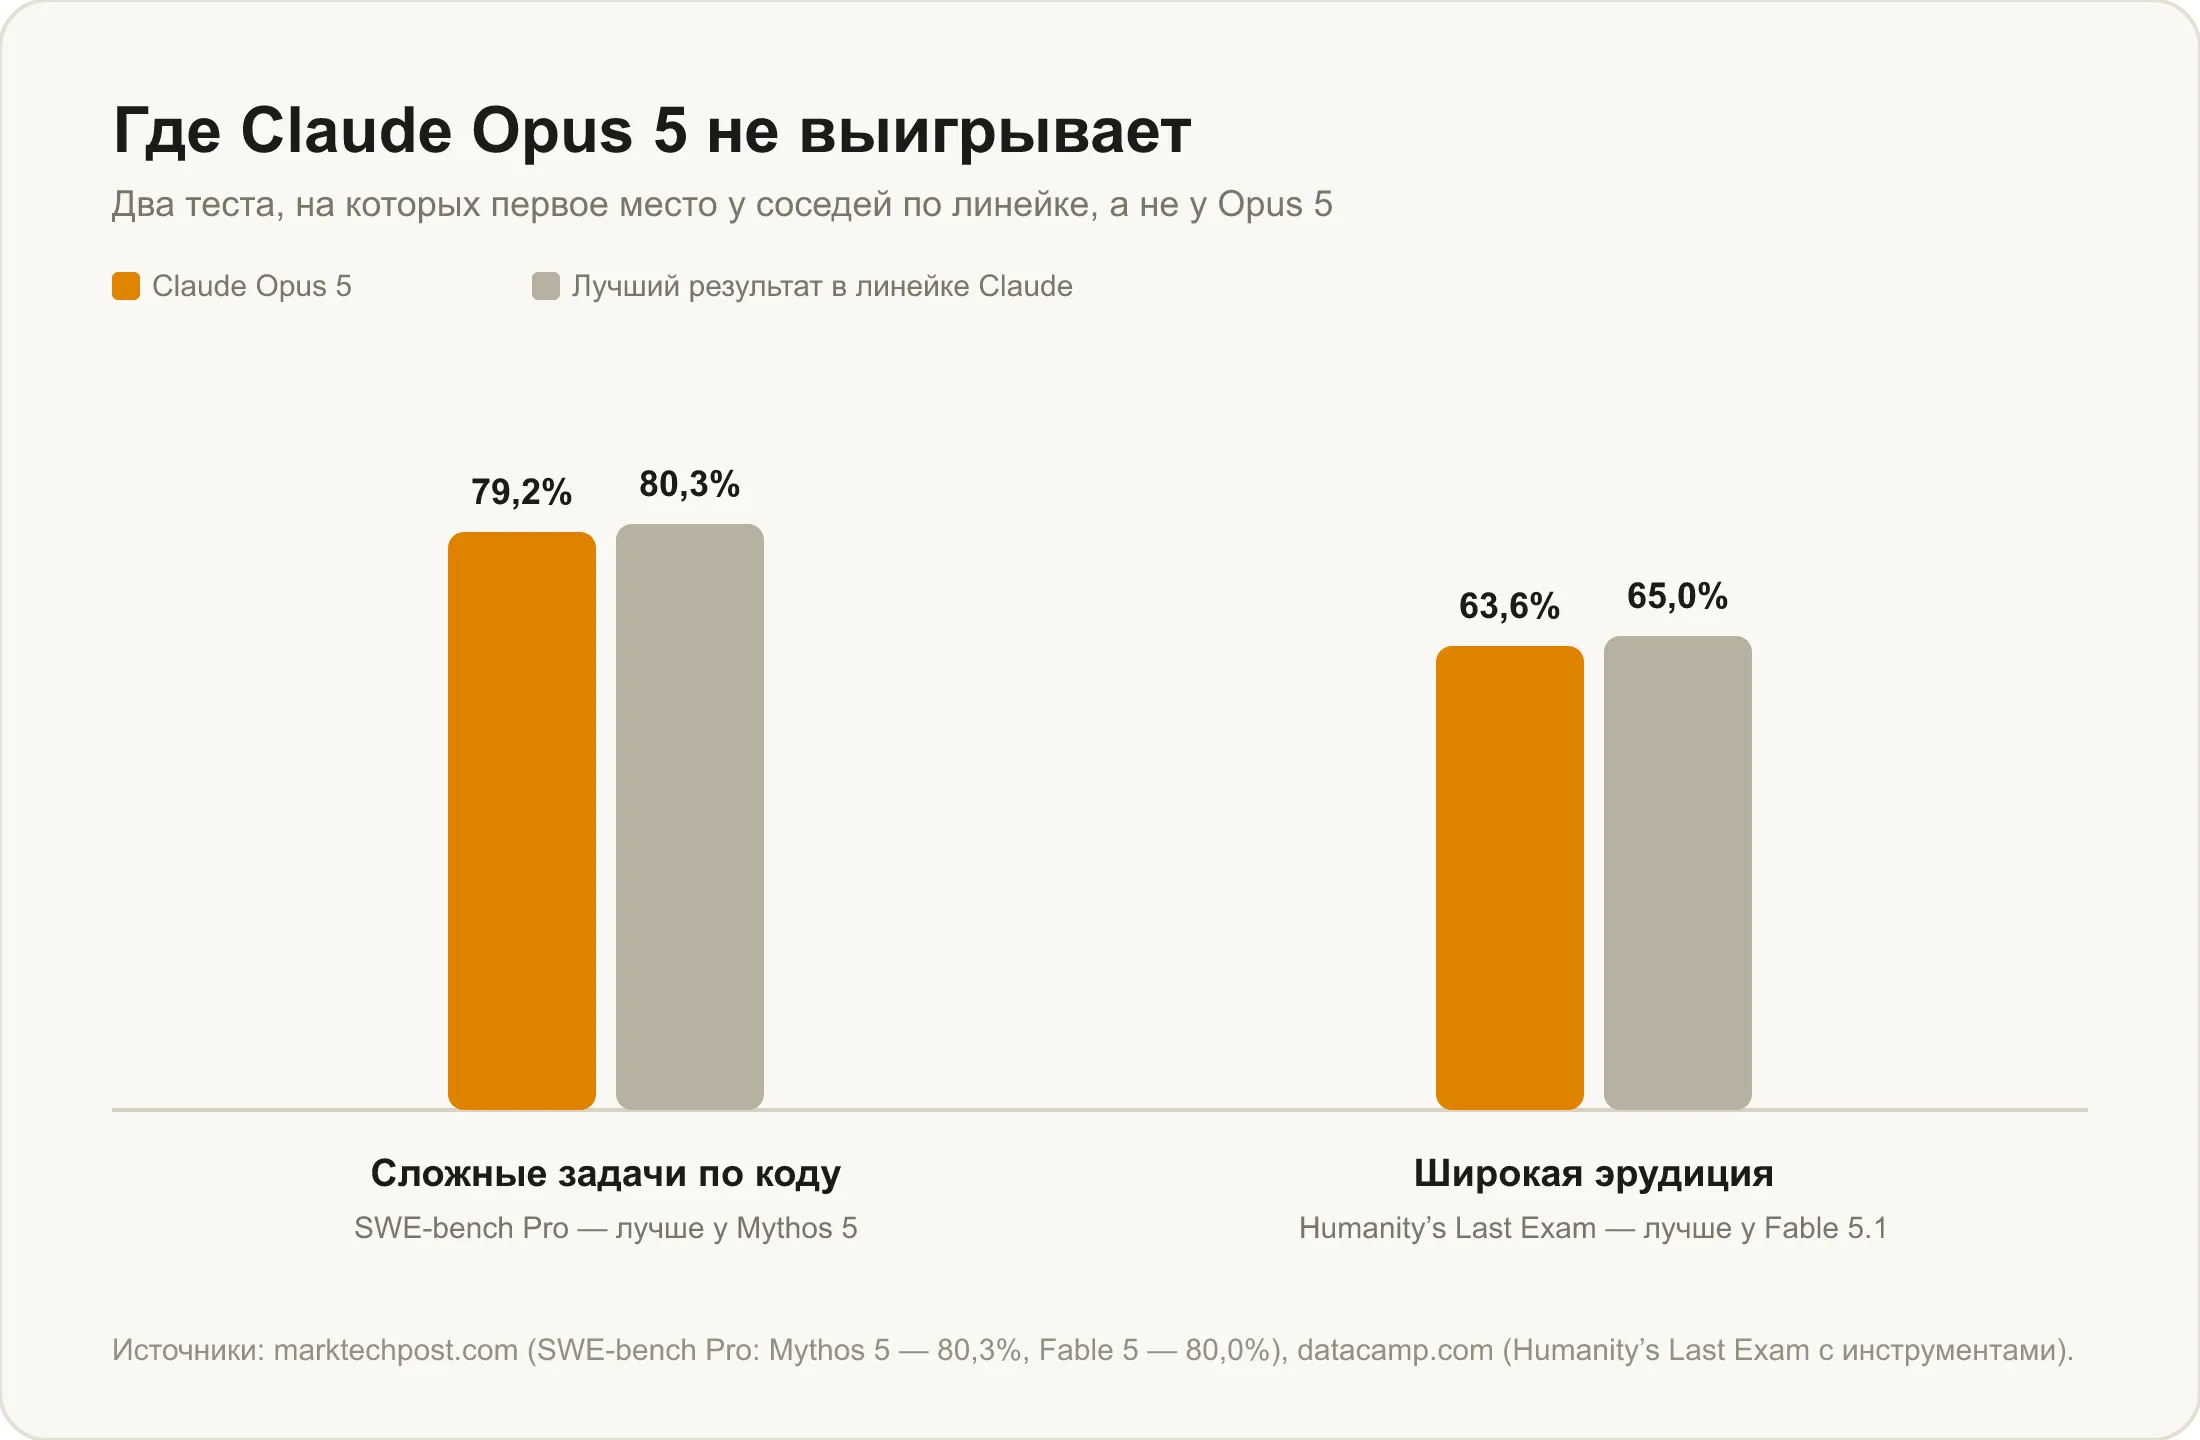
На SWE-bench Pro, более трудной версии теста на код, у Opus 5 79,2% — и это третье место внутри собственной линейки Anthropic: у Claude Fable 5 там 80,0%, у Claude Mythos 5 — 80,3%. В широкой эрудиции с инструментами (Humanity's Last Exam) Opus 5 набирает 63,6% против 65,0% у вышедшей позже Fable 5.1.
Третье слабое место — кибербезопасность. Уязвимости Opus 5 находит наравне с соседями, но заметно хуже превращает найденное в рабочий эксплойт; в независимом рейтинге Vals AI по кибертестам модель пятая из семи. И четвёртое, менее очевидное: на некоторых тестах по коду пик у Opus 5 приходится на средний уровень рассуждений, а на более высоком результат проседает. То есть «думать больше» здесь не всегда означает «отвечать лучше», и выкручивать max на автомате не стоит.
За что модель ругают
Вокруг Opus 5 есть и второй сюжет: впечатления от повседневной работы, которые заметно расходятся с релизными графиками.
Самая частая претензия — многословность. Ответы стали длиннее (это, кстати, официально заявленное изменение поведения), и часть пользователей считает их из-за этого рассеянными и утомительными: модель отвечает не на заданный вопрос, а на весь контекст вокруг него. Вторая претензия касается кода: разработчики жалуются, что Opus 5 относится к мелкой проблеме как к критической и предлагает переписать полпроекта там, где хватило бы пары строк. Третья — модель охотно спорит с формулировкой задачи, и разговор превращается в отработку её возражений. Часть разработчиков после этого вернулась на Opus 4.8.
Читать это стоит с оговоркой: жалобы собраны блог-агрегаторами по обсуждениям в соцсетях, а не системным опросом, и доля недовольных нигде не посчитана. Общее впечатление сообщества хорошо ложится в одну фразу: лучшая модель из тех, что многие пробовали, и одновременно та, с которой им меньше всего приятно работать. Отсюда и рабочий совет: под Opus 5 промпт стоит формулировать жёстче, чем под предыдущую версию, и убрать из него унаследованные просьбы «перепроверь результат в конце» — модель делает это сама, а лишняя инструкция раздувает ответ.
Для каких задач Opus 5 подходит, а для каких избыточна
Из бенчмарков и жалоб складывается довольно чёткая картина применимости. Opus 5 стоит брать под задачи, где решение растягивается на много шагов и требует удержания плана без постоянного участия человека: многофайловый рефакторинг, доработка объёмного кода, самостоятельные действия в интерфейсах программ, разбор документов с графиками и таблицами, многолистовые таблицы со сложными формулами. Такие сценарии и имеют в виду, когда называют Opus 5 нейросетью для агентов, хотя формально это универсальный чат-ассистент.
А вот для короткого бытового вопроса, разовой правки текста или простого уточнения модель избыточна, и дело не только в скорости. Рассуждения включены по умолчанию, ответ приходит с задержкой, а склонность к развёрнутым формулировкам на простом запросе работает против читателя. Для таких сценариев разумнее взять модель полегче — благо в одном чате их можно переключать без потери контекста разговора.
Как попробовать Claude Opus 5 в Veruna AI
Claude Opus 5 добавлена в каталог моделей Veruna AI и открыта на подписке Max — актуальные условия смотрите на странице тарифов. Без VPN, оплата в рублях: подключение к модели устроено так же, как и к остальным в каталоге. Про сам процесс доступа из России мы подробно разбирали в статье как пользоваться Claude Opus 5.
Платформа полезна прежде всего самим форматом: модели переключаются в одном окне. Тяжёлую Opus 5 логично брать под многошаговую самостоятельную задачу, а на короткий вопрос — переключаться на модель полегче, не открывая для этого второй сервис. Если же нужен потолок качества, а не оптимальная цена, рядом в каталоге есть более свежий флагман Anthropic, и мы сравнили эти две модели отдельно — Claude Opus 5 против Claude Fable 5.1.
Короткие сценарии
Многофайловый рефакторинг или доработка большой кодовой базы. Заявленная сильная сторона модели: длинные циклы работы с инструментами и результат без заглушек вместо кода.
Работа внутри программ и интерфейсов — область, где прирост к прошлой версии самый большой: 70,2% против 55,7% в обычном режиме OSWorld 2.0.
Разбор документа с графиками, схемами или скриншотом интерфейса. Вход мультимодальный, а по пониманию изображений и документов модель первая в независимом индексе Vals AI.
Быстрый бытовой вопрос или короткая правка. Здесь включённые по умолчанию рассуждения только замедлят ответ и раздуют его, разумнее взять модель полегче.
Частые вопросы
Что умеет Claude Opus 5? Opus 5 умеет держать в контексте документ на миллион токенов, самостоятельно вести многошаговые задачи в коде и в интерфейсах программ, доводить до конца многофайловый рефакторинг, разбирать графики и сканы документов и собирать многолистовые таблицы со сложными формулами. На входе модель принимает текст и изображения, на выходе выдаёт только текст.
Для каких задач подходит клод опус 5? Для всего, что требует долгой самостоятельной работы: доработка объёмного кода, действия в интерфейсах программ, разбор документов с графиками, офисные задачи с таблицами и презентациями. Именно здесь модель показывает наибольший разрыв с предыдущей версией.
Правда ли Opus 5 лучше всех пишет код? Нет. На независимом тесте DeepSWE v1.1 у неё 74,0% — практически вровень с GPT-6 Astra (74,1%) и ниже Muse Spark 1.3 (75,4%). А на более трудном SWE-bench Pro её обходят собственные соседи по линейке. Шесть флагманов укладываются в пять с небольшим процентных пунктов, и выбирать разумнее по цене и поведению на своём проекте.
Можно ли отключить рассуждения у Opus 5? Да, но не на всех уровнях. Глубина задаётся пятью уровнями — low, medium, high, xhigh и max, по умолчанию стоит high. Полностью выключить размышления можно только на уровне high и ниже; с xhigh или max запрос вернёт ошибку.
Для каких задач модель избыточна? Для простых бытовых вопросов и коротких правок текста. Рассуждения включены по умолчанию и добавляют задержку, а ответы у Opus 5 заметно длиннее, чем у предыдущей версии, — на элементарном запросе это работает против читателя.