
Кратко
- Главное умение Grok 4.7 — доводить до конца долгие задачи в коде: на SWE-Marathon v1.1 она набирает 46,0% против 31,9% у Grok 4.6.
- Контекст 500 000 токенов, вход текстом и изображениями, выход только текстом, знания примерно по май-июнь 2026 года.
- Модель заметно сильнее в узких профессиональных сценариях — инженерных расчётах и юридических агентных задачах, где обходит флагманы OpenAI и Anthropic.
- Слабое место — работа в терминале: официальные 38,0% превращаются в ~26% при независимом замере без фирменной обвязки.
Grok нейросеть что умеет — и что нового в версии 4.7 по сравнению с 4.6? Коротко: рывок произошёл не в эрудиции, а в выносливости. Модель дольше думает, чаще перепроверяет собственные шаги и лучше держит план на задачах, которые решаются часами. Разбираем, что умеет grok 4.7 по бенчмаркам и на практике — и отдельно то, где заявленные цифры расходятся с независимыми. Про дату выхода и технические характеристики мы уже писали в материале про релиз Grok 4.7 — здесь только про возможности.
Grok 4.7: паспортные данные
Контекстное окно Grok 4.7 — 500 000 токенов, это около 750 страниц текста в одном разговоре. На входе модель принимает текст и изображения, на выходе выдаёт только текст. Идентификатор в API — grok-4.7, знания актуальны примерно по май-июнь 2026 года. Из инструментов модель умеет вызывать функции, искать в интернете и по ленте X, выполнять код.
Контекст остался ровно таким же, как у Grok 4.6 и Grok 4.5, — 500 тысяч токенов третий релиз подряд. Поэтому вопрос «что нового в Grok 4.7» упирается не в характеристики: они не поменялись. Изменилось поведение модели внутри того же окна — и это как раз то, что не видно в таблице параметров.
Ещё одна деталь: рассуждения у Grok 4.7 отключить нельзя. В API есть четыре уровня глубины — low, medium, high и xhigh, по умолчанию включён high. Модель всегда думает перед ответом, вопрос только в том, сколько.
Главный рывок: долгие задачи и код
SpaceXAI прямо называет цель обновления — задачи, которые решаются много часов. Под них модель и обучали: более длинный цикл обучения с подкреплением на смеси, смещённой в сторону многочасовых сценариев, и отдельный упор на то, чтобы модель проверяла собственную работу.
В цифрах это выглядит так. На SWE-Marathon v1.1, где задача растягивается на десятки шагов, Grok 4.7 даёт 46,0% против 31,9% у предыдущей версии. На правках в реальных кодовых базах (DeepSWE v1.1) — 71,0% против 65,2%. В работе внутри редактора кода (CursorBench 4.0) — 46,3% против 40,4%. В терминале по официальному замеру — 38,0% против 20,3% (SpaceXAI).
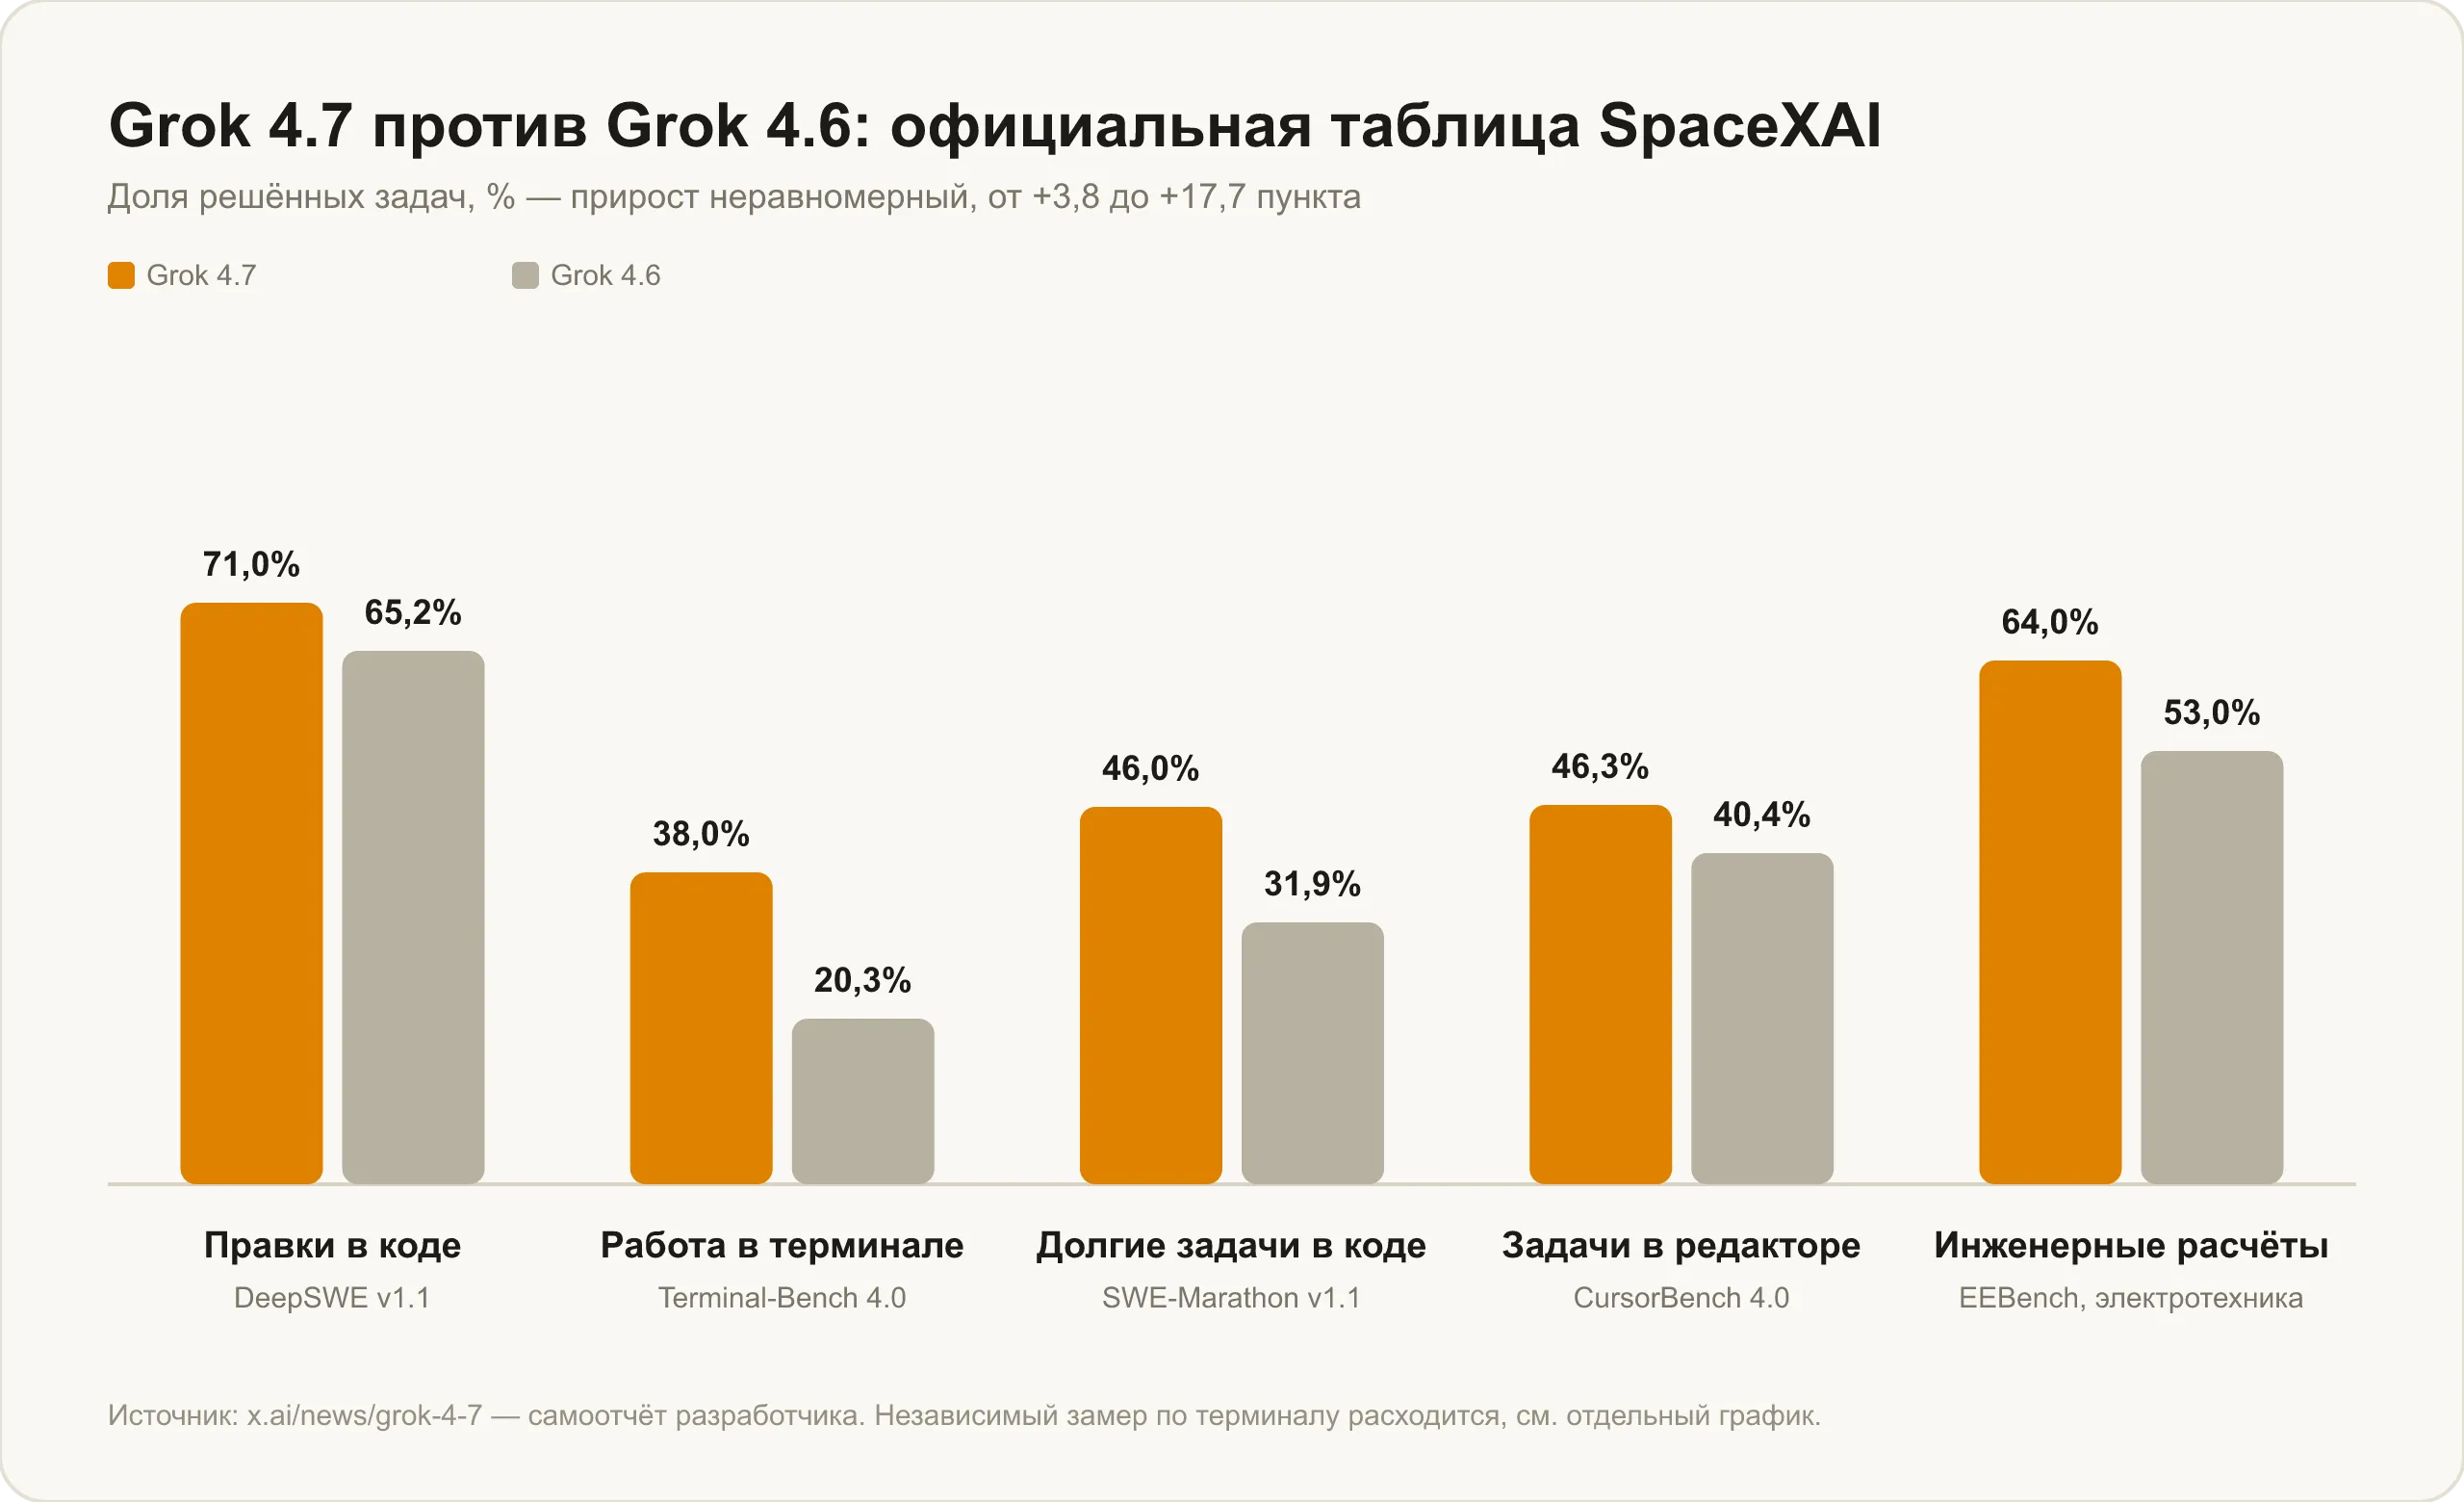
Независимый агрегатор Artificial Analysis подтверждает прирост в кодинге отдельной метрикой: индекс кодинг-агентов у связки Grok 4.7 с агентом Grok Build вырос до 56 с 47 у предыдущей версии — четвёртый результат в мире на момент замера.
Где Grok 4.7 обходит флагманы: узкие профессиональные задачи
Самое интересное в официальной таблице — не код, а два прикладных теста, где модель уверенно опережает и OpenAI, и Anthropic.
Первый — EEBench, задачи по электротехнике. Grok 4.7 решает 64,0% против 56,4% у Claude Fable 5.1 и 39,4% у GPT-5.6 Sol Max. Второй — Harvey Legal Agent, агентные юридические задачи: 19,6% у Grok 4.7 против 6,7% у Fable 5.1 и 2,5% у Sol Max. Проценты сами по себе невысокие — бенчмарк тяжёлый, — но разрыв кратный, а не в пределах погрешности.
Зато в медицине картина обратная. На HealthBench Professional у Grok 4.7 — 56,7%, у Sol Max — 60,5%, у Fable 5.1 — 62,1%. Модель здесь третья, и это хороший пример того, почему «сильнее всех» про любой современный флагман — формулировка неверная в принципе: сила распределена по областям.
Правки в коде: где Grok 4.7 в общем зачёте
DeepSWE v1.1 — один из немногих бенчмарков, по которому опубликованы результаты сразу всех текущих флагманов, поэтому на нём удобно смотреть расстановку сил.
Grok 4.7 набирает 71,0%. Выше неё — Muse Spark 1.3 (75,4%), GPT-6 Astra (74,1%) и GPT-5.6 Sol Max (72,7%); ниже — Claude Fable 5.1 (70,0%). То есть в правках кода все современные флагманы уложились в шесть процентных пунктов, и разрыв между первым и последним меньше, чем принято считать по заголовкам релизов.
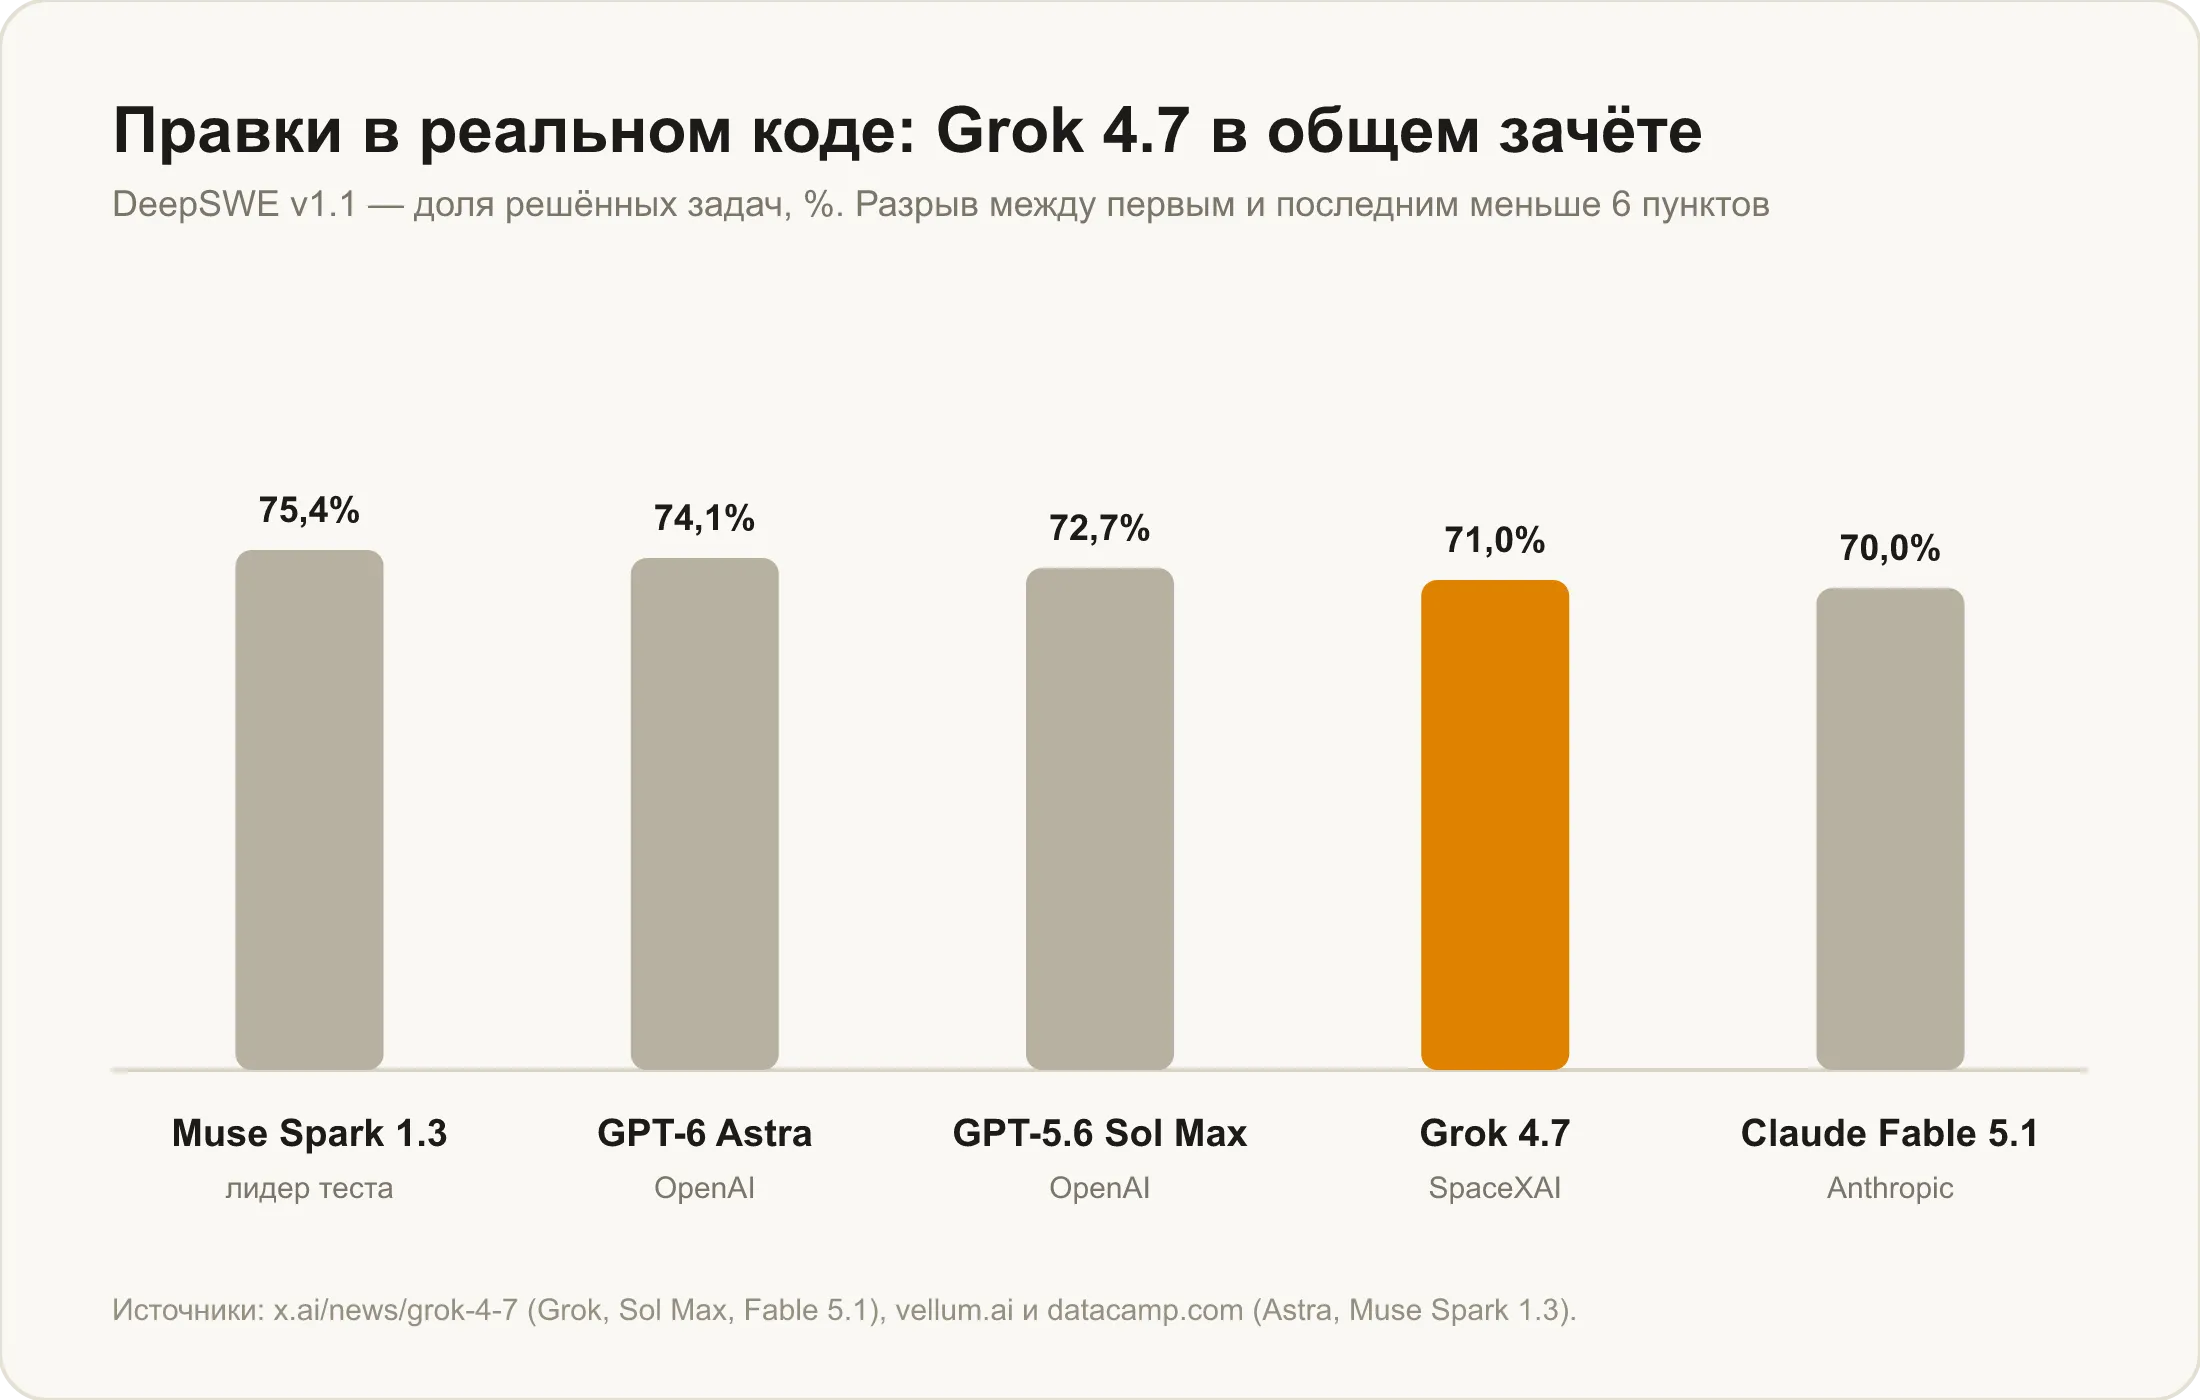
Практический вывод из этой тесноты простой: выбирать модель под код по одному проценту бессмысленно, разумнее смотреть на цену, скорость и то, как она ведёт себя на вашей кодовой базе. Мы отдельно разбирали этот вопрос шире — какая нейросеть лучше пишет код в разных сценариях, от чата до IDE-агента, а прямое сопоставление с флагманом OpenAI вынесли в статью Grok 4.7 против GPT-6 Astra.
Слабое место: терминал и расхождение с независимым замером
Здесь честность важнее эффектной цифры. Официальные 38,0% на Terminal-Bench 4.0 получены с фирменной обвязкой SpaceXAI вокруг модели. Artificial Analysis прогнала тот же тест самостоятельно и получила около 26% для модели без обвязки и 33% — в составе агента Grok Build (Artificial Analysis).
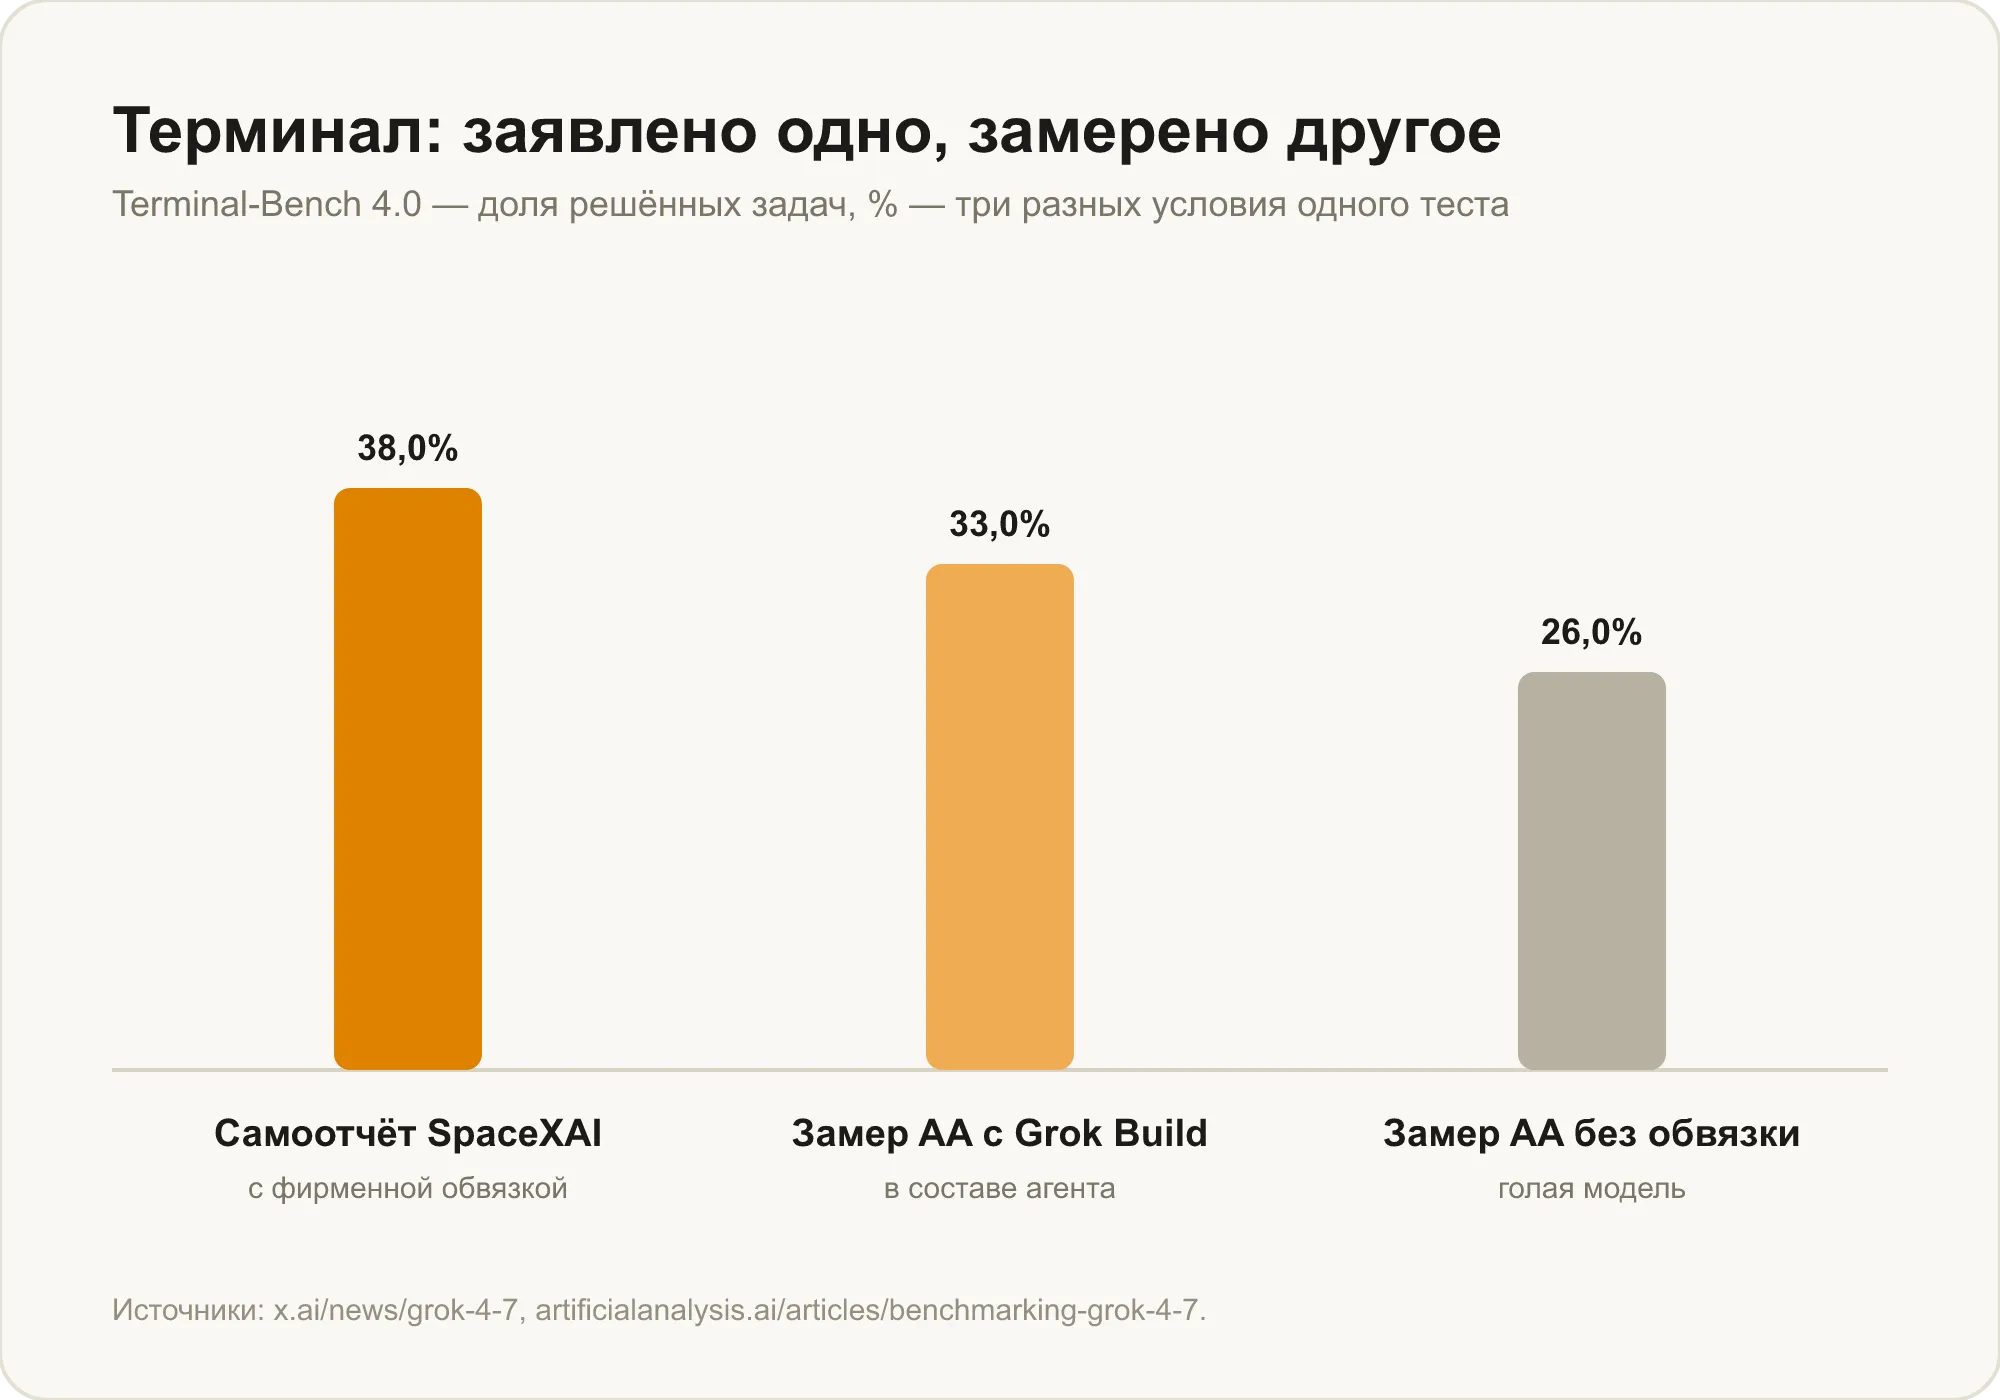
Разница в полтора раза между самоотчётом и сторонним прогоном — не повод объявлять цифры разработчика подделкой: условия замера действительно отличаются. Но пользоваться придётся моделью, а не обвязкой из пресс-релиза, поэтому ориентироваться стоит на нижнюю границу.
Есть и прямые откаты относительно предыдущей версии. По тем же замерам Artificial Analysis, на тесте длинного контекста AA-LCR Grok 4.7 потеряла 3,7 процентного пункта к Grok 4.6, а на автоматизации рутинных операций — 1,1 пункта. Скорость тоже не выросла: 55,3 токена в секунду на уровне рассуждений high против 60,4 у предшественницы. Обновление сделало модель более усидчивой, а не более быстрой.
Отдельно про достоверность ответов. Доля галлюцинаций в тесте AA-Omniscience снизилась с 34% до 29%, но точность при этом чуть просела — 47% против 48%. Проще говоря, модель стала реже выдумывать, но не стала чаще попадать в правильный ответ: она просто чаще отказывается отвечать, когда не уверена. Для рабочих задач это скорее плюс, для вопросов на эрудицию — нейтрально.
Для каких задач Grok 4.7 подходит, а для каких избыточна
Из бенчмарков складывается довольно конкретная картина. Grok 4.7 стоит брать под задачи, где решение растягивается на много шагов и требует, чтобы модель сама держала план: доработка объёмного кода, многочасовые агентные сценарии, инженерные расчёты, юридический разбор с несколькими источниками. В этих сценариях разрыв с предыдущей версией измеряется десятками процентов, а не единицами.
Для короткого бытового вопроса, разовой правки текста или простого уточнения модель избыточна — и дело не только в том, что прирост здесь не проявляется. Рассуждения отключить нельзя, поэтому даже элементарный вопрос обрабатывается с задержкой. Для таких сценариев разумнее взять модель полегче: в одном чате их можно переключать, не теряя контекст разговора.
Медицинские и здоровьесберегающие вопросы — тот случай, когда Grok 4.7 лучше не брать первой: по HealthBench Professional она уступает и OpenAI, и Anthropic. А работу с очень длинными документами стоит проверять на своей задаче: заявленное улучшение управления длинным контекстом независимым замером пока не подтверждается.
Как попробовать Grok 4.7 в Veruna AI
Grok 4.7 добавлена в каталог моделей Veruna AI с пометкой «новинка» и открыта на подписке Pro и выше — актуальные условия смотрите на странице тарифов. Без VPN, оплата в рублях: подключение устроено так же, как и к остальным моделям каталога. Про сам процесс доступа из России подробно — в статье как пользоваться Grok 4.7.
Смысл платформы не в отдельной функции, а в формате: модели переключаются в одном окне. Тяжёлую Grok 4.7 логично брать под многошаговую самостоятельную работу, а на короткий вопрос — переключаться на модель полегче, не открывая второй сервис. Там же рядом лежит предыдущий флагман линейки, Grok 4.5, — удобно, если хочется сравнить два поколения на одной задаче.
Короткие сценарии
Многочасовая задача в коде без пошагового контроля — именно под это обновление и затачивали: разрыв с прошлой версией на SWE-Marathon v1.1 составляет 14 пунктов.
Инженерный расчёт или разбор технической документации — область, где Grok 4.7 обходит и GPT-5.6 Sol Max, и Claude Fable 5.1 с заметным отрывом.
Юридический разбор с несколькими шагами и источниками — на Harvey Legal Agent модель показывает кратное преимущество над конкурентами, хотя абсолютные проценты там у всех низкие.
Быстрый вопрос или короткая правка — здесь обязательные рассуждения только добавят ожидания, разумнее переключиться на модель полегче.
Частые вопросы
Что умеет Grok 4.7? Модель держит в контексте до 500 тысяч токенов, читает изображения, вызывает функции, ищет в интернете и по ленте X, выполняет код. Её сильная сторона — многошаговые задачи в коде и узкие профессиональные сценарии: инженерные расчёты и юридический агентный разбор. Генерации картинок и видео у неё нет, на выходе только текст.
Для каких задач подходит грок 4.7? Для всего, что требует долгой самостоятельной работы: доработка объёмного кода, агентные цепочки на много шагов, инженерные расчёты, разбор документов с несколькими этапами. На коротких разовых запросах преимущество модели не успевает проявиться.
Можно ли отключить рассуждения у Grok 4.7? Нет. Доступны четыре уровня глубины — low, medium, high и xhigh, по умолчанию high, но режима без рассуждений у модели нет. Из-за этого даже короткий вопрос обрабатывается с задержкой.
Правда ли Grok 4.7 лучше всех в коде? Нет. На DeepSWE v1.1 у неё 71,0% — выше Claude Fable 5.1 (70,0%), но ниже GPT-5.6 Sol Max (72,7%), GPT-6 Astra (74,1%) и Muse Spark 1.3 (75,4%). Все современные флагманы уложились в шесть пунктов, явного лидера в правках кода нет.
Где Grok 4.7 слабее предыдущей версии? По независимым замерам Artificial Analysis — в длинном контексте (минус 3,7 пункта к Grok 4.6) и автоматизации рутинных операций (минус 1,1 пункта). Скорость тоже снизилась: 55,3 токена в секунду против 60,4.