
Кратко
- По собственным замерам DeepSeek младшая V4.1 Flash обходит флагманскую V4 Pro почти везде: 74,2% против 62,7% на правках кода, 54,8% против 43,2% на автоматизации рутины.
- При этом V4.1 Flash дешевле вчетверо на входе и втрое с лишним на выходе, а ещё умеет читать изображения, чего V4 Pro не умеет вовсе.
- V4 Pro крупнее втрое — 1,6 трлн параметров против 552 млрд — и держится только в двух тестах на эрудицию.
- Историю про отключение V4 Pro с 14 сентября компания отыграла назад: модель осталась в прайсе и работает.
Обычно сравнение двух моделей одного разработчика — это выбор между «подешевле» и «поумнее». У DeepSeek осенью 2026 года получилось иначе: вышедшая 10 сентября V4.1 Flash по собственным замерам компании обходит флагманскую V4 Pro и стоит при этом кратно дешевле. Запрос «deepseek v4 pro vs flash» сейчас ищут именно из-за этой странности. Разберёмся, насколько всё однозначно и когда старшая модель всё-таки нужнее.
Характеристики: таблица
| Параметр | DeepSeek V4.1 Flash | DeepSeek V4 Pro |
|---|---|---|
| Идентификатор в API | deepseek-flash | deepseek-v4-pro |
| Дата выхода | 10 сентября 2026 | 13 августа 2026 |
| Параметры | 552 млрд в MoE | 1,6 трлн в MoE |
| Активных параметров | 8 млрд на входе, 16 млрд на выходе | 49 млрд |
| Контекстное окно | 1 000 000 токенов | 1 000 000 токенов |
| Максимальный ответ | 384 000 токенов | 384 000 токенов |
| Изображения на входе | да | нет |
| Лимит параллельных запросов | 2500 | 500 |
| Вход, льготные часы | $0,15 за млн токенов | $0,66 за млн токенов |
| Выход, льготные часы | $0,60 за млн токенов | $1,98 за млн токенов |
| Чтение из кэша | $0,003 за млн токенов | $0,022 за млн токенов |
Даты и тарифы здесь и далее — из журнала изменений и прайса API DeepSeek (api-docs.deepseek.com).
Первое, что бросается в глаза: разница в активных параметрах. V4 Pro включает на каждый токен 49 млрд, V4.1 Flash — 8 млрд при чтении промпта и 16 млрд при генерации ответа. Это следствие новой архитектуры Causal Encoder-Decoder, где чтение и письмо разведены по разным половинам модели; подробнее мы разбирали её в статье про релиз V4.1 Flash.
Веса V4.1 Flash выложены открыто под лицензией MIT (HuggingFace); весов V4 Pro DeepSeek не публиковала.
Второе — зрение. V4.1 Flash понимает картинки нативно, у V4 Pro этой возможности нет совсем. Для практики это часто важнее любых процентов в таблице: скриншот ошибки или фотографию документа старшей модели просто не отдашь.
Бенчмарки: где разрыв настоящий
Сравнивать удобно сразу с тремя поколениями — добавим прошлую V4 Flash, чтобы видеть темп.
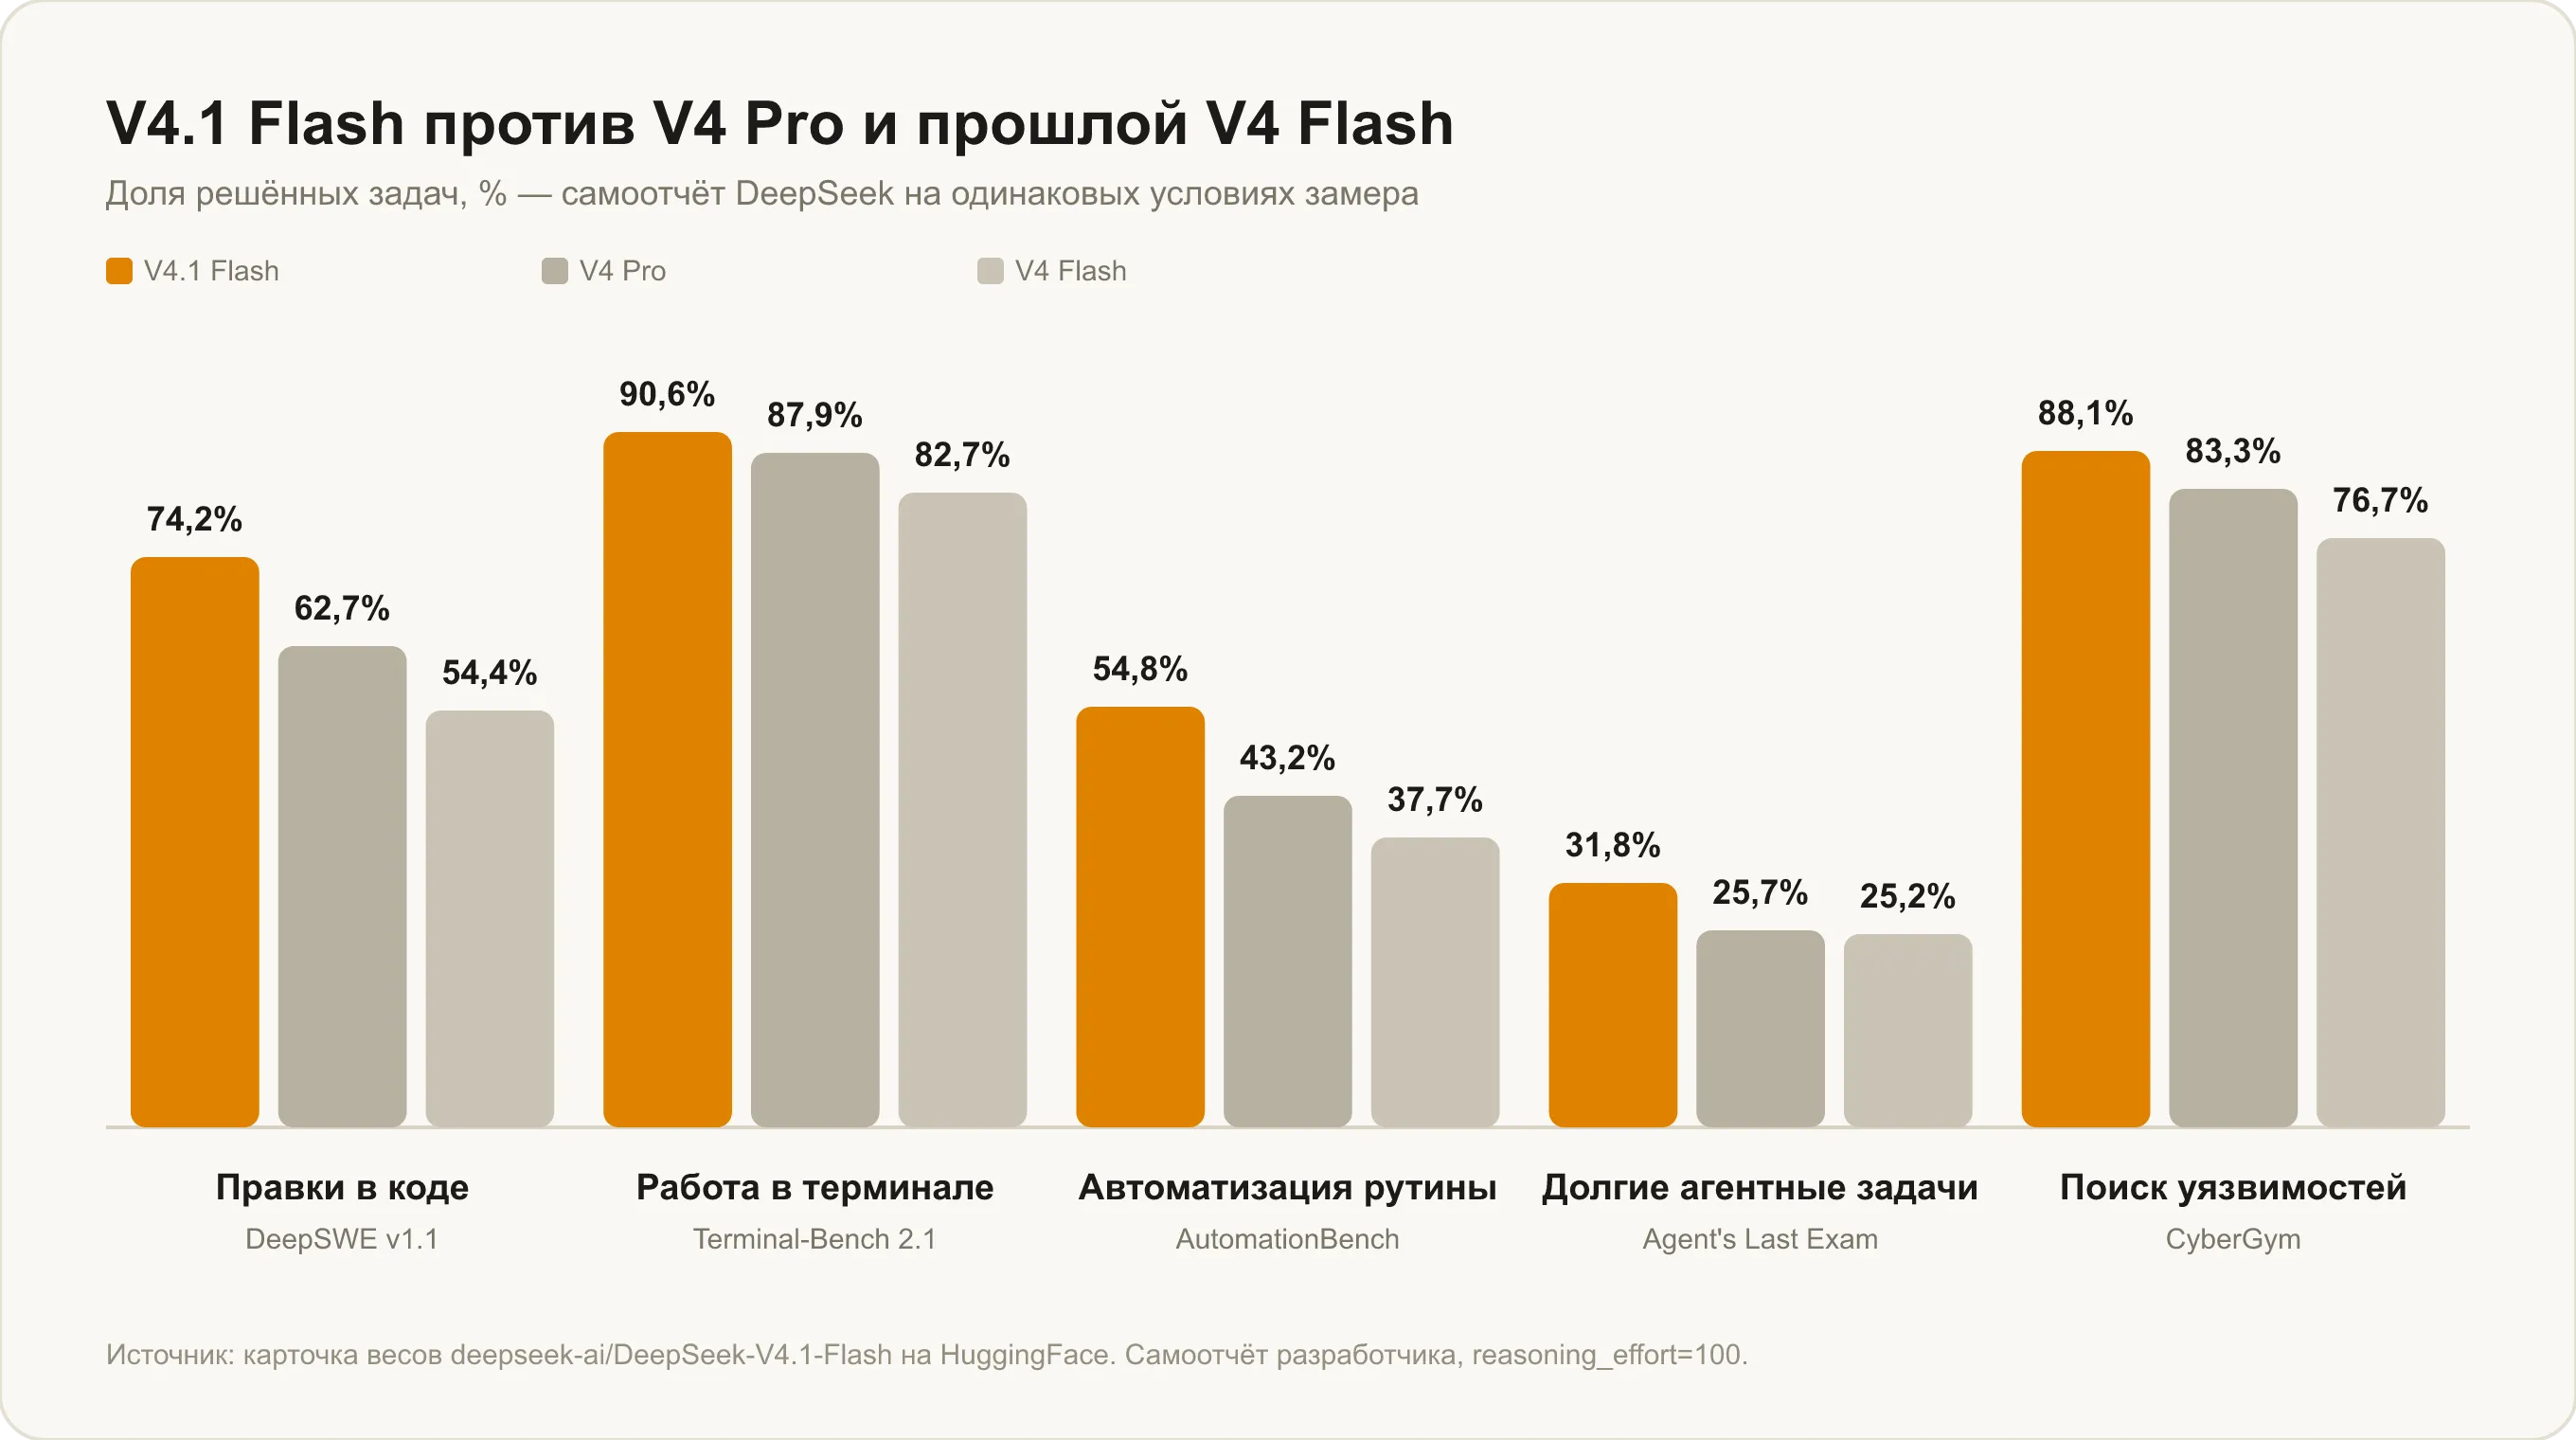
Правки в реальных кодовых базах (DeepSWE v1.1): 74,2% у V4.1 Flash против 62,7% у V4 Pro и 54,4% у прошлой V4 Flash. Автоматизация рутинных операций (AutomationBench): 54,8% против 43,2% и 37,7%. Долгие агентные задачи (Agent's Last Exam): 31,8% против 25,7% и 25,2%. Поиск уязвимостей (CyberGym): 88,1% против 83,3% и 76,7%. Работа в терминале (Terminal-Bench 2.1): 90,6% против 87,9% и 82,7% (карточка весов DeepSeek).
Картина ровная: во всех агентных и кодовых сценариях младшая модель впереди старшей, а разрыв с собственной предшественницей ещё заметнее. Отдельно стоит отметить Codeforces — рейтинг 3471 у V4.1 Flash против 3348 у V4 Pro, — и MathArena Apex, где модели практически сравнялись: 65,6% против 65,3%.
Где V4 Pro всё ещё впереди
Таких мест два, и оба — про знания, а не про работу.
На GPQA Diamond, где задачи уровня аспирантуры по химии, биологии и физике, у V4 Pro 92,4% против 90,9% у V4.1 Flash. На текстовой части Humanity's Last Exam — теста на широкую эрудицию — 42,7% против 39,1%. Разрывы небольшие, но систематические: там, где нужно много знать, помогает размер, и 1,6 трлн параметров дают о себе знать.
Практический вывод из этого: если задача — «объясни сложное из узкой области» или «ответь на вопрос, где важна точность факта», у старшей модели есть аргумент. Если задача — «разберись в моём коде» или «пройди цепочку шагов», аргументов у неё не остаётся.
Деньги: разрыв больше, чем в качестве
Тут всё однозначно. В льготные часы V4.1 Flash стоит $0,15 за миллион входных токенов и $0,60 за выходные. У V4 Pro те же объёмы — $0,66 и $1,98.
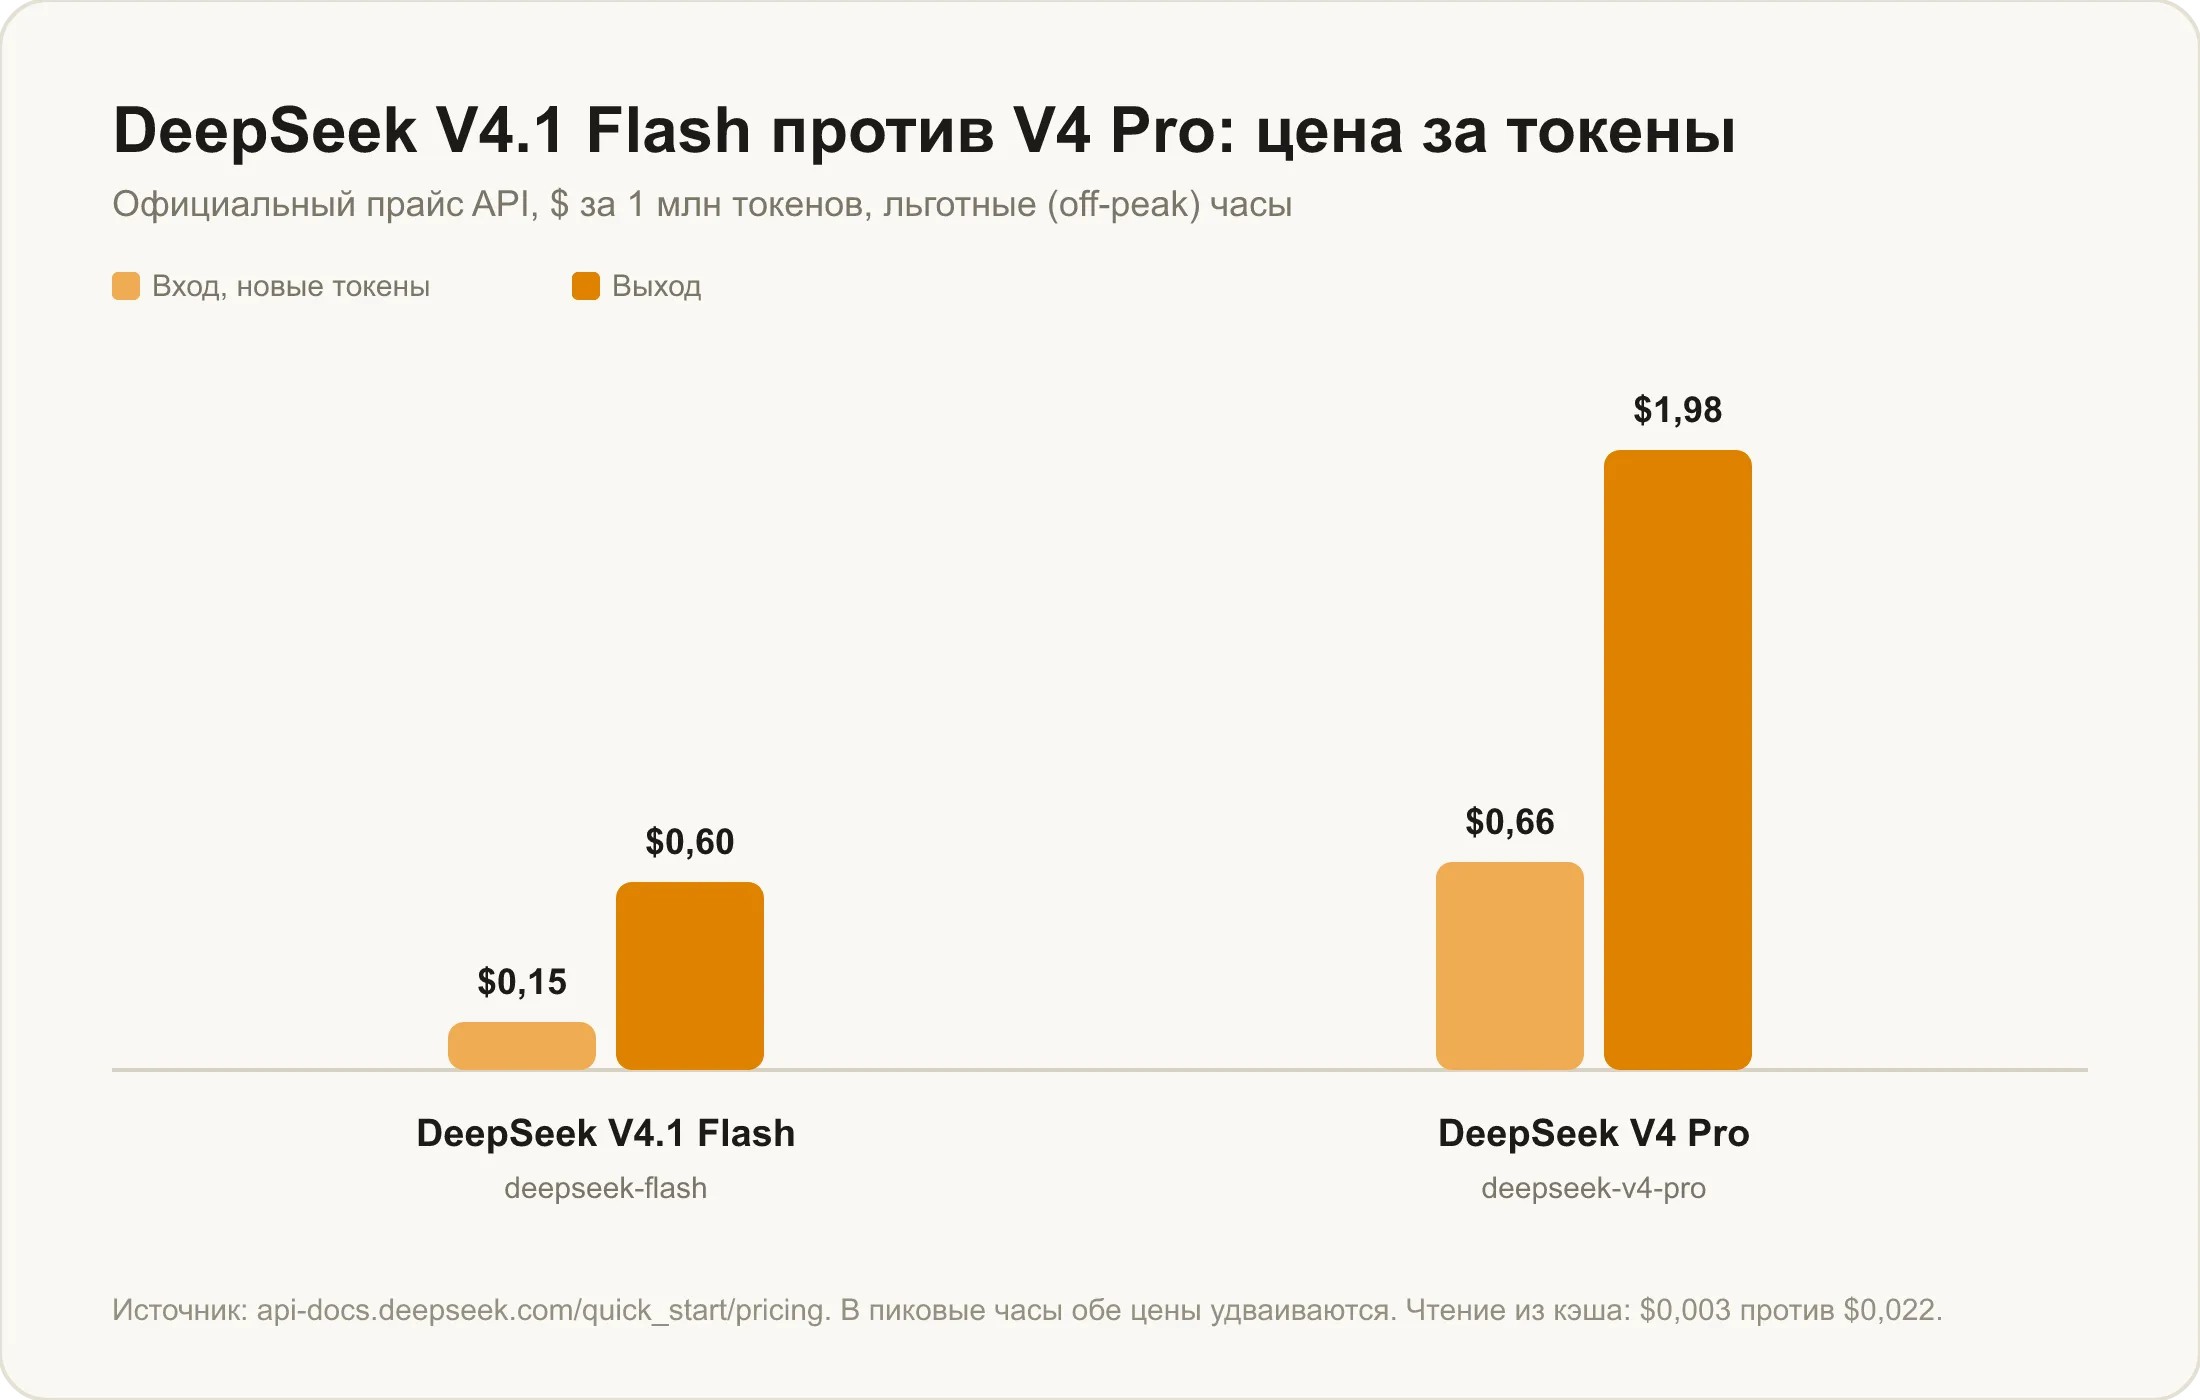
Разница — в 4,4 раза на входе и в 3,3 раза на выходе. На чтении из кэша разрыв ещё больше: $0,003 против $0,022, то есть более чем в семь раз. В пиковые часы обе цены удваиваются, но соотношение между моделями не меняется.
Пиковые часы, к слову, занимают меньшую часть недели: 01
–04 и 06–10 UTC с понедельника по пятницу, то есть примерно 04–07 и 09–13 по Москве. Выходные целиком идут по льготному тарифу.Одна поправка к арифметике: дешёвый токен не означает дешёвую задачу. По замеру Artificial Analysis на прогоне сводного индекса V4.1 Flash выдала 250 млн выходных токенов при медиане 140 млн у сопоставимых моделей (Artificial Analysis). Модель многословна, и часть выигрыша уходит на объём ответов. С похожим эффектом мы разбирались в сравнении Grok 4.7 и GPT-6 Astra — там дешёвая модель тоже оказалась дороже, чем выглядела по прайсу.
Оговорка, без которой сравнение неполное
Все цифры бенчмарков выше опубликовала сама DeepSeek в карточке весов на HuggingFace, включая результаты чужих моделей. Независимых прогонов, где обе модели сравнивались бы в одинаковых условиях сторонней командой, на момент публикации практически нет.
Компания при этом поступила непривычно откровенно: она сама показала, насколько результат зависит от обвязки. Один и тот же DeepSWE v1.1 на одной и той же V4.1 Flash дал от 74,2% до 65,5% на восьми разных агентных каркасах.
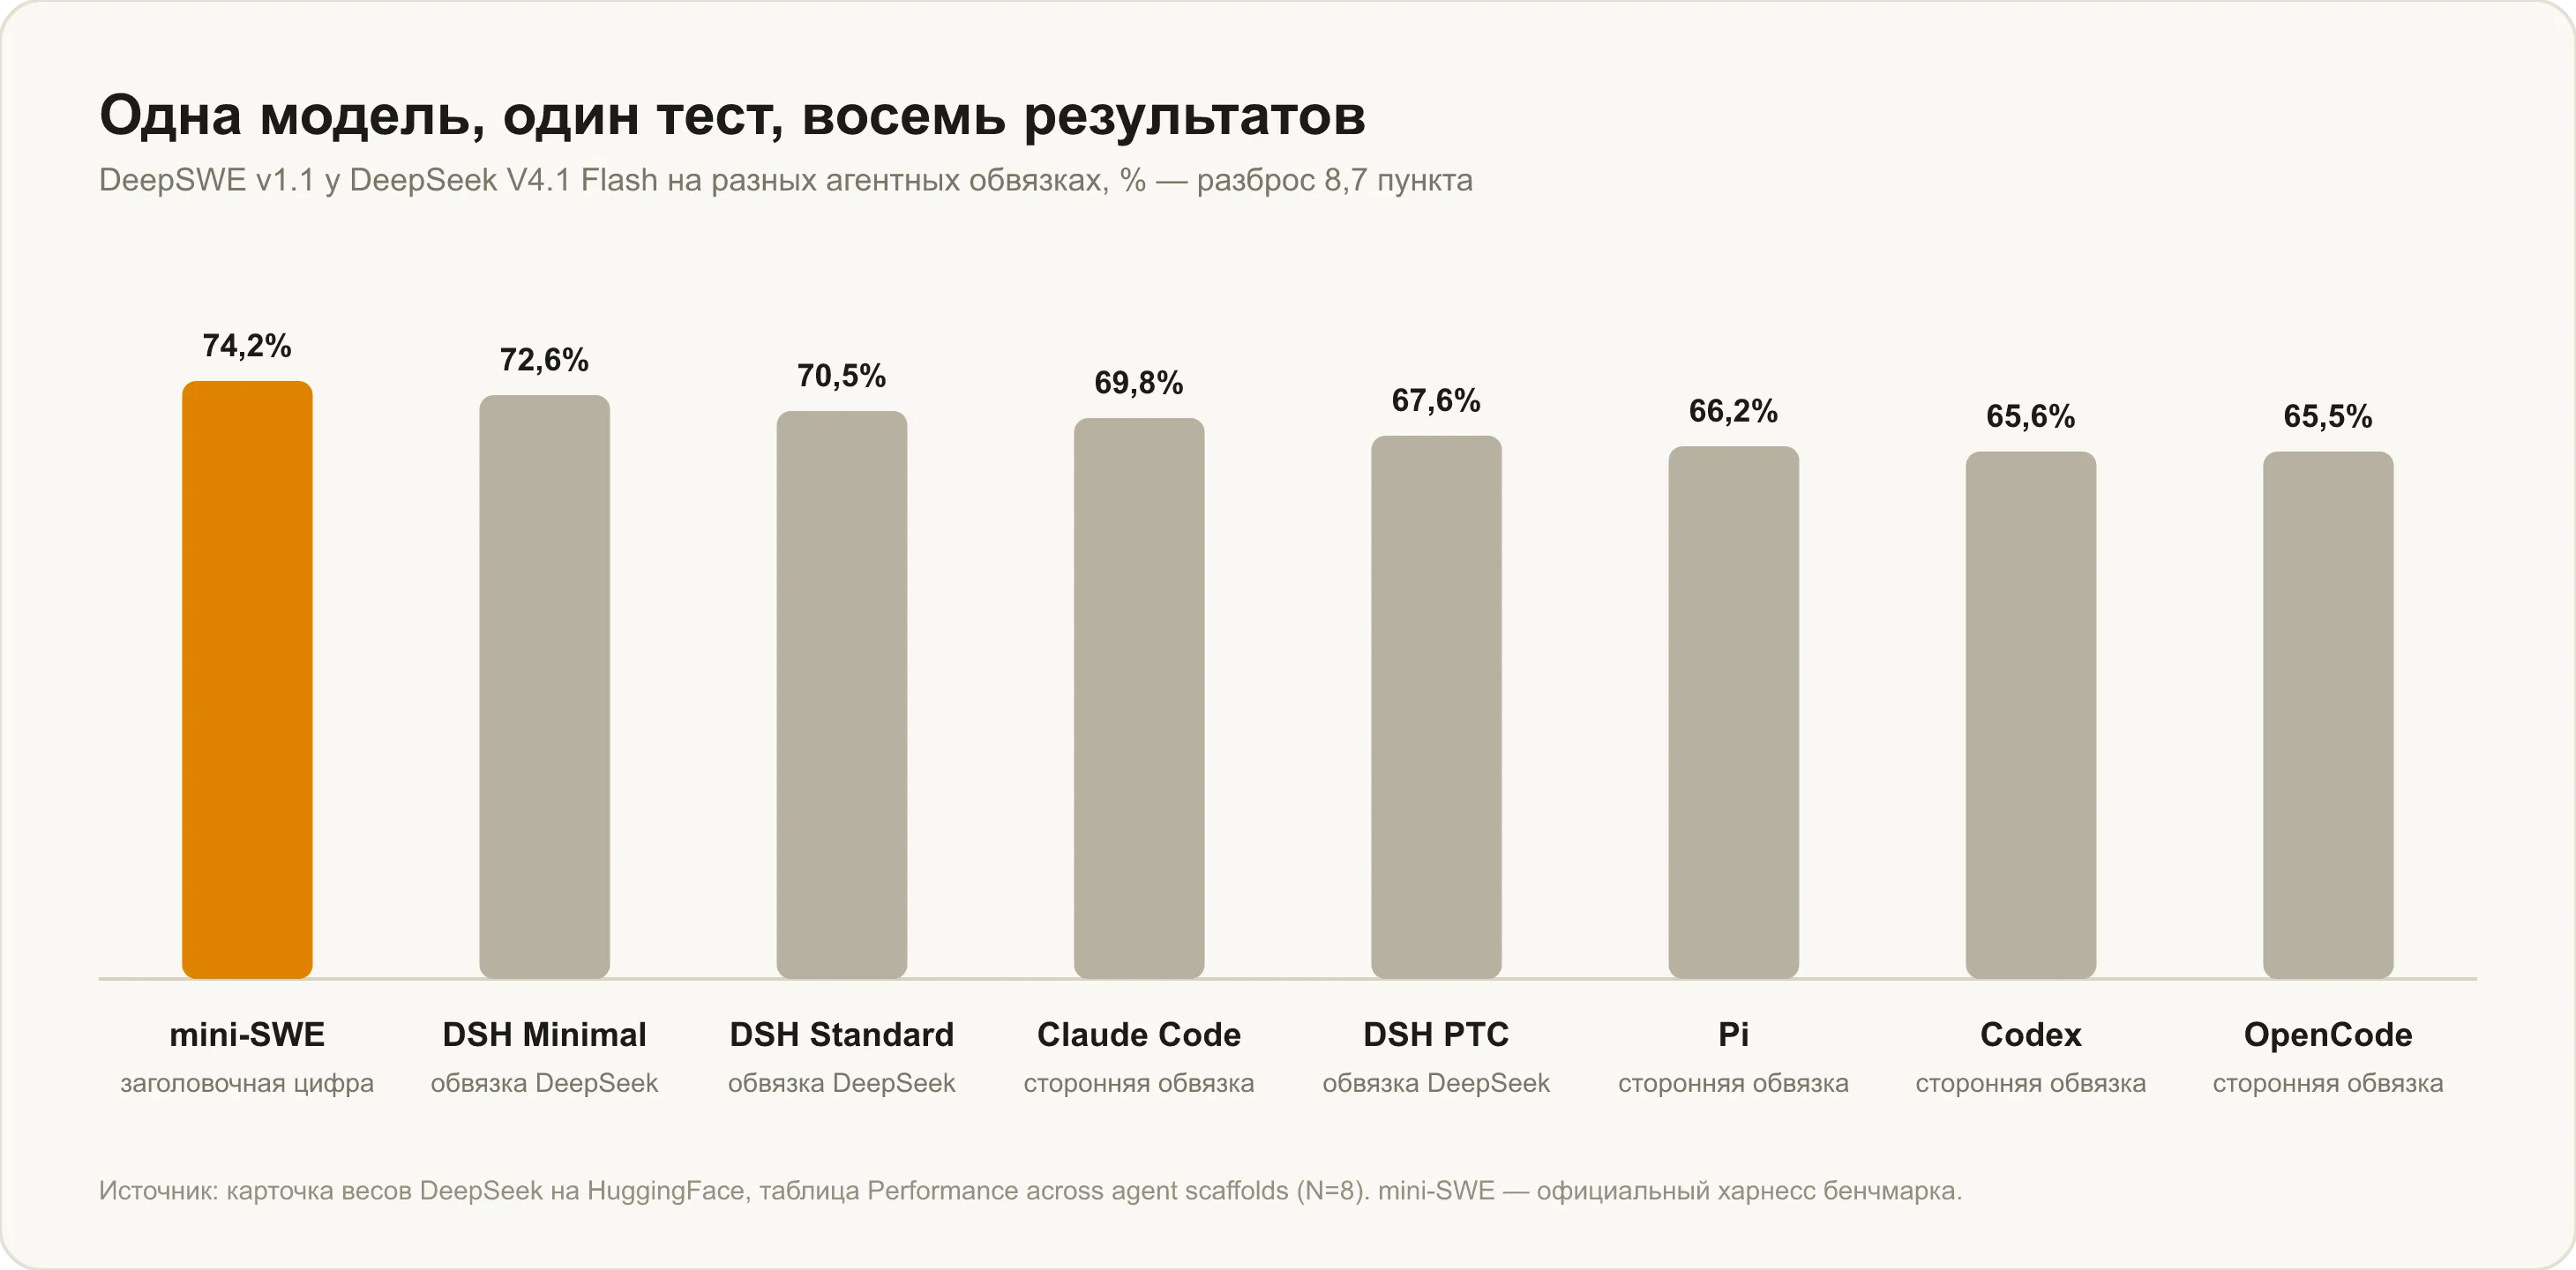
Заголовочные 74,2% взяты на mini-SWE — официальной обвязке бенчмарка, так что придраться формально не к чему. Но если вы сравниваете модели внутри своего инструмента, ориентируйтесь на нижнюю границу: разброс почти в девять пунктов больше, чем разрыв между многими флагманами.
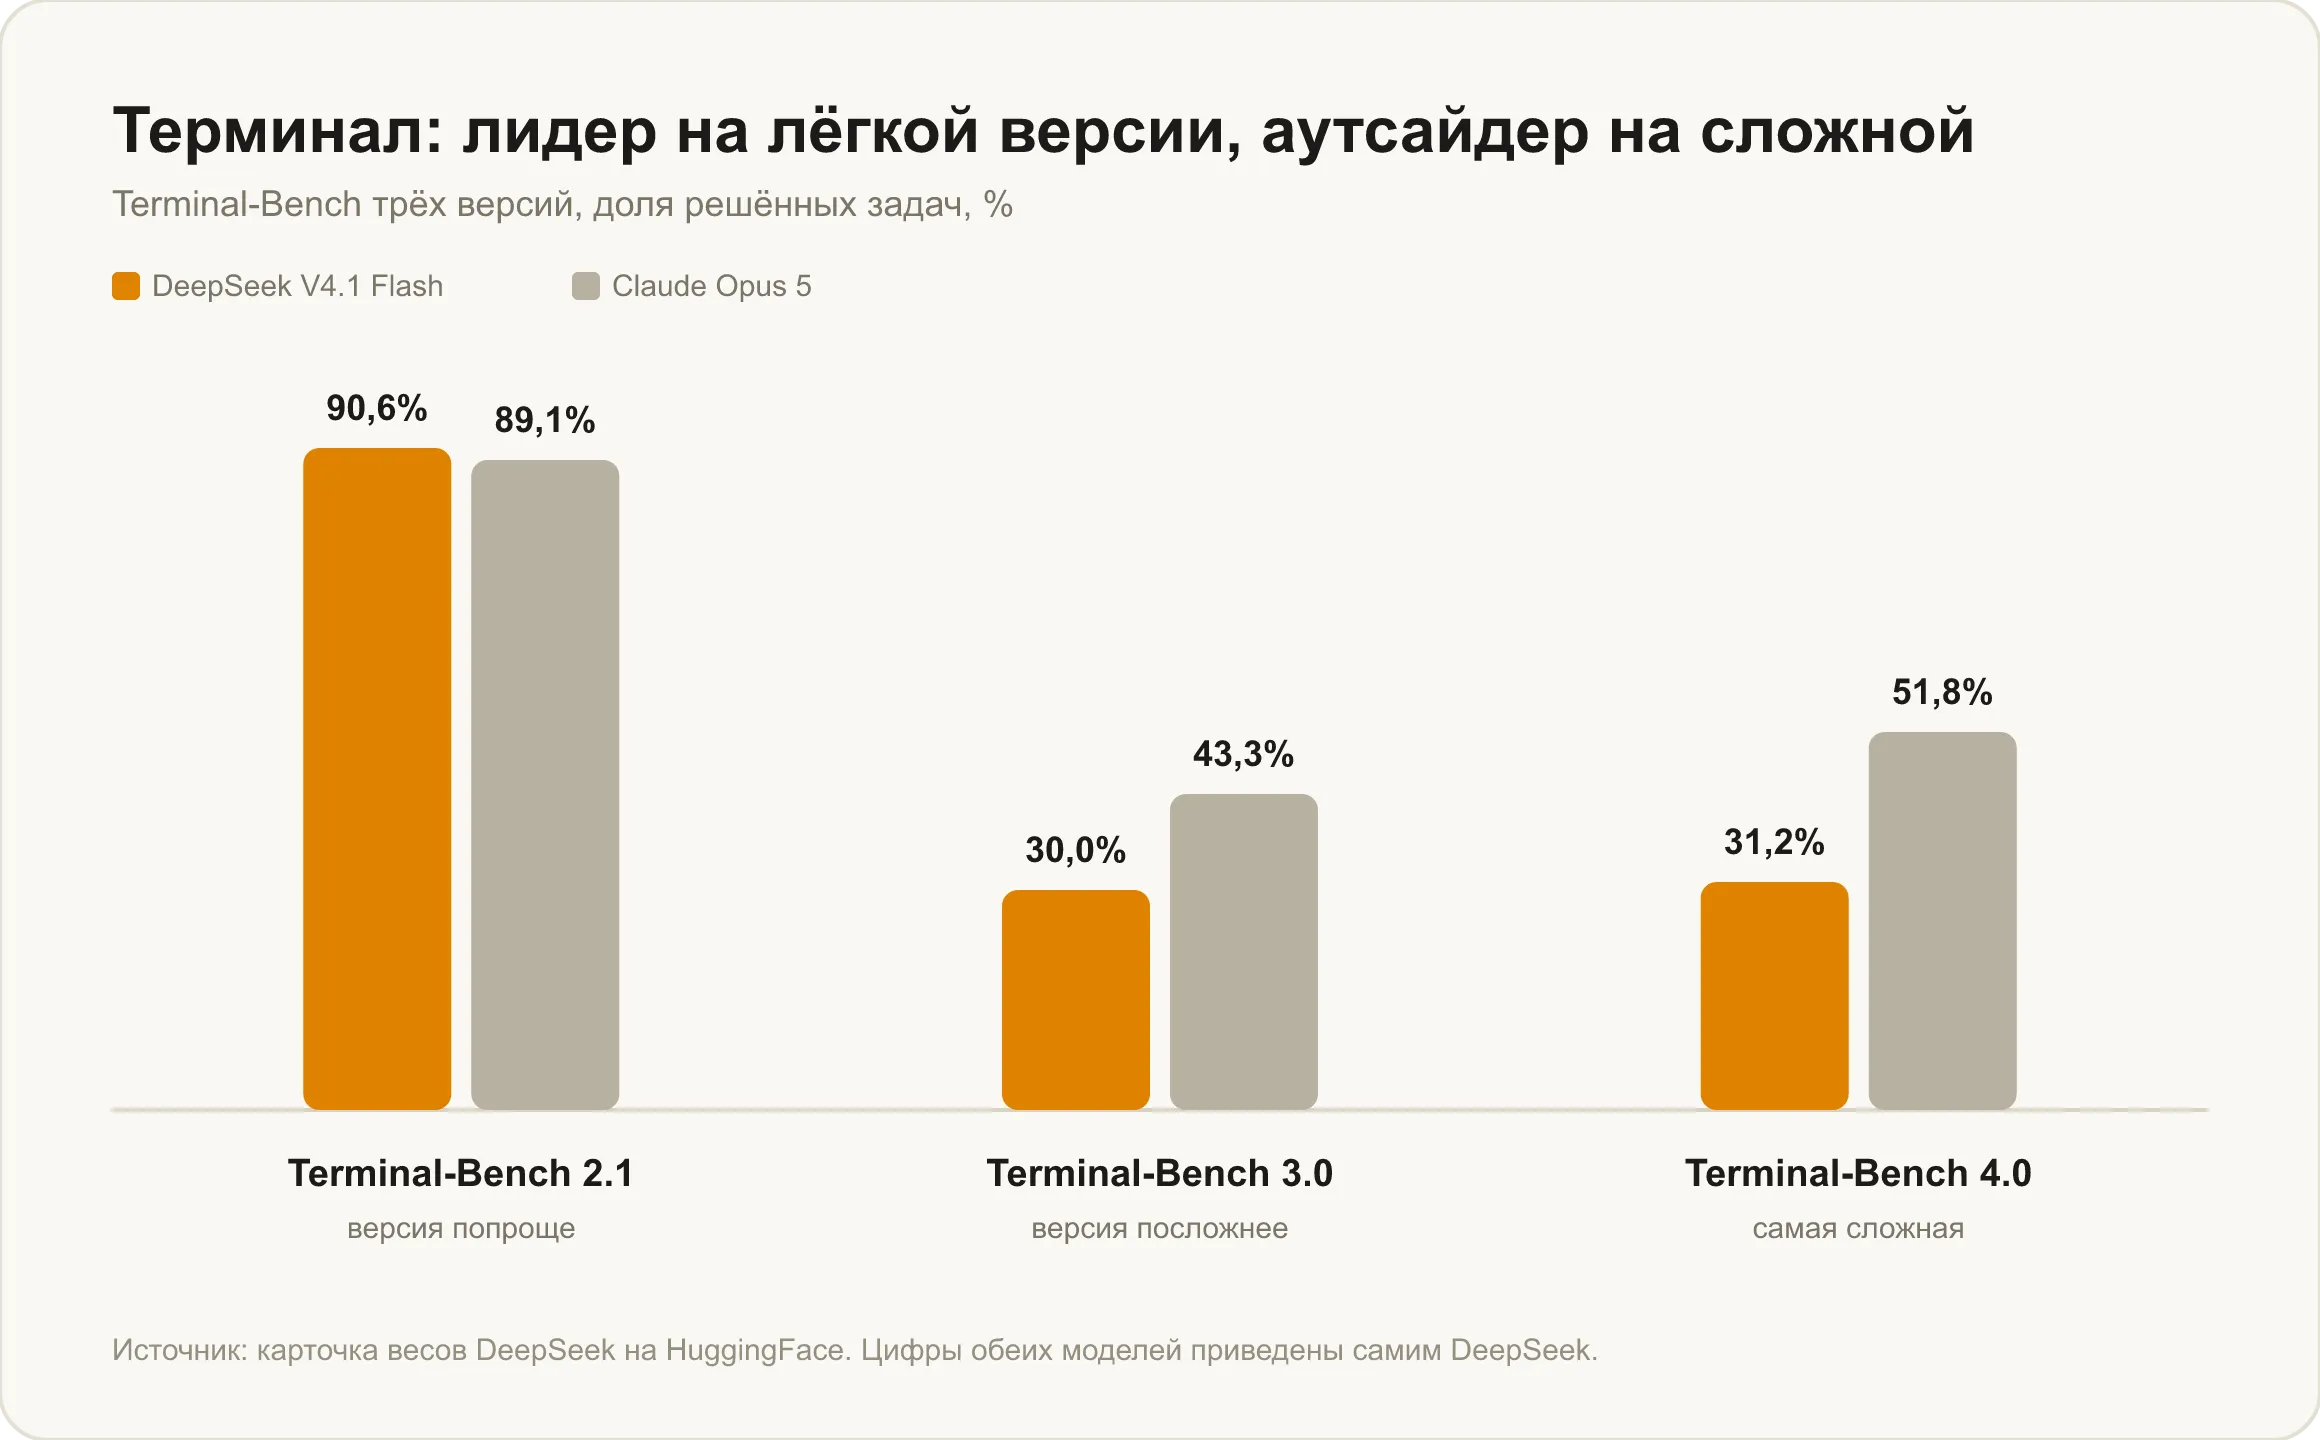
Есть и тесты, где V4.1 Flash проседает целиком, независимо от обвязки. На Terminal-Bench версий 3.0 и 4.0 — более трудных, чем 2.1, — у неё 30,0% и 31,2% против 43,3% и 51,8% у Claude Opus 5. Цифры Opus 5 здесь тоже из таблицы DeepSeek, а не из замера Anthropic.
История с отключением V4 Pro
Отдельный сюжет, который успел разойтись по новостям в неверном виде. В анонсе 10 сентября DeepSeek написала, что с 14 сентября все запросы к deepseek-v4-pro пойдут на V4.1 Flash по её тарифу — то есть старшую модель выводят из обращения. Логика понятная: зачем держать модель, которую обошла младшая и вчетверо более дешёвая.
Но пользователи возразили, и компания развернулась. В журнале изменений API формулировка сменилась: DeepSeek продолжает обслуживать V4 Pro и после 14 сентября, схема тарификации не меняется. На 22 сентября 2026 года модель в прайсе, работает и доступна по прежнему имени.
Так что тезис «V4 Pro отключили» неверен, хотя первая версия анонса давала для него основания. Если вы строите что-то на deepseek-v4-pro, переписывать код прямо сейчас не нужно.
Что выбрать под задачу
V4.1 Flash берут почти всегда. Код, агентные цепочки, разбор документов, работа с картинками, любая задача с длинным контекстом и ограниченным бюджетом — здесь она и точнее, и кратно дешевле, и держит больше параллельных запросов.
V4 Pro имеет смысл в двух случаях: если нужна максимальная точность в узкой научной области, где её превосходство на GPQA Diamond и HLE может сыграть, или если у вас уже работает продакшен на этой модели и менять его не хочется. Изображения при этом придётся обрабатывать чем-то другим.
Прошлая V4 Flash выбора не оставляет: её имена в API выведены из обращения и перенаправляются на V4.1 Flash по новому тарифу. Ничего делать не нужно, всё произойдёт само.
Если же вопрос шире, чем «какая из двух моделей DeepSeek», — у нас есть отдельный разбор, как выбрать нейросеть под задачу, и сравнение моделей именно по коду в материале какая нейросеть лучше пишет код.
Как сравнить модели самому
Бенчмарки отвечают на средний вопрос, а у вас он конкретный. Самый честный способ — дать двум моделям одну и ту же задачу из вашей работы и сравнить ответы.
DeepSeek V4.1 Flash добавлена в каталог моделей Veruna AI — чата, в котором нейросети разных разработчиков переключаются в одном окне, без VPN и с оплатой в рублях. Модель открыта на подписке Plus и выше, оформить её можно на странице тарифов. Как подключиться и какие ещё есть пути к модели из России, разобрано в статье как пользоваться DeepSeek V4.1 Flash.
Частые вопросы
Что лучше: DeepSeek V4.1 Flash или V4 Pro? В большинстве задач — V4.1 Flash. По замерам DeepSeek она обходит V4 Pro на правках кода (74,2% против 62,7%), автоматизации рутины (54,8% против 43,2%), агентных задачах и поиске уязвимостей, стоит вчетверо дешевле и понимает изображения. V4 Pro остаётся впереди только на двух тестах на эрудицию.
Чем V4.1 Flash отличается от V4 Pro технически? Размером и архитектурой: 552 млрд параметров против 1,6 трлн, но новая схема Causal Encoder-Decoder включает на запрос всего 8 и 16 млрд против 49 млрд у V4 Pro. Контекст у обеих — миллион токенов, максимальный ответ — 384 тысячи. Зрение есть только у Flash.
Сколько стоит DeepSeek V4 Pro? $0,66 за миллион входных токенов и $1,98 за выходные в льготные часы; в пиковые — $1,32 и $3,96. Чтение из кэша — $0,022 за миллион.
Отключили ли DeepSeek V4 Pro? Нет. В анонсе 10 сентября говорилось о переводе запросов на V4.1 Flash с 14 сентября, но компания отменила это решение: V4 Pro продолжает работать с прежней тарификацией и остаётся в прайсе.
Стоит ли доверять цифрам сравнения? С поправкой. Все бенчмарки обеих моделей публикует сама DeepSeek, независимых прогонов пока мало. К тому же результат сильно зависит от агентной обвязки: тот же DeepSWE v1.1 даёт от 74,2% до 65,5% в зависимости от каркаса, и компания честно опубликовала этот разброс.