
Кратко
- В сложной математике (FrontierMath Tier 4) GPT-6 Astra даёт 97,6% — заметно больше остальных: у Claude Fable 5.1 87,8%, у GPT-5.6 Sol 83,0%, у Claude Opus 5 73,2%.
- В широкой эрудиции без узкой специализации (Humanity's Last Exam) первая — Claude Fable 5.1: 65,0% против 57,2% у Astra.
- В сводном индексе Artificial Analysis, который усредняет десятки тестов, снова впереди Fable 5.1 — 65,7 против 61,2 у Astra.
- В программировании модели идут почти вровень, а в правках реального кода Astra обходит не Claude, а третья модель — Muse Spark 1.3.
Однозначного ответа на вопрос «гпт 6 астра или клод» не существует. По бенчмаркам сентября 2026 года ни одна из моделей не выигрывает везде: GPT-6 Astra от OpenAI сильнее в математике, работе в терминале и с длинными документами, а Claude Fable 5.1 от Anthropic — в широкой эрудиции и в сводном индексе, который учитывает результаты сразу по многим задачам. В коде почти ничья. По запросу «gpt 6 astra vs fable 5.1» ищут именно это: не общий рейтинг, а конкретные цифры по задачам. Сравнение gpt 6 astra и claude ниже построено по бенчмаркам, а не по заголовкам про «новый AGI», и заканчивается разбором, какую модель под какую задачу брать. Заодно смотрим, как в этой паре выглядят Claude Opus 5 и предыдущий флагман OpenAI GPT-5.6 Sol.
Математика, терминал, эрудиция: общая картина
Ниже — цифры по данным Vellum и DataCamp, которые собрали и сверили результаты релизных бенчмарков всех четырёх моделей.
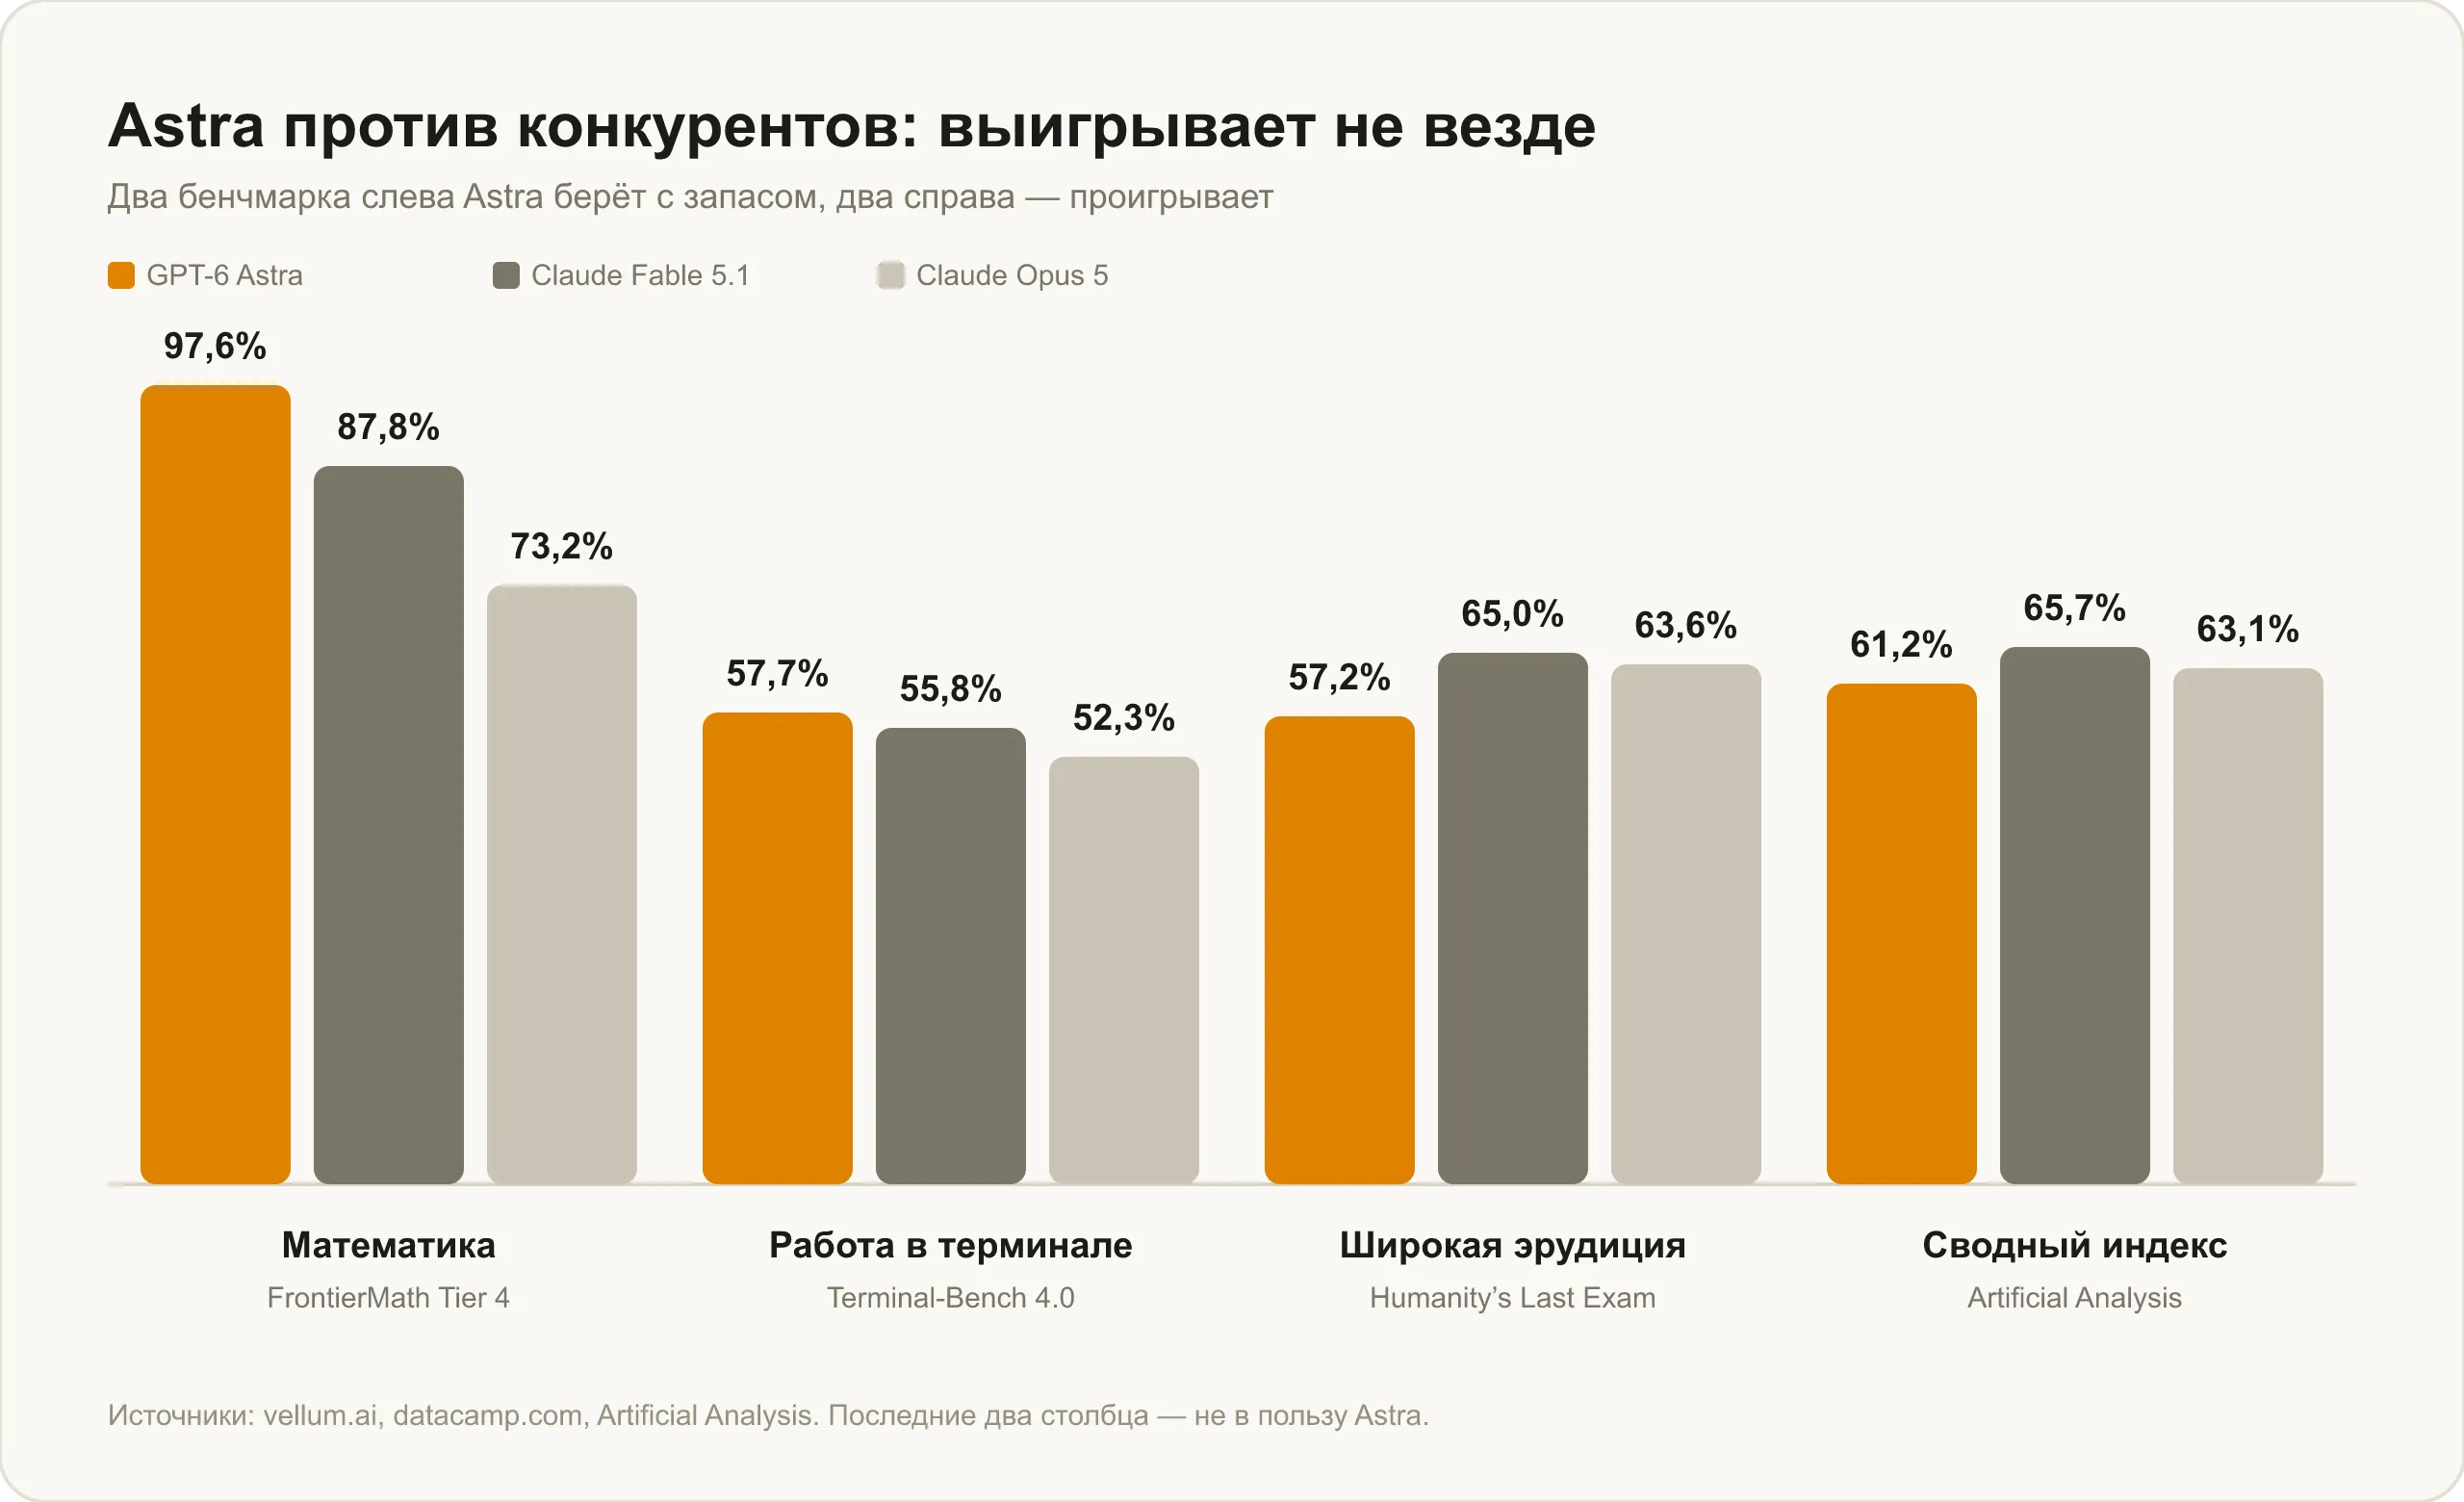
На сложной математике разрыв самый заметный. FrontierMath Tier 4 требует многошаговых доказательств уровня исследовательских работ — и здесь Astra решает 97,6% задач. Fable 5.1 отстаёт почти на 10 пунктов (87,8%), GPT-5.6 Sol ещё дальше (83,0%), а Opus 5 замыкает четвёрку (73,2%). Похожая картина на Terminal-Bench 4.0, где модель самостоятельно работает в терминале: у Astra 57,7%, у Fable 5.1 55,8% — разница уже не такая драматичная, а вот Sol заметно отстаёт (37,3%).
Но стоит перейти к тестам на широкую эрудицию — картина переворачивается. На Humanity's Last Exam, где вопросы разбросаны по десяткам областей знания и модель может пользоваться инструментами, первое место у Claude Fable 5.1 — 65,0%. У предыдущей версии, Claude Fable 5, было 63,8%, у Opus 5 — 63,6%, а у Astra результат заметно ниже — 57,2%. То же самое в сводном индексе Artificial Analysis, который усредняет результаты по десяткам бенчмарков сразу: 65,7 у Fable 5.1 против 61,2 у Astra и 63,1 у Opus 5. Иначе говоря, Astra выигрывает в узких задачах, где нужно глубокое рассуждение, а Fable 5.1 — там, где важна широта охвата и разноплановые знания.
Другие тесты, где Astra впереди
Есть тест, где разрыв выглядит почти неприлично большим — ARC-AGI-3, оценивающий способность модели решать новые абстрактные задачи, которых не было в обучающей выборке. Astra здесь показывает 99,9% против 30,2% у Opus 5 и всего 7,8% у Sol. Но к этой цифре стоит отнестись с поправкой: рекорд получен на специальном тестовом стенде OpenAI, а не через обычный публичный API — при доступе через API результат заметно ниже. Использовать «99,9% на ARC-AGI-3» как аргумент в духе «Astra — самая умная модель» нечестно: это лабораторный рекорд, а не то, что получит рядовой пользователь в обычном чате.
Более приземлённые тесты подтверждают преимущество Astra не так эффектно, но стабильно. В GPQA Diamond, тесте на понимание сложных научных вопросов, у Astra 96,0% — на волос впереди Sol (94,6%), Fable 5.1 и Opus 5 (у обоих 93,7%). В OSWorld 2.0, где модель должна сама выполнять задачи в реальных программах (открывать файлы, кликать по интерфейсу, переключаться между окнами), Astra набирает 72,6% против 70,2% у Opus 5 и 65,7% у Sol. На ExploitBench, тесте на поиск уязвимостей в коде, разрыв ещё больше: 100% у Astra против 78,5% у Sol и 70,0% у Opus 5.
Отдельно стоит длинный контекст. На MRCR v2 (тесте, где модель ищет несколько нужных фактов в огромном документе) на диапазоне от 512 тысяч до миллиона токенов Astra держит 96,3% против 73,8% у Sol. Для задач вроде разбора многостраничного договора или большого архива переписки это ощутимая разница: чем длиннее документ, тем заметнее превосходство Astra в удержании деталей. Подробнее о том, что Astra умеет на таких объёмах, — в отдельном разборе: что умеет GPT-6 Astra.
Сравнение gpt 6 astra и claude по бенчмаркам: таблица
Прочерк в таблице означает, что производитель не публиковал сопоставимый результат для этой модели на момент выхода Astra — не додумываем цифру за него.
| Бенчмарк | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| FrontierMath Tier 4 (математика) | 97,6% | 87,8% | 73,2% | 83,0% |
| Terminal-Bench 4.0 (терминал) | 57,7% | 55,8% | 52,3% | 37,3% |
| ARC-AGI-3 (спецстенд)* | 99,9% | — | 30,2% | 7,8% |
| GPQA Diamond (наука) | 96,0% | 93,7% | 93,7% | 94,6% |
| OSWorld 2.0 (работа в программах) | 72,6% | — | 70,2% | 65,7% |
| ExploitBench (безопасность) | 100% | — | 70,0% | 78,5% |
| Humanity's Last Exam с инструментами | 57,2% | 65,0% | 63,6% | — |
| Сводный индекс Artificial Analysis | 61,2 | 65,7 | 63,1 | — |
| Индекс кодинг-агентов Artificial Analysis | 67,0 | 67,2 | — | — |
| DeepSWE v1.1 (правки в коде) | 74,1% | — | — | 72,7% |
| FrontierCode Main | 53,3% | — | 53,4% | — |
| MRCR v2, 512 тыс.–1 млн токенов (длинный контекст) | 96,3% | — | — | 73,8% |
* Результат получен на закрытом тестовом стенде OpenAI, а не через публичный API — через обычный доступ он заметно ниже.
Кто сильнее в программировании
В коде однозначного лидера нет. В индексе кодинг-агентов Artificial Analysis, который оценивает именно агентную работу с кодом (правки, тесты, отладку), три модели идут практически вровень: у предыдущей версии Fable 5 — 68,1, у Fable 5.1 — 67,2, у Astra — 67,0. Разница на уровне погрешности замера, и заявлять по ней победителя нечестно.
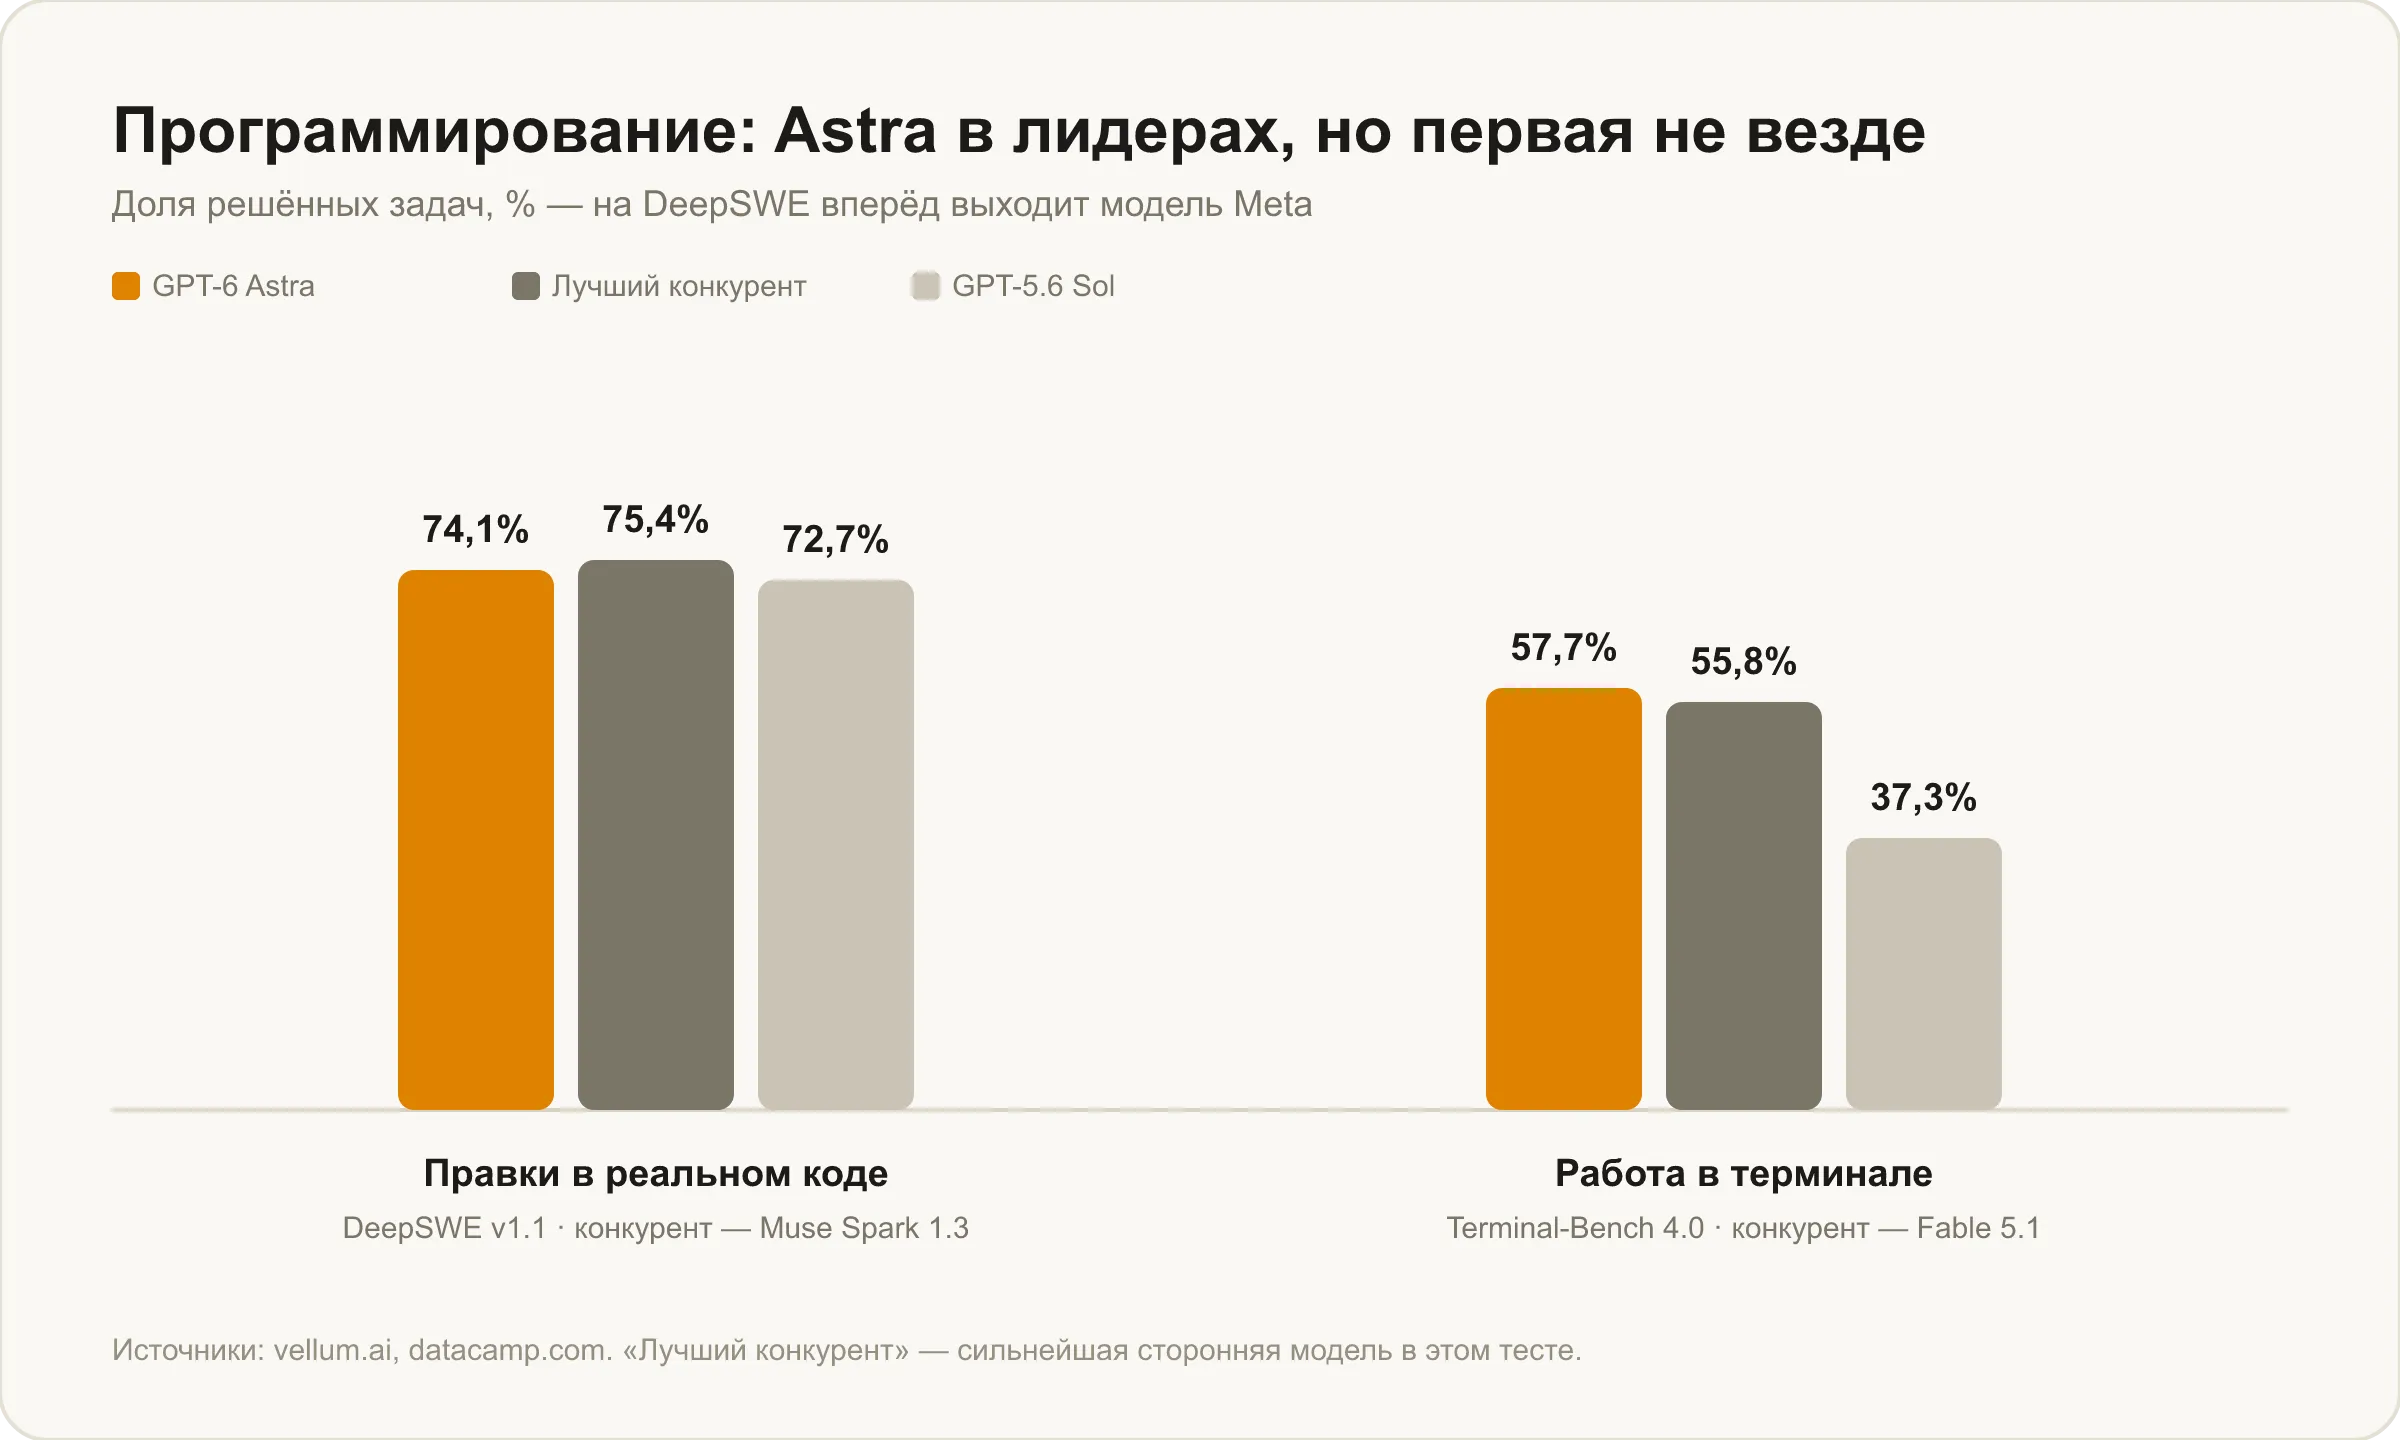
На DeepSWE v1.1, бенчмарке на правки в реальных кодовых базах, у Astra 74,1%, у Sol — 72,7%. Но лучший результат здесь не у Astra и не у Claude, а у третьей модели — Muse Spark 1.3 (75,4%): даже в своей сильной категории Astra не первая. На FrontierCode Main разница вообще стирается — 53,3% у Astra, 53,5% у Fable 5 и 53,4% у Opus 5, по сути статистическая ничья.
Так что на запрос «лучшая нейросеть для кода» честный ответ такой: по опубликованным бенчмаркам сентября 2026 года заметного лидера нет — есть кластер моделей с сопоставимым качеством, и выбирать стоит по цене, скорости ответа или удобству интеграции, а не по проценту из одного теста. Раньше мы уже сравнивали похожим образом три других флагмана — GPT-5.6, Claude Sonnet 5 и Grok 4.5 — там в кодинге тоже не было явного победителя, а решала цена API.
Правда ли Astra — самая умная нейросеть
Вокруг релиза Astra было много формулировок в духе «первая модель уровня AGI» — но по цифрам это преувеличение. В половине сравнений из этой статьи выигрывает не Astra: широкую эрудицию и сводный индекс держит Claude Fable 5.1, агентный кодинг — статистическая ничья, а в правках кода на DeepSWE лучший результат вообще у сторонней модели, Muse Spark 1.3. Единственный по-настоящему «рекордный» результат Astra, ARC-AGI-3, получен на закрытом стенде производителя и не воспроизводится через обычный API в той же мере.
Реальная сила GPT-6 Astra — в узком, но ценном наборе задач: сложная математика, самостоятельная работа в терминале и в программах, удержание фактов в очень длинном контексте. Это не делает модель универсальным чемпионом — зато делает предсказуемым выбором для конкретных сценариев.
Какая нейросеть лучше 2026: выбор под задачу
- Математика, доказательства и исследовательские расчёты — берите Astra: разрыв на FrontierMath Tier 4 самый заметный из всех бенчмарков в этом сравнении.
- Самостоятельная работа в терминале и в программах — тоже Astra: и Terminal-Bench 4.0, и OSWorld 2.0 у неё выше, чем у Fable 5.1, Opus 5 и Sol.
- Разбор очень длинных документов или больших кодовых баз целиком — снова Astra: на MRCR v2 она удерживает факты надёжнее Sol на объёме от полумиллиона токенов.
- Широкая эрудиция, разноплановые вопросы и рассуждения без узкой специализации — здесь выигрывает Fable 5.1: и на Humanity's Last Exam, и в сводном индексе Artificial Analysis она впереди.
- Написание и правка обычного продуктового кода — разница между моделями на уровне погрешности измерения, разумнее выбирать по цене или скорости, а не по бенчмарку.
- Поиск уязвимостей и задачи безопасности — снова Astra: на ExploitBench у неё 100% против 78,5% у Sol и 70,0% у Opus 5.
Здесь же стоит учесть особенность, о которой редко пишут: у Astra нельзя отключить режим рассуждений — можно выбрать только его глубину. На практике это значит более медленный ответ даже на простой вопрос, зато меньше ошибок на сложных многошаговых задачах. А ещё Astra — одна из самых дорогих моделей на рынке: через официальный API OpenAI доступ стоит от 50 за миллион выходных, кэшированный повторный ввод дешевле — $1 за миллион. Подробно про доступ, цену и особенности модели — в отдельном материале: как пользоваться GPT-6 Astra в России без VPN.
GPT-6 (Astra, Sol) и Claude (Fable 5.1, Opus 5) — обе линейки уже в каталоге Veruna AI и переключаются в одном чате. Не нужно заводить отдельные аккаунты у OpenAI и Anthropic, чтобы прогнать одну и ту же задачу через разные модели и сравнить ответы вживую — это честнее, чем полагаться на процент из чужого бенчмарка. Astra открыта на подписке Max — без VPN, без иностранной карты, с оплатой в рублях; оформить можно на странице тарифов.
Частые вопросы
Что лучше — гпт 6 астра или клод? Зависит от задачи. GPT-6 Astra сильнее в сложной математике, работе в терминале и программах, а также в удержании фактов на очень длинном контексте. Claude Fable 5.1 сильнее в широкой эрудиции и в сводном индексе Artificial Analysis, который учитывает результаты сразу по многим тестам. В программировании разница между моделями на уровне погрешности.
Какая нейросеть сильнее в математике? GPT-6 Astra. На FrontierMath Tier 4, тесте на сложные многошаговые доказательства, у неё 97,6% — против 87,8% у Claude Fable 5.1, 83,0% у GPT-5.6 Sol и 73,2% у Claude Opus 5. Это самый заметный разрыв среди всех бенчмарков в этом сравнении.
Какая модель лучше для кода? Явного лидера нет. В индексе кодинг-агентов Artificial Analysis три модели отличаются на доли пункта (67,0–68,1). На DeepSWE v1.1 Astra обходит Sol, но лучший результат вообще у другой модели — Muse Spark 1.3 (75,4%). Для повседневных задач разумнее выбирать модель по цене и скорости, а не по одному проценту.
Правда ли Astra — самая умная модель? Нет, если понимать «умная» широко. Astra выигрывает в узких задачах вроде математики и работы в терминале, но проигрывает Claude Fable 5.1 в широкой эрудиции (Humanity's Last Exam) и в сводном индексе Artificial Analysis. А заявленный рекорд 99,9% на ARC-AGI-3 получен на закрытом тестовом стенде OpenAI, а не через обычный API.
Можно ли сравнить модели на своей задаче? Да. Обе линейки — GPT-6 и Claude — уже в каталоге Veruna AI, переключение между моделями происходит прямо в чате, без отдельных аккаунтов у каждого разработчика. Это надёжнее, чем ориентироваться только на проценты из бенчмарков: на своей задаче модели иногда ведут себя иначе, чем на тестовом наборе.