
Кратко
- Qwen 3.8 Max вышла 3 августа 2026 года, а 2 сентября Alibaba выкатила обновлённый снапшот 0902 — с той же архитектурой и тем же прайсом, но заметно сильнее в коде.
- Под капотом разреженная MoE-архитектура: 2,4 трлн параметров всего и около 95 млрд активных на токен. Контекст — миллион токенов, на входе текст, картинки и видео, на выходе только текст.
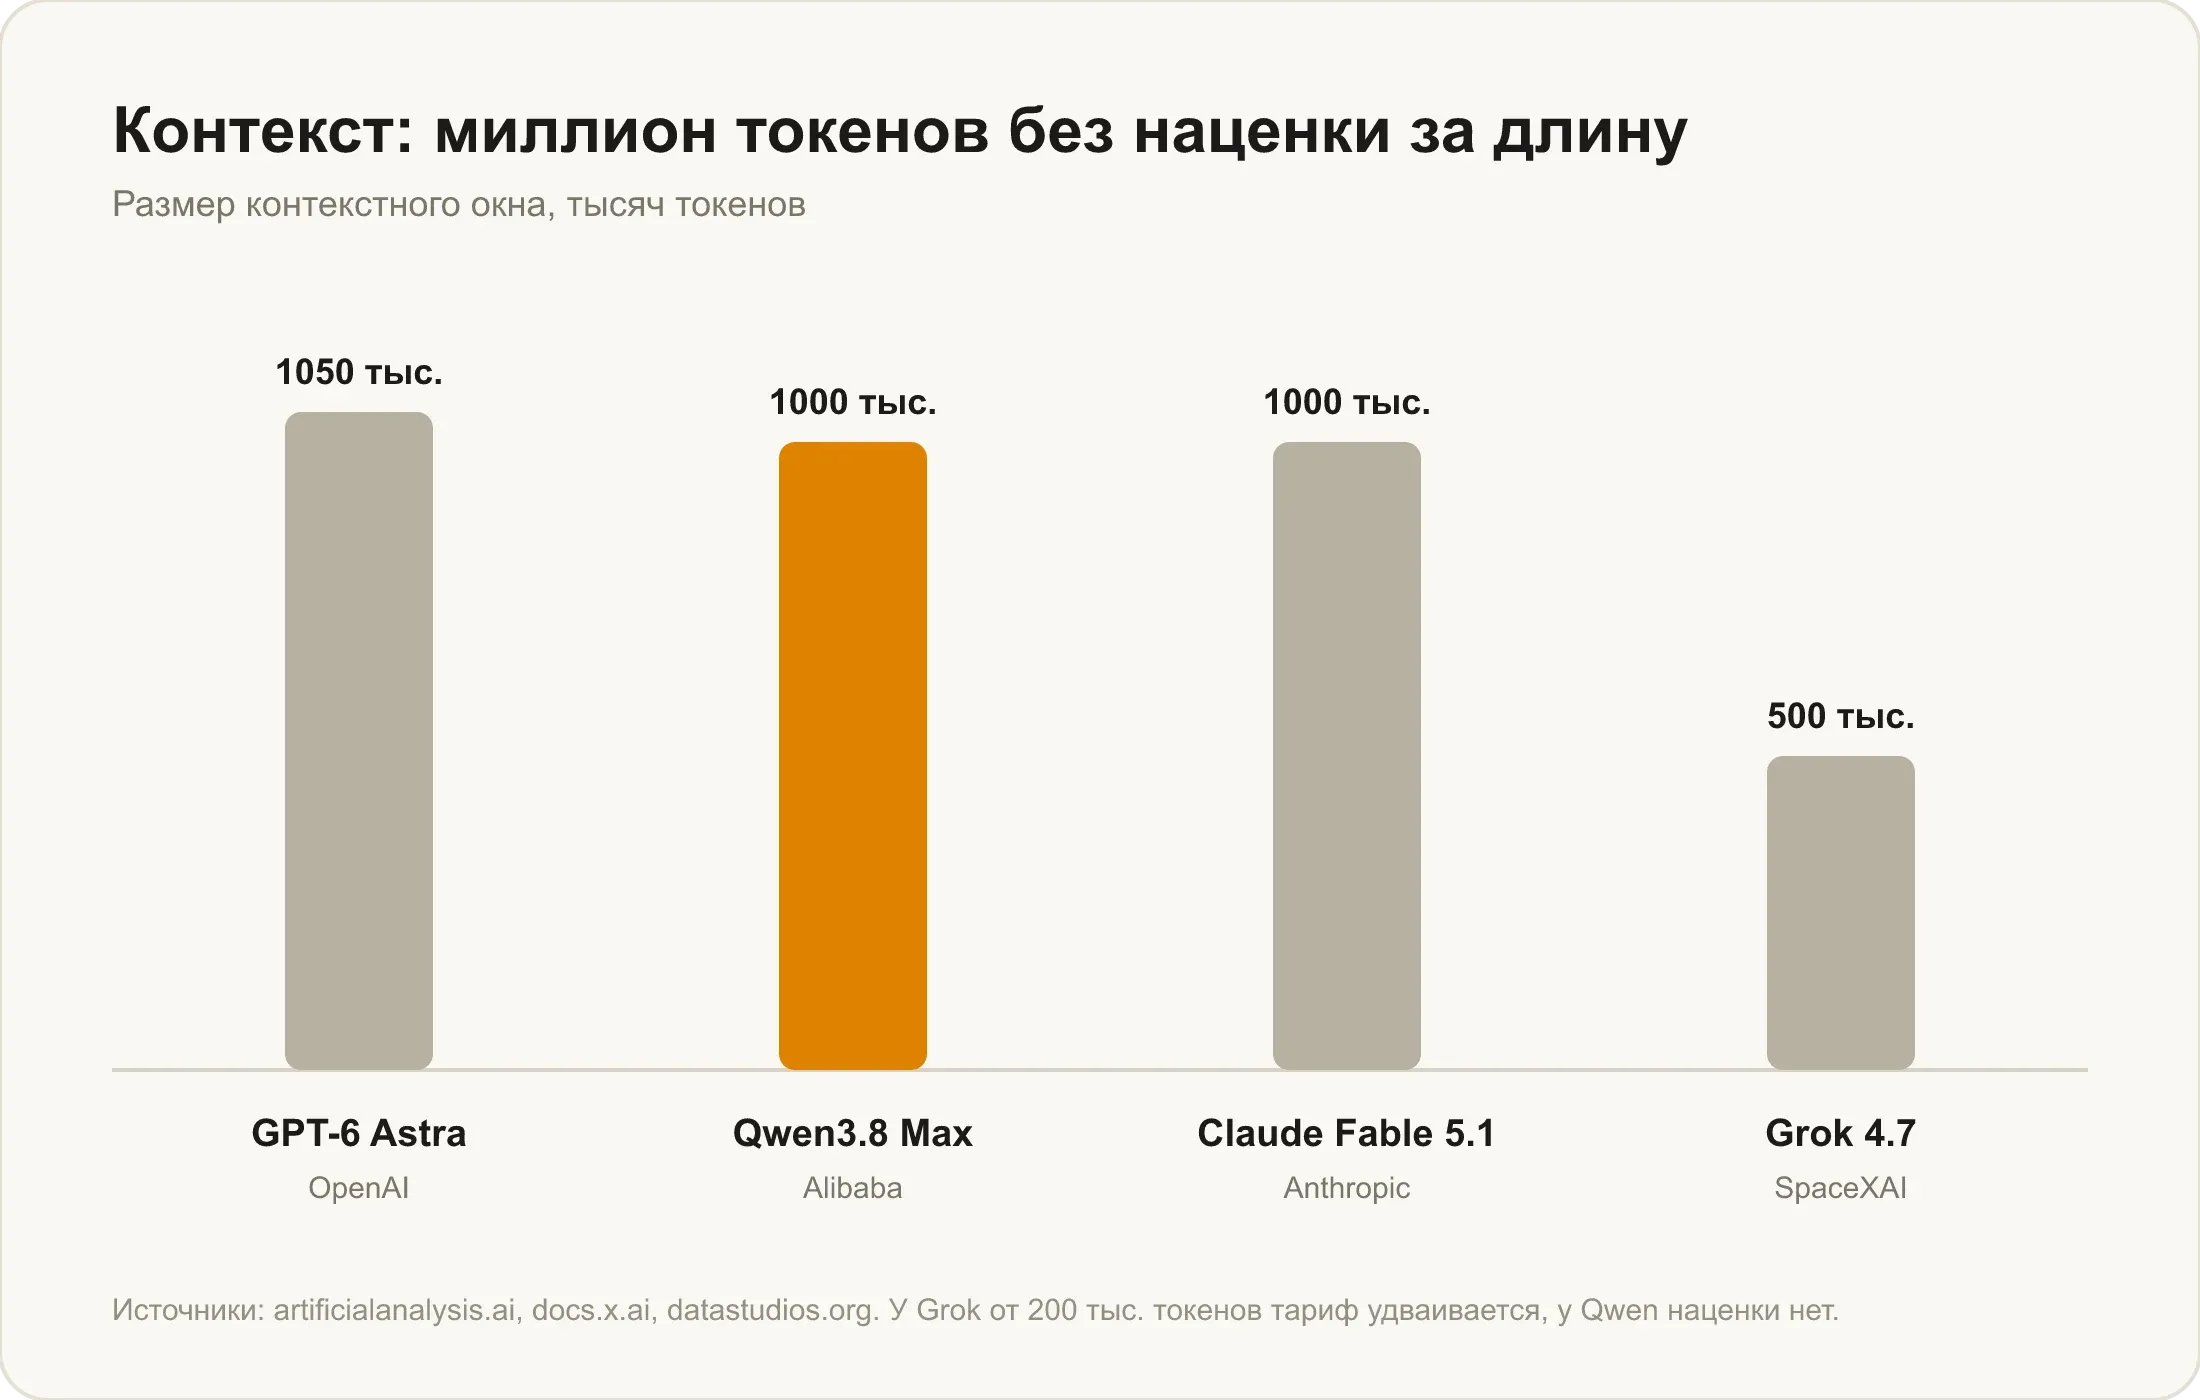
- Цена в официальном API — $2 и $6 за миллион токенов, причём тариф одинаковый на всём окне: наценки за длинный промпт у Qwen нет.
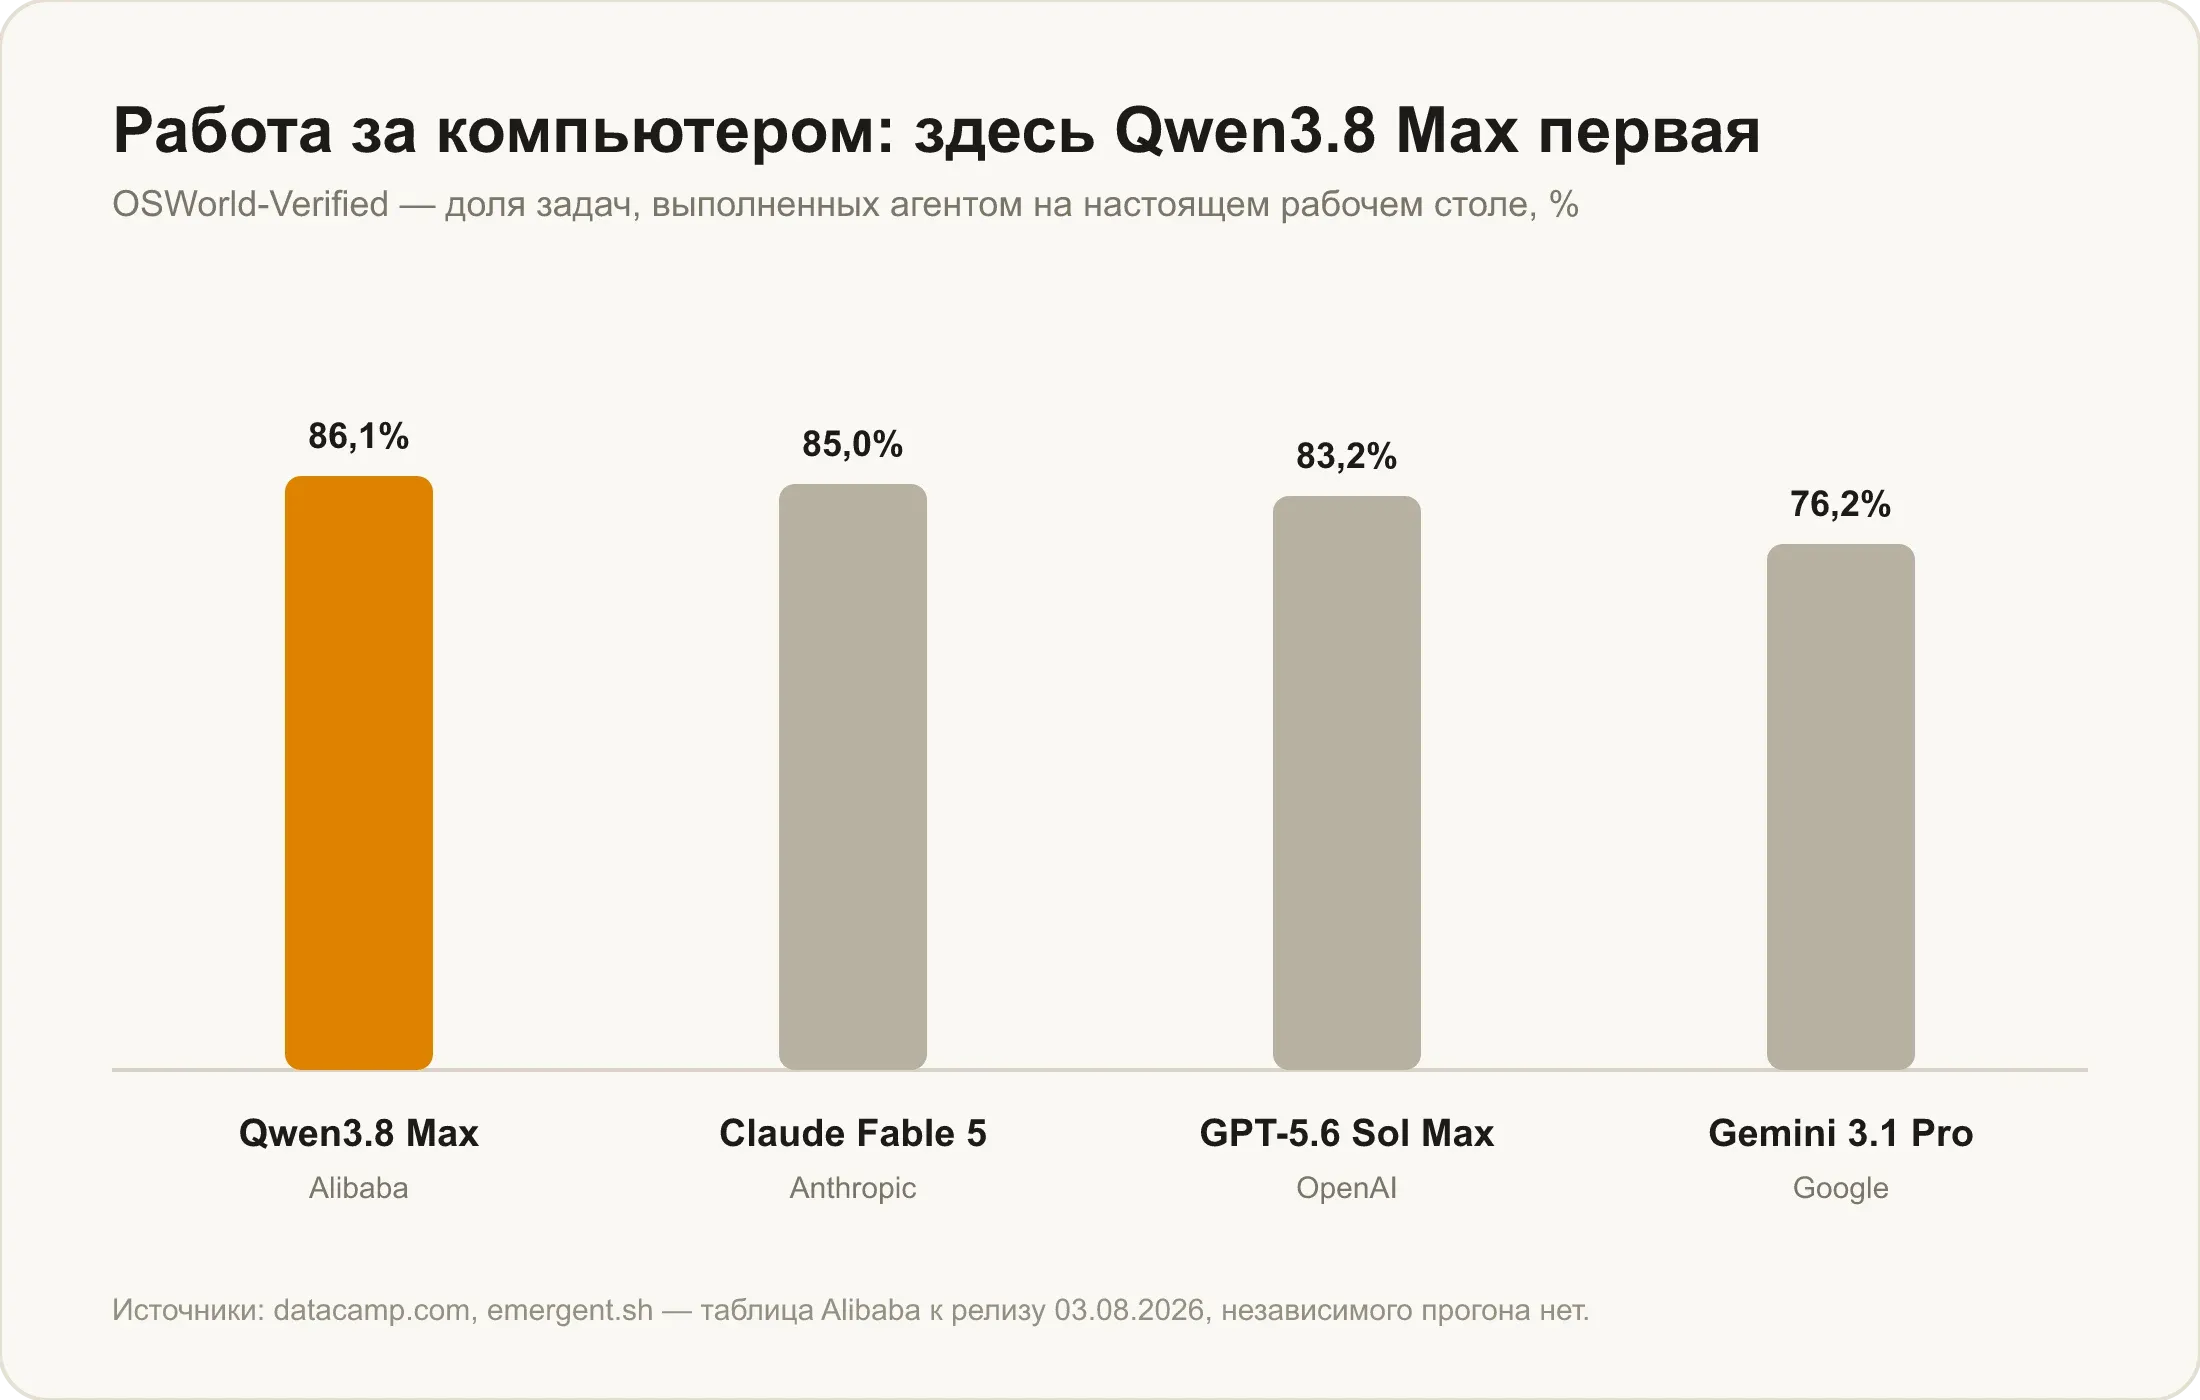
- Главный результат релиза — работа за компьютером: 86,1% на OSWorld-Verified против 85,0% у Claude Fable 5 и 83,2% у GPT-5.6 Sol Max. Но в независимом индексе Artificial Analysis модель только девятнадцатая.
Qwen 3.8 Max — флагманская модель Alibaba, и на вопрос «qwen 3.8 max что это» ответ такой: это самая крупная закрытая модель китайской линейки Qwen, доступная только по API, с идентификатором qwen3.8-max. В рунете её ищут по-разному: «квен 3.8», «квен 3.8 макс», «китайская нейросеть квен» — везде имеется в виду один и тот же релиз. Дальше по порядку: дата выхода, характеристики в таблице, честные цифры по бенчмаркам и разбор того, где заявления Alibaba расходятся с независимым замером.
Дата выхода Qwen 3.8 Max
Публично модель показали 19 июля 2026 года на Всемирной конференции по ИИ в Шанхае, а общедоступной она стала 3 августа 2026 года — сразу в API, без листа ожидания.
Через месяц, 2 сентября, вышел обновлённый снапшот — Qwen3.8-Max-0902. Это не новая модель: архитектура, размер контекста и цена остались прежними, поменялось только дообучение. Alibaba направила его на код, агентные сценарии с несколькими инструментами и разбор документов с графиками. В API снапшот живёт под идентификатором qwen3.8-max-0902 (есть и понятный алиас qwen3.8-max-2026-09-02), а обращение к общему имени qwen3.8-max отдаёт актуальную версию.
Отдельная история — открытые веса. Их Alibaba выложила в августе, но не для той модели, что работает в API. Вариант Qwen3.8-2.4T-A95B опубликован примерно 12 августа под собственной лицензией компании, и он только текстовый: ни зрения, ни родного окна на миллион токенов там нет. Чуть позже, около 14 августа, вышла компактная Qwen3.8-27B — уже под Apache 2.0, с поддержкой картинок и с расчётом на одну видеокарту. Полная мультимодальная версия осталась закрытой.
Qwen 3.8 Max: характеристики
Все параметры модели в одной таблице.
| Параметр | Значение |
|---|---|
| Разработчик | Alibaba, команда Qwen |
| Идентификатор в API | qwen3.8-max, снапшот — qwen3.8-max-0902 |
| Дата выхода | 3 августа 2026 года, снапшот 0902 — 2 сентября |
| Архитектура | разреженная MoE, 2,4 трлн параметров |
| Активных параметров | около 95 млрд на токен |
| Контекстное окно | 1 000 000 токенов |
| Максимальный вход | 991 тыс. токенов (983 тыс. с включёнными рассуждениями) |
| Максимальный ответ | 131 тыс. токенов (отдельный потолок, а не слагаемое окна) |
| Вход | текст, изображения, видео |
| Выход | только текст |
| Режим рассуждений | переключаемый: есть и с рассуждениями, и без них |
| Цена ввода | $2 за млн токенов |
| Цена вывода | $6 за млн токенов |
| Кэшированный ввод | $0,25 за млн токенов |
| Лимиты API | 15 тыс. запросов в минуту, 2 млн токенов в минуту |
| Совместимость | интерфейсы OpenAI и Anthropic |
Пара цифр из таблицы заслуживает расшифровки. Соотношение «2,4 трлн всего, 95 млрд активных» означает, что при ответе работает не вся модель целиком, а примерно двадцать пятая её часть — отсюда и относительно низкая цена токена при большом размере. Такую же схему используют почти все крупные китайские модели последних двух лет.
Контекст в миллион токенов — это около полутора тысяч страниц. Но полезнее другое: у Qwen нет порога, после которого тариф растёт. У Grok 4.7, например, промпт свыше 200 тысяч токенов пересчитывается по удвоенной ставке целиком. Здесь такого нет, миллионный промпт стоит по той же цене, что и десятитысячный.
Видео на входе — редкость даже среди флагманов. По документации модель принимает до 2048 изображений или до 64 видеороликов за раз, суммарной длительностью примерно до двух часов. На выходе при этом только текст: ни картинок, ни видео Qwen 3.8 Max не генерирует.
Что модель умеет: бенчмарки августовского релиза
Сильнее всего Alibaba выступила там, где модель управляет компьютером как человек — кликает по интерфейсу, открывает программы, доводит многошаговую задачу до конца. На OSWorld-Verified у Qwen 3.8 Max 86,1%, у Claude Fable 5 — 85,0%, у GPT-5.6 Sol Max — 83,2%, у Gemini 3.1 Pro — 76,2%.
В той же августовской таблице стояло и 86,6% на Terminal-Bench 2.1 — формально лучший результат среди тогдашних флагманов, но независимо его никто не прогонял.
Второй заметный результат — PaperBench, воспроизведение научных работ по их тексту: 93,0%, лучший показатель среди сопоставленных моделей. На естественно-научных вопросах уровня аспирантуры (GPQA Diamond) — 92,6%, ровно столько же, сколько у Claude Fable 5. В разборе документов со сложной вёрсткой (OmniDocBench 1.5) — 92,1%, в математике по картинке (MathVision) — 95,2% (DataCamp, emergent.sh).
А вот где августовская версия выступила слабо, Alibaba в пресс-материалах не подчёркивала. Следование инструкциям (IFBench) — 82,8%, самый низкий результат среди четырёх флагманов того периода. Широкая эрудиция на Humanity's Last Exam — 43,6%, тоже последнее место в четвёрке. На SWE-bench Pro, тяжёлом тесте на инженерию ПО, модель набрала 67,7% против 80,0% у Claude Fable 5 — разрыв в двенадцать пунктов.
Что изменил снапшот 0902
Сентябрьское обновление било ровно в то место, где августовская версия проваливалась, — в агентный код. Цифры до и после выглядят почти неприлично: работа в терминале по строгой версии теста (TerminalBench 3.0) выросла с 11,3% до 29,0%, программирование по ProgramBench — с 10,5% до 28,0%, правки в коде (DeepSWE v1.1) — с 56,6% до 69,3%, задачи по репозиторию (QwenSWEBench V2) — с 55,1% до 70,0%, офисные задачи (JobBench) — с 53,4% до 64,0% (CellCog, TechNode).
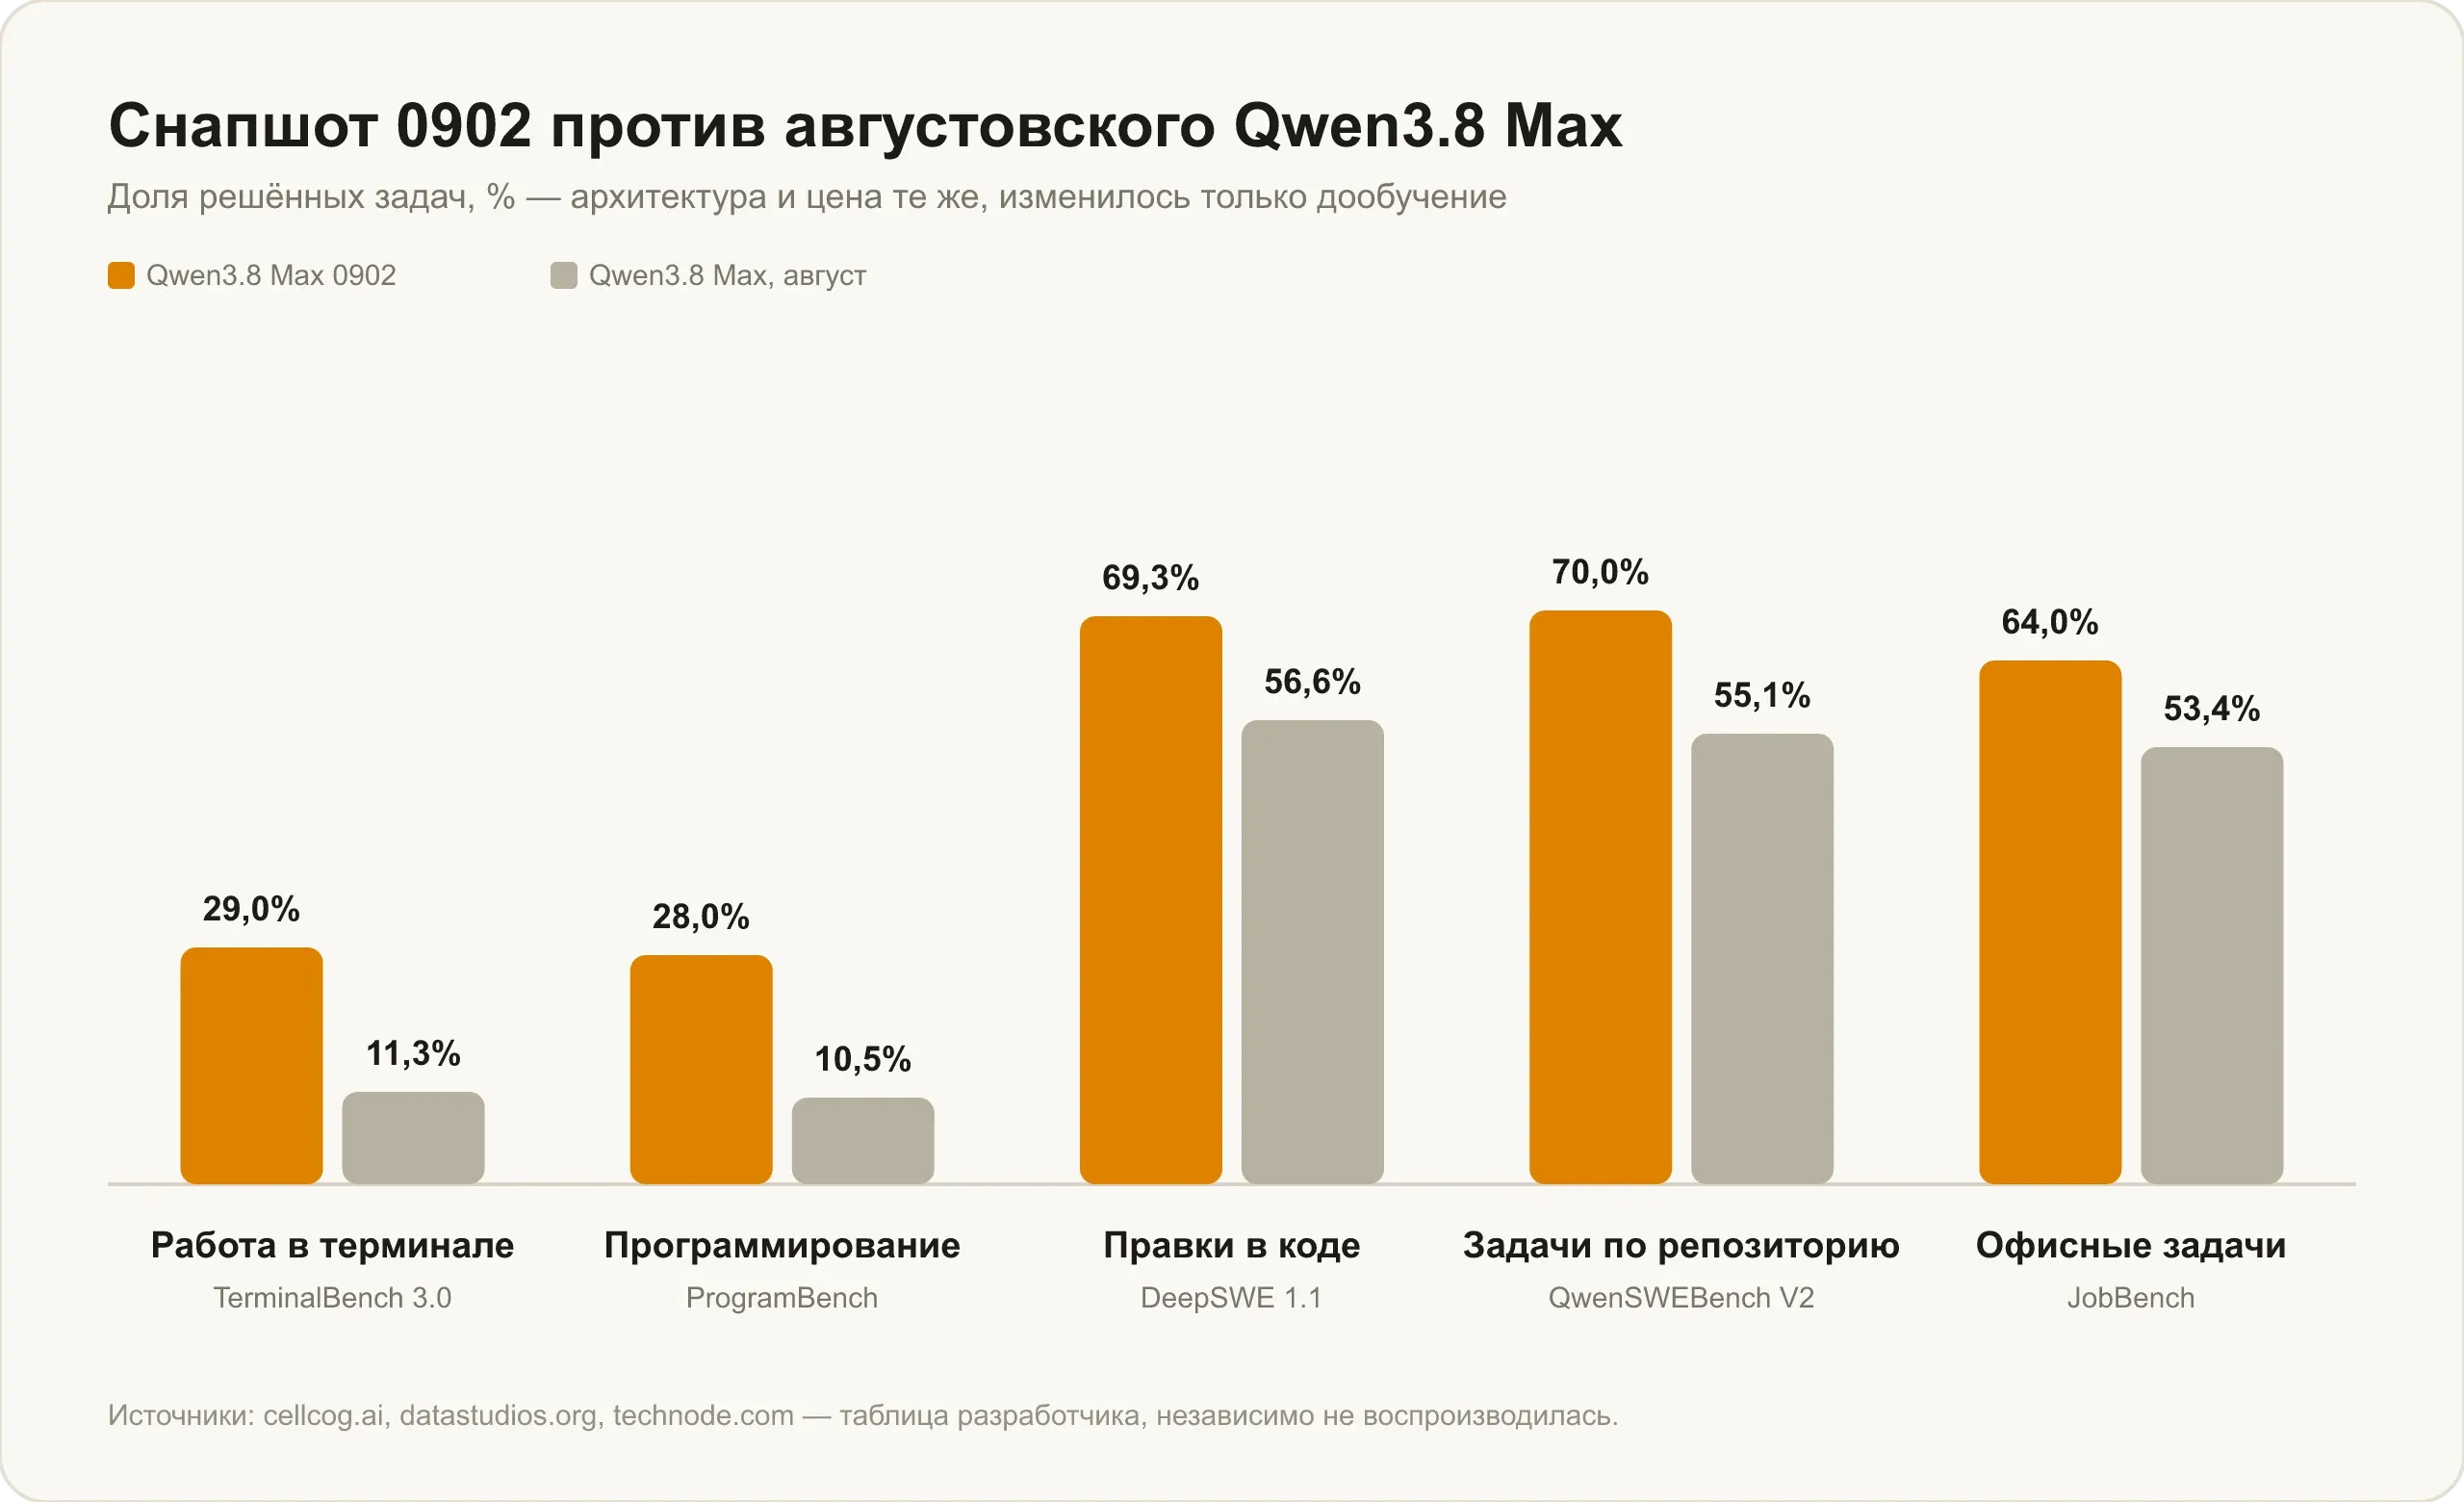
Тут важно не перепутать версии тестов. Terminal-Bench 2.1 с результатом 86,6% из августовской таблицы и TerminalBench 3.0 с результатом 29,0% — это два разных набора задач, а не падение модели втрое. Третья версия заметно тяжелее, и её проценты сопоставимы только с процентами других моделей на ней же.
Самое весомое достижение снапшота — независимое: 2 сентября Qwen3.8-Max-0902 дебютировала на первом месте лидерборда Code Arena в разделе WebDev с 1691 баллом. Это на 22 балла выше прежней версии модели (1669), на 3 балла выше Claude Opus 5 в режиме максимального усилия (1688) и на 17 — выше Kimi K3 (1674). Лидерборд считает не вендор, а сторонняя площадка на голосовании разработчиков, поэтому вес у этой цифры совсем другой, чем у таблицы из пресс-релиза (Code Arena).
Честно: где цифры расходятся
Здесь стоит остановиться подробно, потому что разброс оценок вокруг этой модели больше обычного.
Первое расхождение — собственный маркетинг против агрегатора. Команда Qwen в соцсети заявила, что модель занимает пятое место в индексе интеллекта Artificial Analysis и первое — в агентном. На карточке самой модели у агрегатора на 22 сентября 2026 года стоит 45,4 балла, и это далеко не пятёрка лидеров. Возможно, в вендорском посте считали только флагманы разных компаний, а не все модели подряд, но проверить это со стороны нельзя (Artificial Analysis).
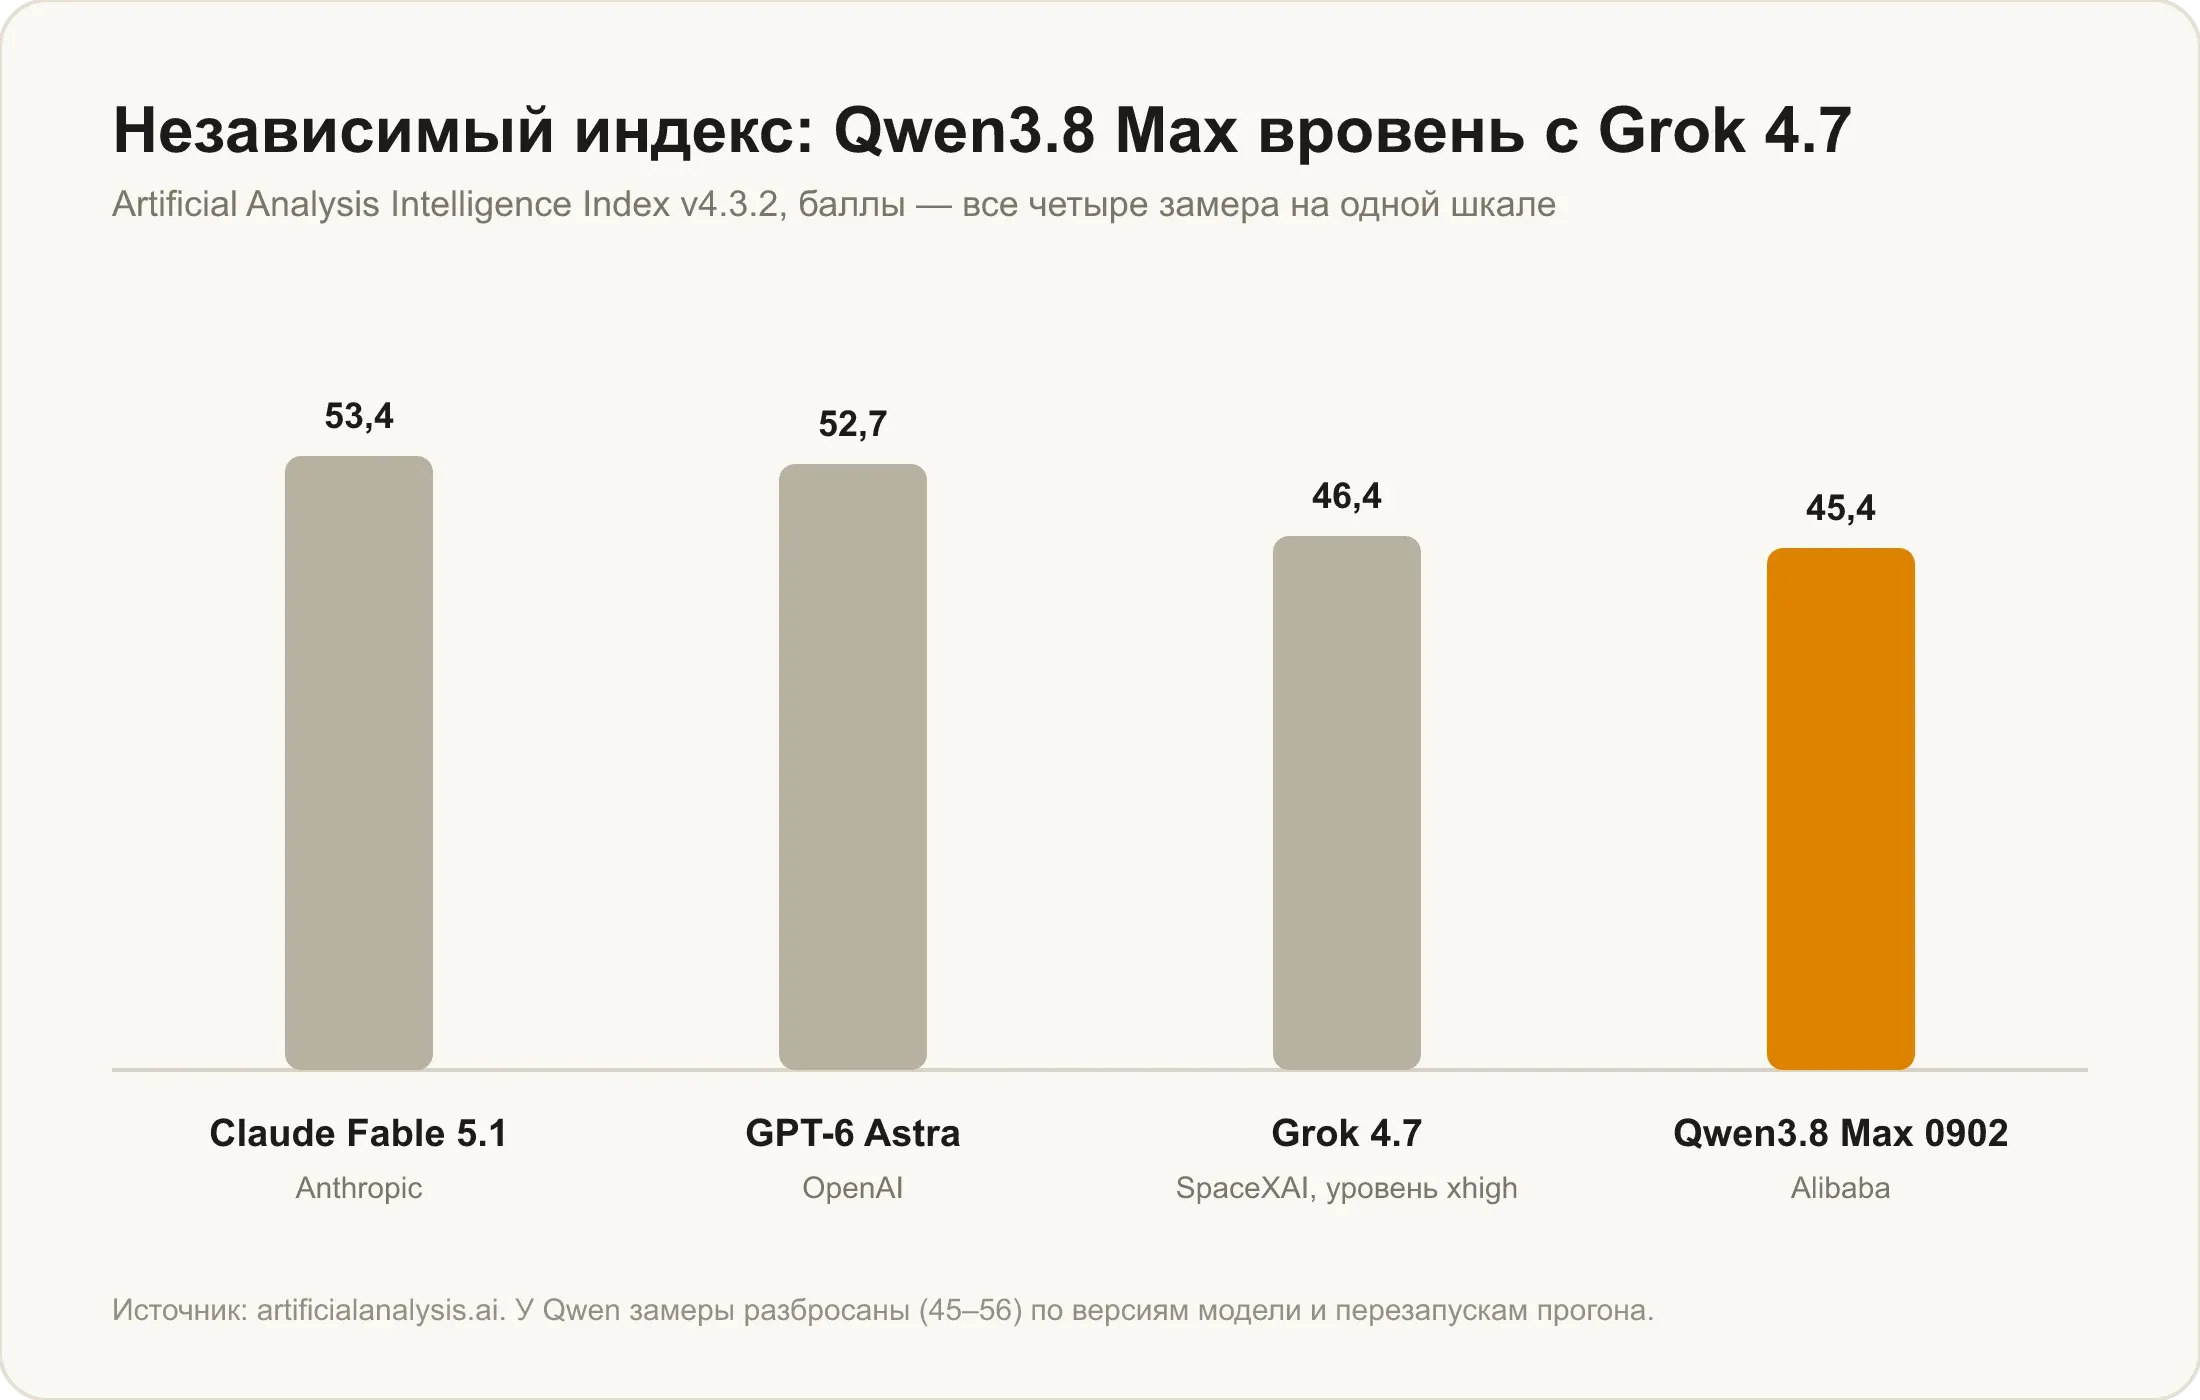
Второе расхождение — внутри замеров самого агрегатора. По обзорам ходит цифра «56 баллов», и она не выдумана: у Qwen 3.8 Max результаты Artificial Analysis разбросаны примерно от 45 до 56 в зависимости от версии модели и конкретного прогона, причём часть тестов агрегатор перезапускал из-за проблем с эндпойнтом. Наложилась и смена шкалы: индекс переехал на версию 4.3.2 с более тяжёлыми задачами, и баллы съехали вниз у всех моделей сразу. Складывать цифры разных прогонов и разных версий индекса нельзя, так что одной цифрой эту модель описывать пока рано. Оговорку про смену шкалы мы делали и в разборе релиза Grok 4.7.
Третье — вся августовская таблица бенчмарков прогонялась самой Alibaba. Независимого воспроизведения этих чисел на момент написания статьи нет. Исключение — Code Arena, где замер делает сторонняя площадка, и индекс Artificial Analysis, который агрегатор считает сам.
И четвёртое, самое практичное: Artificial Analysis описывает модель как медленную и очень многословную. Скорость выдачи — 39,2 токена в секунду, это 153-е место в их рейтинге по быстроте. На прогон одного только индекса модель израсходовала 190 млн токенов. По замерам агрегатора, на задачу у неё уходит около 64 шагов против 14 у предыдущего поколения. Дешёвый токен это частично съедает: сам прогон индекса обошёлся почти в пять тысяч долларов (Artificial Analysis).
Все цифры в статье актуальны на 22 сентября 2026 года.
Сколько стоит Qwen 3.8 Max
Цена в официальном API — $2 за миллион входных токенов и $6 за миллион выходных, кэшированный ввод стоит $0,25. Относительно прошлого поколения это падение примерно на 20%: Qwen3.7 Max стоила $2,50 и $7,50.
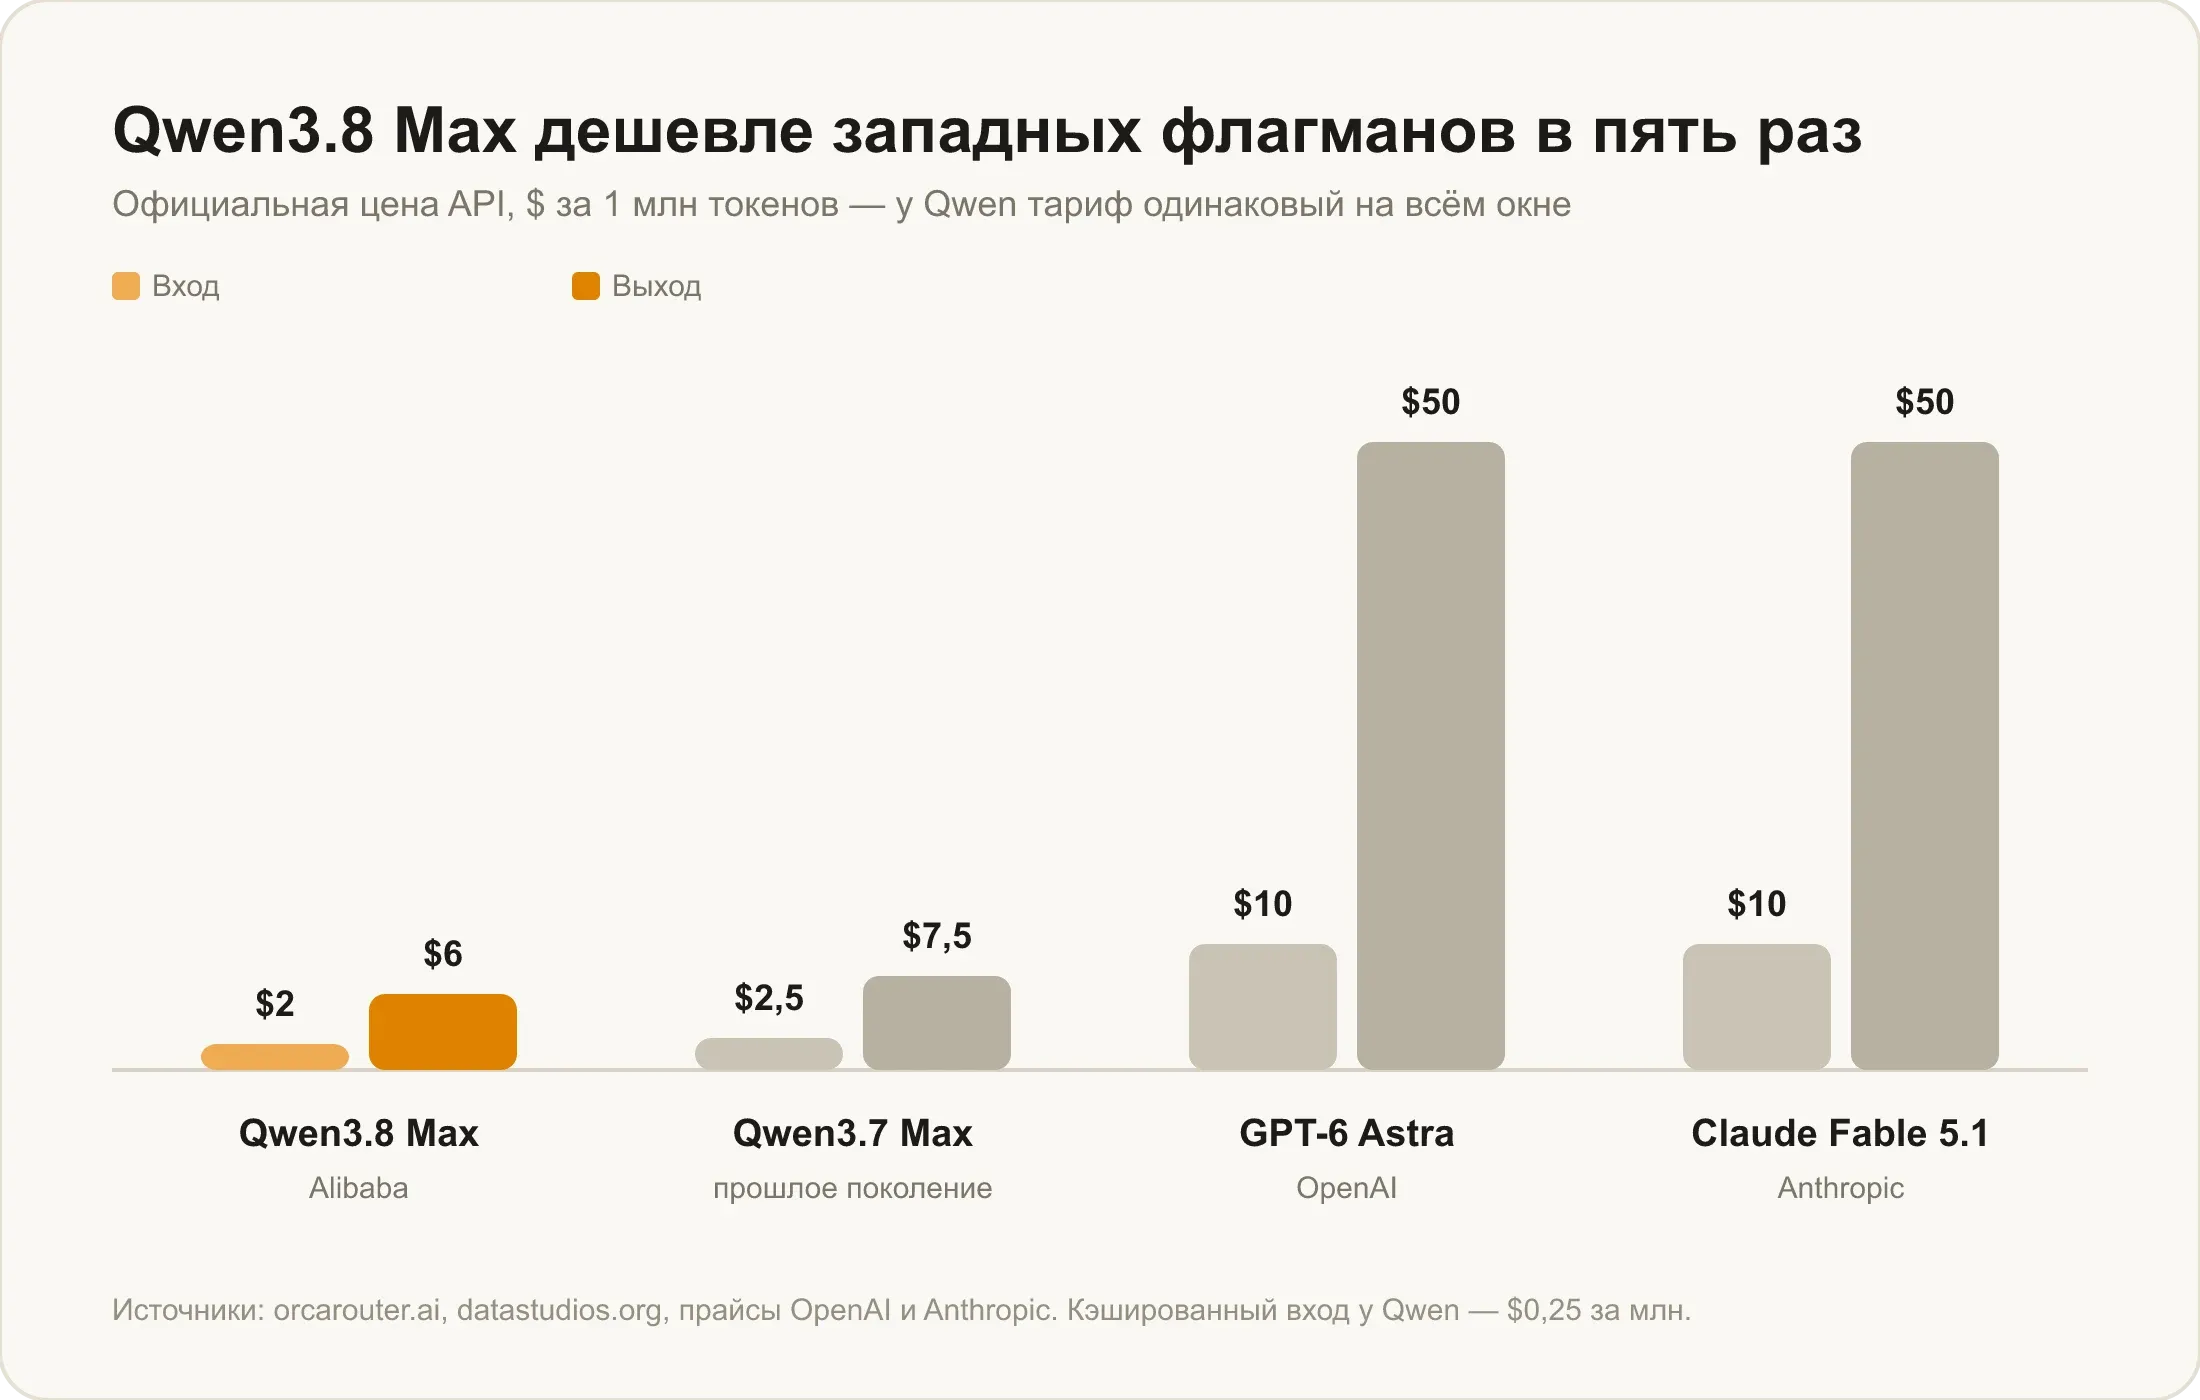
На фоне западных флагманов разрыв пятикратный: у GPT-6 Astra и Claude Fable 5.1 тот же объём стоит $10 и $50. Ровно столько же, сколько Qwen, берёт Grok 4.7 — $2 и $6, — но с оговоркой про удвоение тарифа на длинных промптах, которой у китайской модели нет.
Оплатить API напрямую из России не выйдет: расчёты у Alibaba Cloud идут иностранными картами. Поэтому запрос «qwen 3.8 max купить» на практике означает не покупку модели, а подписку на сервис, у которого она уже подключена.
Чем Qwen 3.8 Max отличается от прошлых версий
Если коротко: выросла не эрудиция, а прикладная часть. Модель стала лучше управлять компьютером, разбирать документы и доводить до конца агентные цепочки, а на вопросах общего кругозора осталась позади западных флагманов — 43,6% на Humanity's Last Exam говорят сами за себя.
Ещё одно отличие от соседей по цене касается поведения. У Grok 4.7 рассуждения отключить нельзя вообще, есть только выбор глубины. У Qwen 3.8 Max режим переключается: можно попросить ответить без раздумий, если задача простая и важна скорость. При медленной выдаче это не косметическая опция.
Что модель умеет на практике и в каких сценариях раскрывается, разобрано отдельно в статье что умеет Qwen 3.8 Max. Прямое сопоставление с моделью того же ценового класса — в материале Qwen 3.8 Max против Grok 4.7.
Как попробовать Qwen 3.8 Max
Qwen 3.8 Max заведена в каталог моделей Veruna AI — сервиса, который даёт доступ к разным нейросетям в одном чате, без VPN, без иностранной карты и с оплатой в рублях. Модель открыта на подписке Pro и выше; оформить её можно на странице тарифов.
Как именно получить доступ из России и что делать с оплатой, разобрано в отдельной статье как пользоваться Qwen 3.8 Max.
Частые вопросы
Когда вышла Qwen 3.8 Max? 3 августа 2026 года, а публичный показ был раньше — 19 июля, на конференции в Шанхае. Обновлённый снапшот 0902 вышел 2 сентября 2026 года.
Чья нейросеть Qwen? Китайская: линейку Qwen разрабатывает Alibaba, модели работают на облачной платформе компании. Qwen 3.8 Max — старшая закрытая модель линейки, доступная только по API.
Сколько параметров у Qwen 3.8 Max? 2,4 трлн всего при разреженной MoE-архитектуре и около 95 млрд активных параметров на токен. То есть при генерации ответа работает примерно двадцать пятая часть модели, а не вся сразу.
Сколько стоит Qwen 3.8 Max? В официальном API — $2 за миллион входных токенов и $6 за миллион выходных, кэшированный ввод $0,25. Наценки за длинный промпт нет: тариф одинаковый на всём окне в миллион токенов.
Чем снапшот 0902 отличается от августовской версии? Архитектура, контекст и цена те же — изменилось дообучение под код и агентные задачи. Результат на DeepSWE v1.1 вырос с 56,6% до 69,3%, на QwenSWEBench V2 — с 55,1% до 70,0%, а на лидерборде Code Arena в разделе WebDev модель вышла на первое место с 1691 баллом.
Есть ли у Qwen 3.8 Max открытые веса? У той версии, что работает в API, — нет. В августе Alibaba выложила текстовый вариант Qwen3.8-2.4T-A95B под собственной лицензией и компактную Qwen3.8-27B под Apache 2.0, но полная мультимодальная модель осталась закрытой.