
Кратко
- Главное умение Sonnet 5.5 — чётко поставленная работа: код по описанию, исправление багов, документы, таблицы и слайды. Здесь она почти вровень с вдвое более дорогой Opus 5.5.
- В работе внутри программ у неё 80,1% против 57,0% у Sonnet 5, на правках в редакторе кода — 55,5% против 34,1%.
- Офисная работа по оценке GDPval-AA: 1844 балла против 1846 у Opus 5.5, практически ничья.
- Слабые места задокументировала сама Anthropic: на низких уровнях модель останавливается спросить, а на высоких делает больше, чем просили, и тратит очень много токенов.
Что умеет Claude Sonnet 5.5 — или «сонет 5.5», как её уже ищут в рунете, — если отбросить релизные формулировки? Почти всё, что умеет Opus 5.5, если задача понятна и у неё есть рамка. Anthropic сама так её и позиционирует — модель для повседневной работы, багов и аккуратных документов, а не для долгих размышлений без ориентиров. Ниже — цифры, отзывы ранних тестировщиков и раздел документации, где Anthropic перечисляет, что у модели идёт не так. Про дату выхода, прайс и паспорт мы писали отдельно в материале про релиз Claude Sonnet 5.5, здесь только про умения.
Паспорт: что модель принимает и выдаёт
Контекстное окно Claude Sonnet 5.5 — 1 млн токенов, около 555 тысяч слов. Один ответ — до 128 тысяч токенов, через пакетный Batch API в бета-режиме — до 300 тысяч. Знания актуальны по июнь 2026 года. На входе модель принимает текст и изображения, в API — ещё PDF и файлы, на выходе выдаёт только текст. Генерировать картинки или видео она не умеет.
Рассуждения у неё адаптивные: модель сама решает, сколько думать, а глубину задаёт уровень effort с пятью ступенями — от low до max. В отличие от Opus 5.5, в API размышление перед ответом у Sonnet 5.5 можно выключить почти полностью, но только на уровнях до high; в чате Veruna AI модель рассуждает всегда. По классификации Anthropic это «быстрая» модель, тогда как Opus 5.5 — «средняя» по скорости.
Код: багфиксы и задачи по описанию
Самый наглядный прирост — в коде. По релизной таблице Anthropic, на правках в редакторе кода (CursorBench 4.0) Sonnet 5.5 набирает 55,5% против 34,1% у Sonnet 5 и 57,8% у Opus 5.5. CursorBench собран из неоднозначных задач на несколько файлов, взятых из реальных сессий в Cursor, и Anthropic отмечает: даже на самом низком уровне рассуждений Sonnet 5.5 превышает лучший результат Sonnet 5 меньше чем за десятую долю цены задачи.
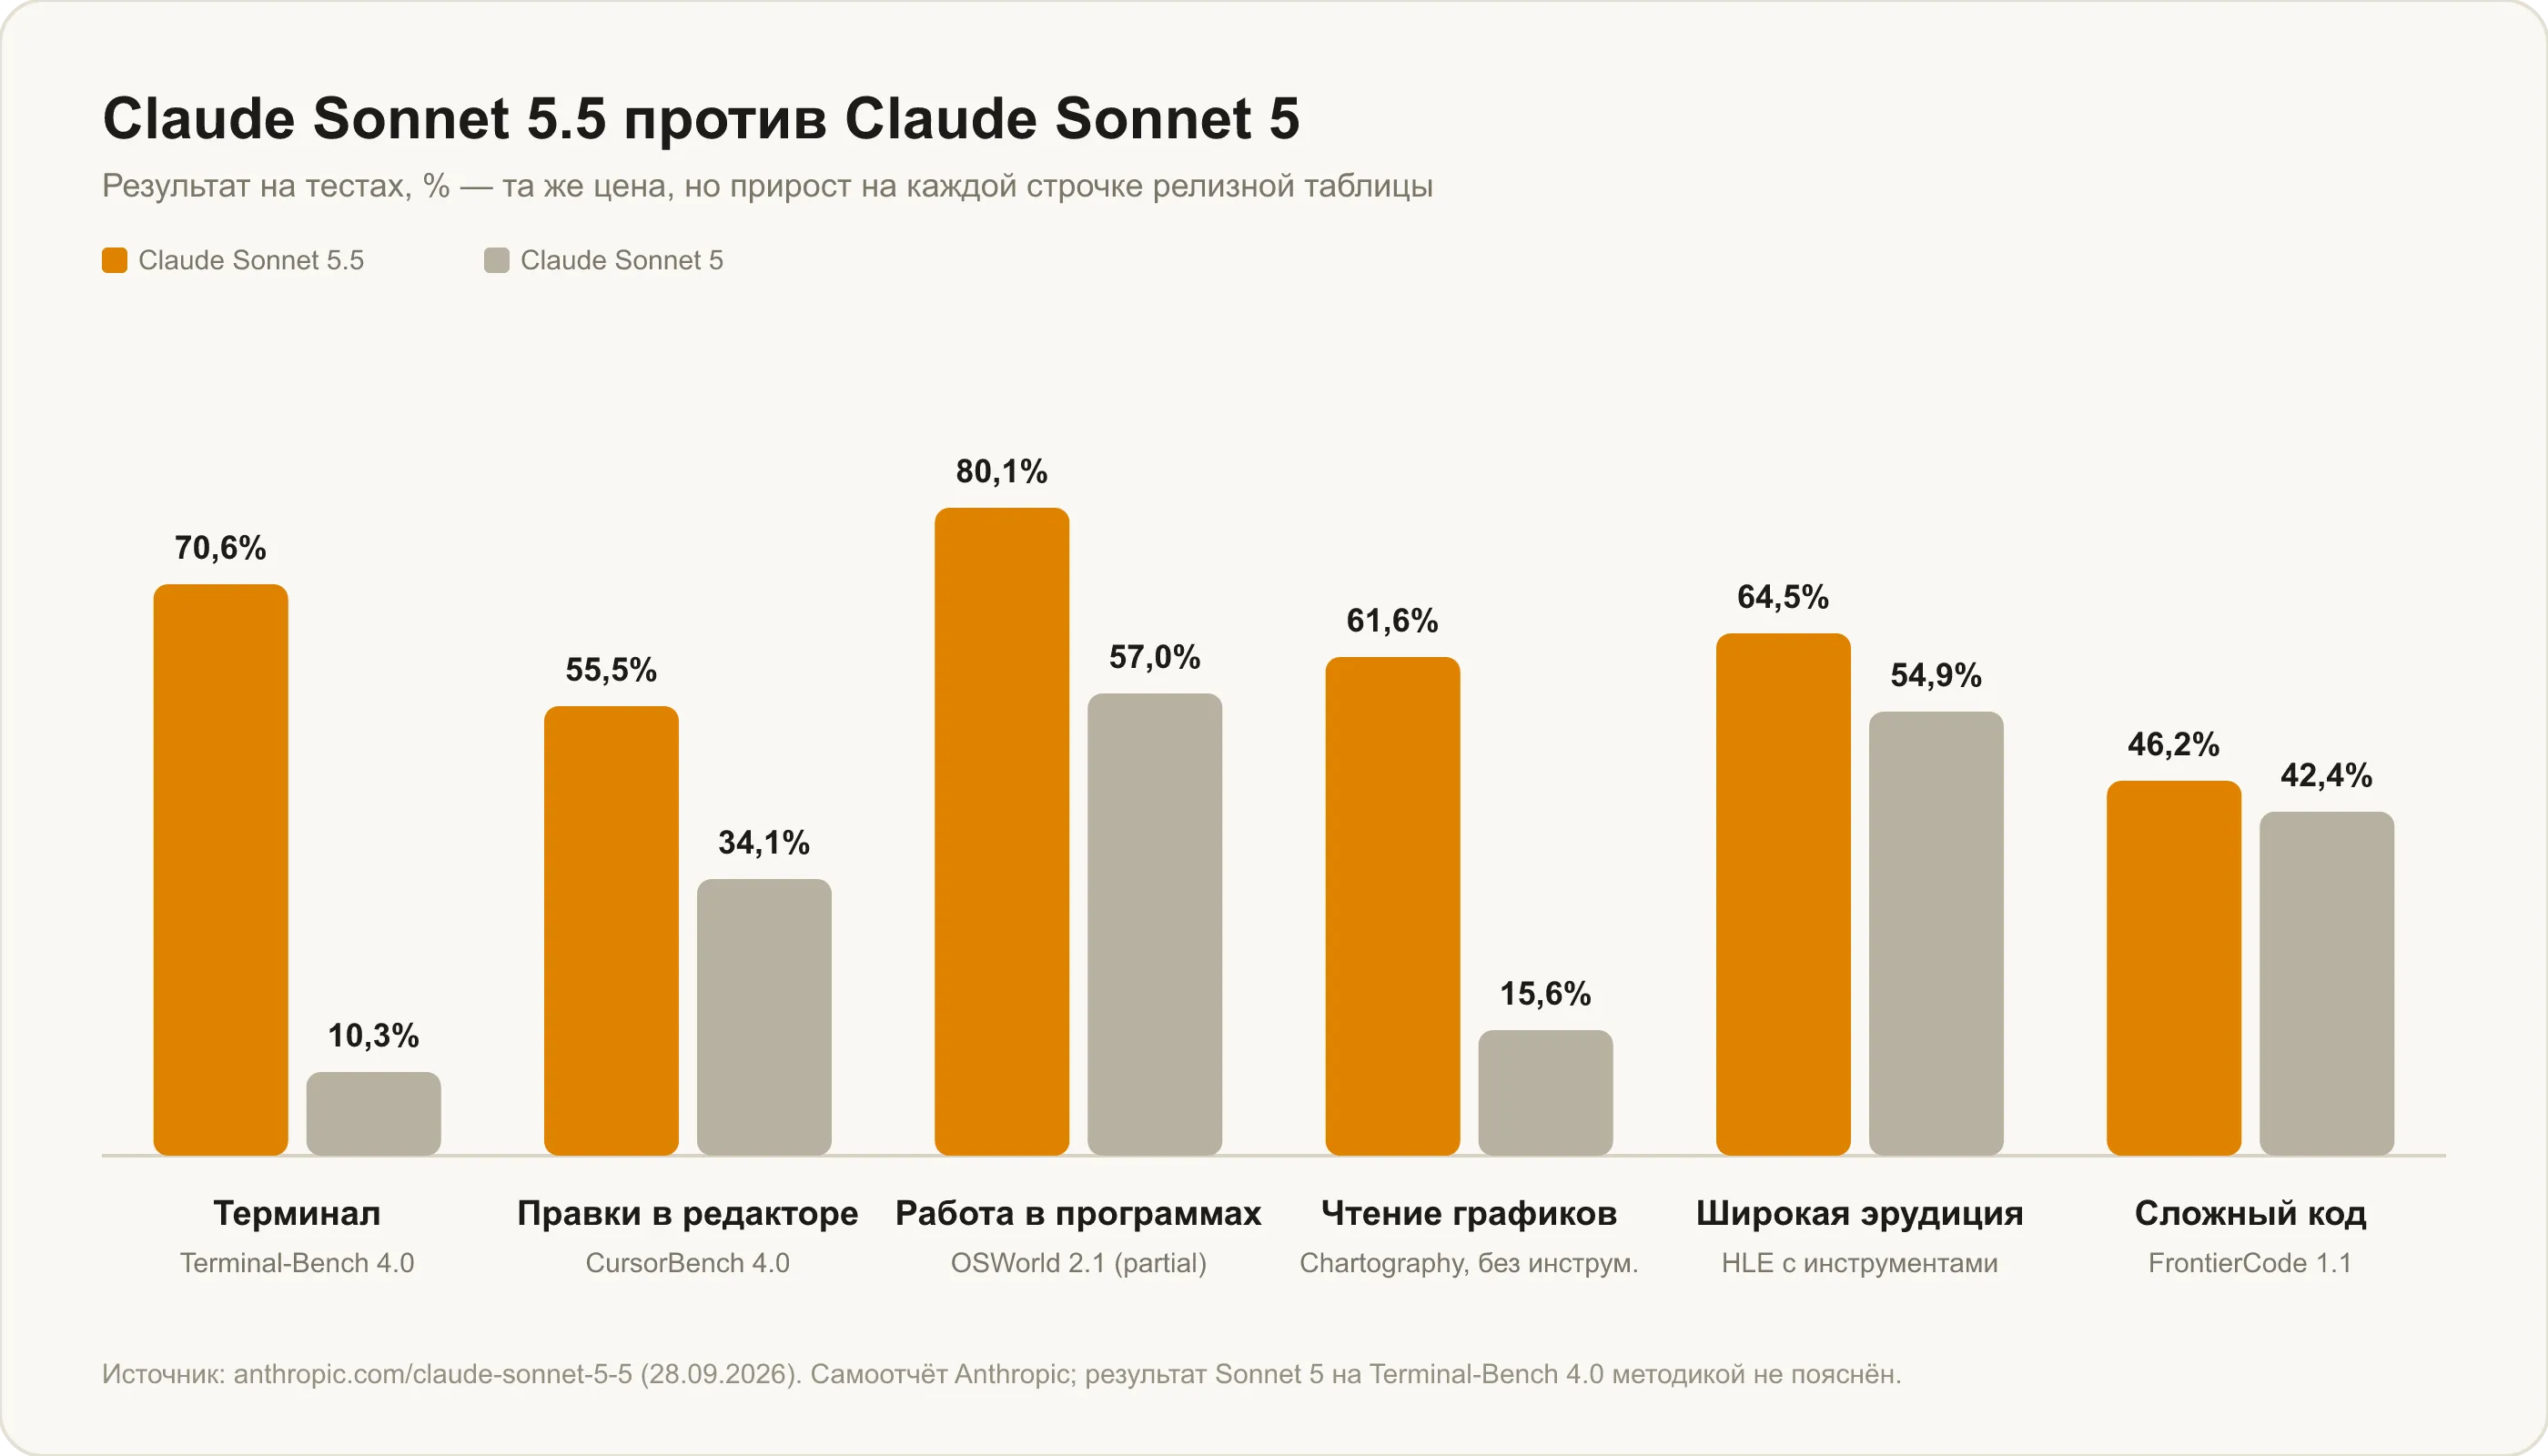
В работе в терминале (Terminal-Bench 4.0) у модели 70,6% — выше, чем у Opus 5.5 с её 66,4%. На сложных задачах по коду (FrontierCode 1.1) разрыв обратный: 46,2% у Sonnet 5.5 против 54,4% у Opus 5.5. Эти две строчки хорошо описывают модель. Где задача распадается на понятные шаги, Sonnet 5.5 быстра и точна. Где нужно долго держать в голове сложную конструкцию, флагман пока сильнее.
Отзывы ранних тестировщиков в анонсе — про то же. В CodeRabbit говорят, что модель рассуждает разумнее Sonnet 5 на задачах разной сложности и при этом тратит заметно меньше выходных токенов. Base44 прогнала 118 реальных сборок приложений: результат получился на уровне Opus 5. Lovable пишет, что модель думает меньшим числом более надёжных шагов, поэтому прогресс виден быстрее. А разработчик игр из Creator предложил разделение труда, которое стоит запомнить: архитектуру и каркас задаёт Opus 5.5, а реализацию можно спокойно отдать Sonnet 5.5.
Офисная работа: документы, таблицы, слайды
Вторая заявленная область — то, что Anthropic называет «аккуратными документами, слайдами и таблицами». Здесь самые неожиданные цифры. На GDPval-AA — оценке задач из 44 профессий — у Sonnet 5.5 рейтинг 1844 против 1846 у Opus 5.5 и 1449 у Sonnet 5. На работе с документами (AA-Briefcase) — 1811 против 1822 и 1359.
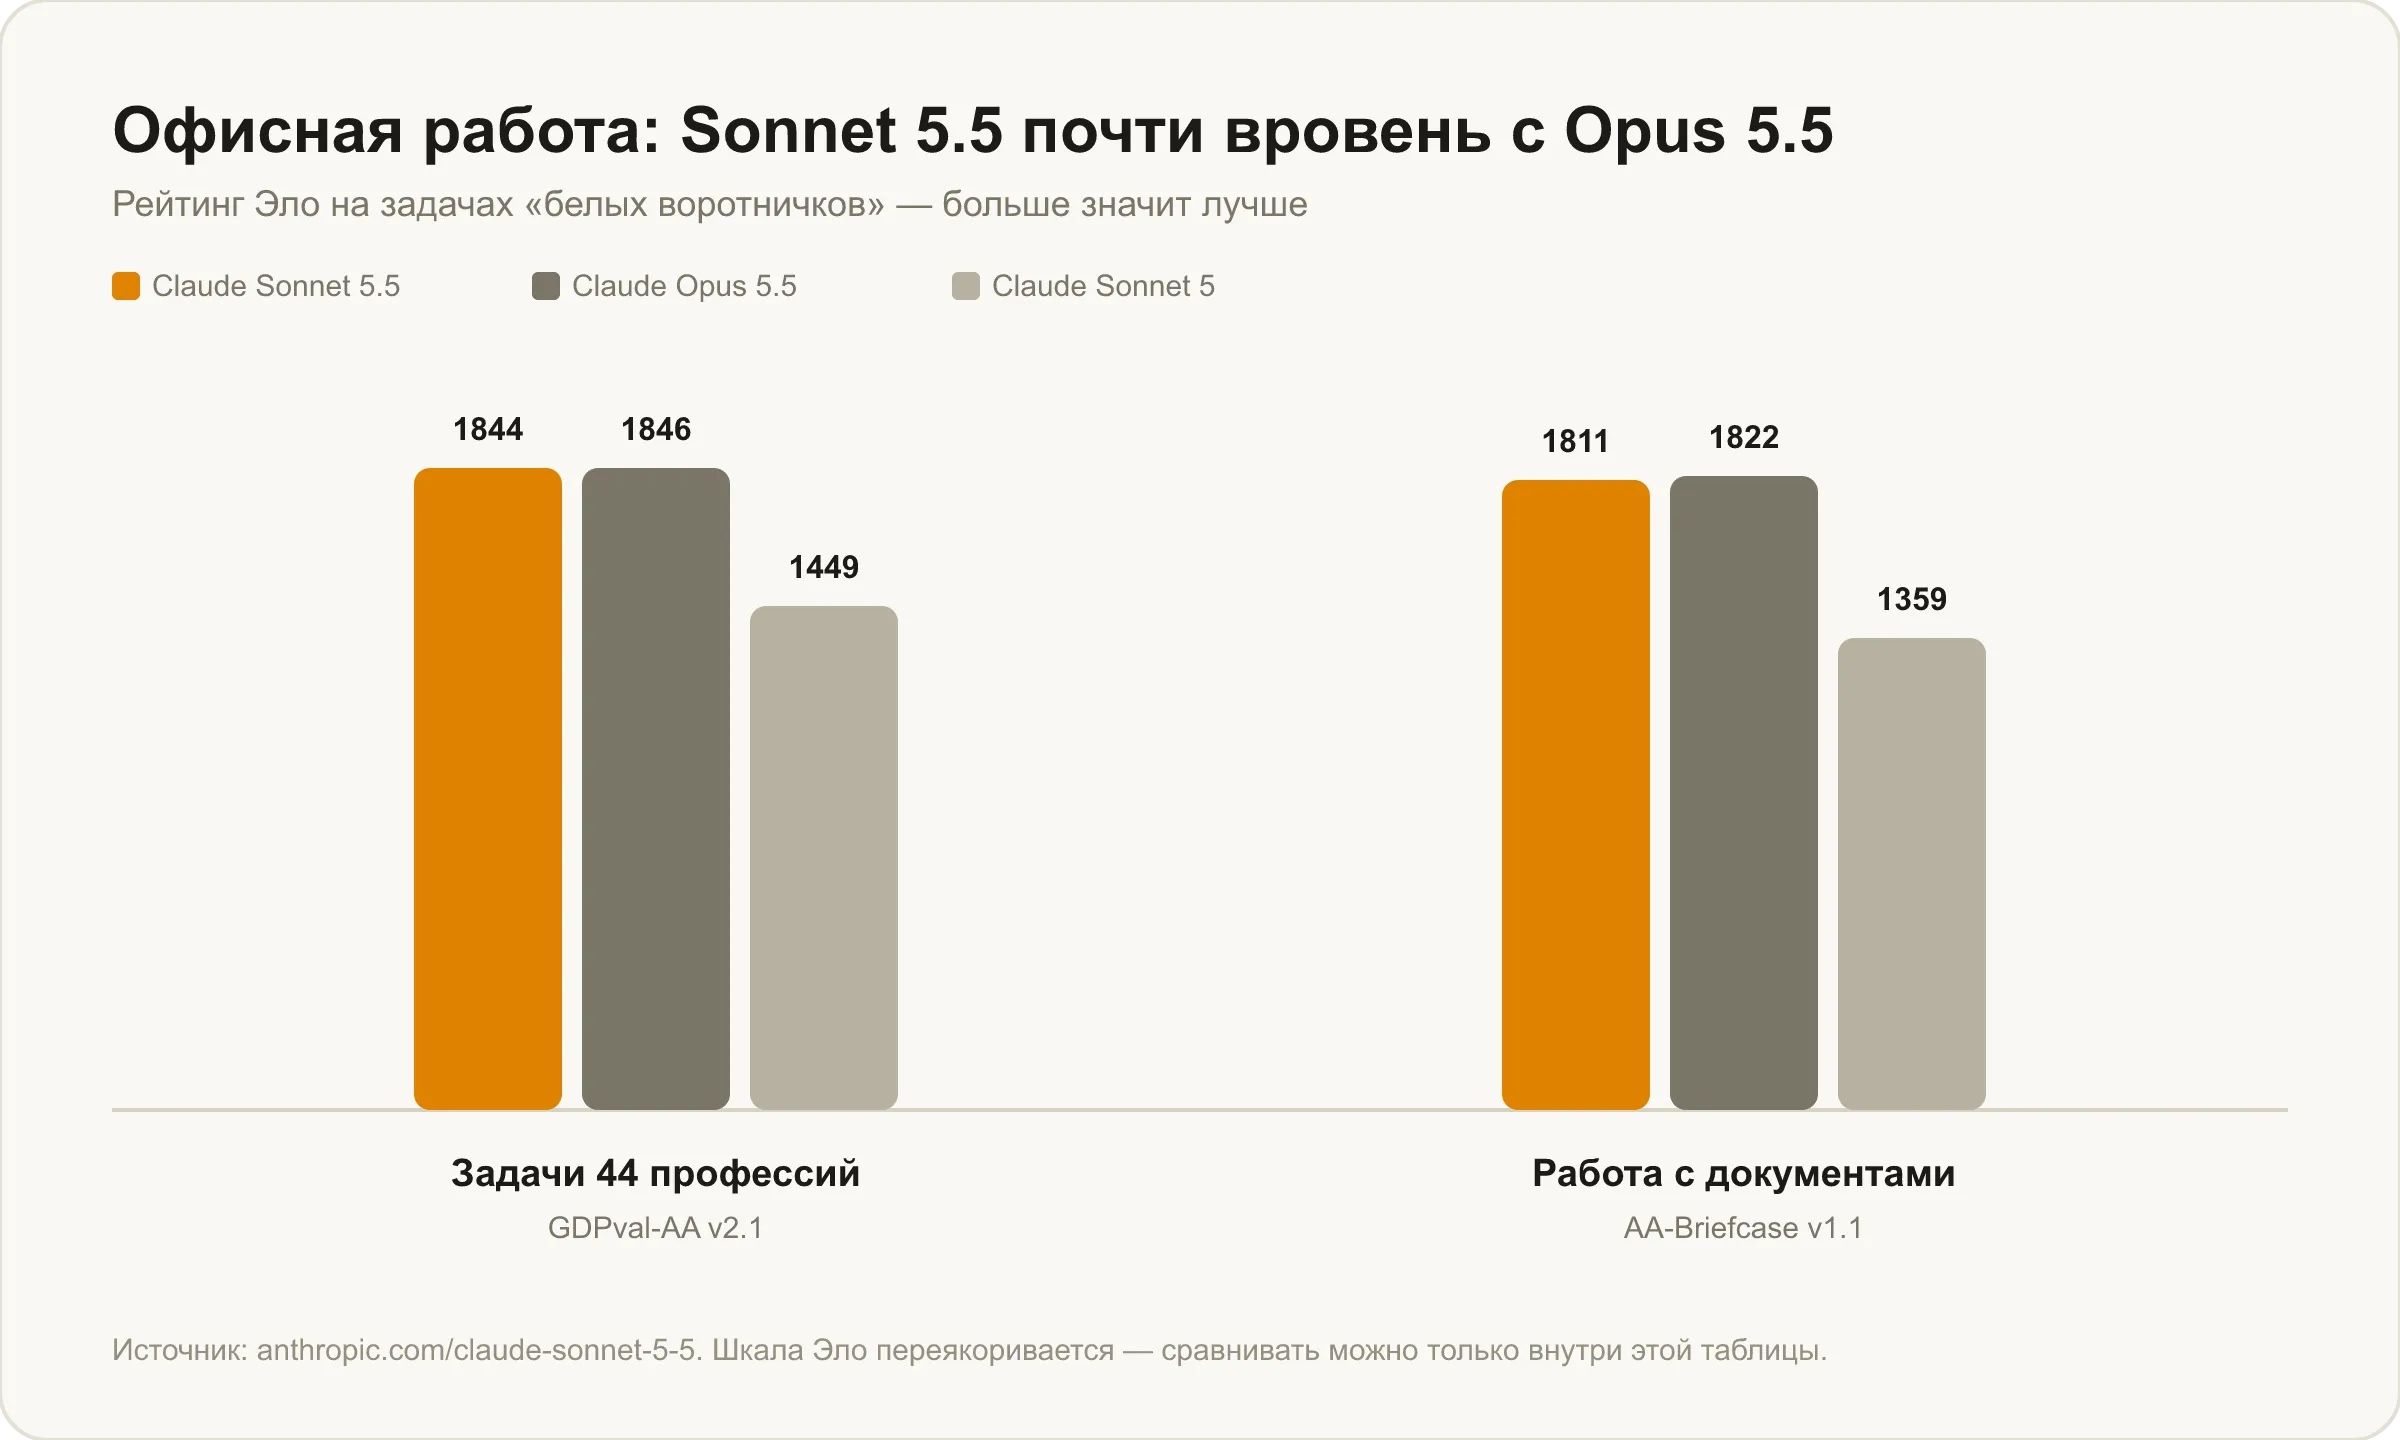
Шкала здесь — рейтинг Эло, и он переякоривается со временем, поэтому сравнивать эти числа можно только внутри одной таблицы, а не с цифрами из прошлых релизов. Но внутри таблицы картина однозначная: на офисных задачах разница с флагманом в пределах пары пунктов.
Из отзывов тестировщиков сюда подходят три. Box отмечает, что Sonnet 5.5 перепроверяет данные по исходным документам и ловит ошибки, которые Sonnet 5 пропускала. В Zendesk обращения в поддержку стали обрабатываться на 20% быстрее. Slack без единой правки промптов получил на Sonnet 5.5 результат лучше, чем на Sonnet 5, почти на всех своих внутренних тестах бота.
Работа в программах и картинки
В самостоятельной работе внутри интерфейсов программ (OSWorld 2.1 в варианте partial) у Sonnet 5.5 80,1% против 57,0% у Sonnet 5 и 81,8% у Opus 5.5. Это задачи, где модель видит экран и сама нажимает кнопки, заполняет поля и переключается между окнами. Самая забавная иллюстрация из анонса: Sonnet 5.5 стала первой моделью Sonnet, которая прошла Pokémon Red, глядя только на скриншоты.
С картинками прирост ещё заметнее. На чтении графиков без вспомогательных инструментов (Chartography) у неё 61,6% против 15,6% у Sonnet 5 и 64,4% у Opus 5.5. В руководстве по промптам Anthropic добавляет практичный совет: для плотных графиков и технических чертежей дайте модели возможность увеличить или вырезать фрагмент. С таким инструментом на уровне high она читала графики точнее, чем без него на max, и за малую долю цены.
Скорость и расход
Anthropic заявляет, что Sonnet 5.5 генерирует ответы более чем на 30% быстрее Sonnet 5, а задача обходится до 30% дешевле — меньше токенов, меньше вызовов инструментов. Atlassian пишет, что агенты Rovo на ней работают до 30% быстрее. Цена в API при этом та же: $2 и $10 за миллион токенов, вдвое дешевле Opus 5.5.
Но у экономии есть граница, и её показал независимый замер. По данным Artificial Analysis, на максимальном уровне рассуждений Sonnet 5.5 тратит около 193 тысяч выходных токенов на одну задачу их индекса. Это рекорд среди всех измеренных моделей и примерно на 60% больше, чем у Opus 5.5. Задача на max обходится в $7,60 — на 50% дороже, чем у Sonnet 5. То есть «до 30% дешевле» относится к умеренным уровням, а максимум у этой модели — дорогое удовольствие.
Где Sonnet 5.5 подводит
Независимая картина пока ограничена одним замером Artificial Analysis. Зато в документации по промптам Anthropic сама перечисляет, что у модели идёт не так.
На низких уровнях она останавливается спросить. На длинной задаче по коду на уровнях low и medium модель иногда сверяется с пользователем до того, как закончит: просит подтвердить план, задаёт вопрос, на который могла бы ответить сама, или останавливается после первой части. Человек в чате скажет «продолжай», а автоматический агент встанет.
На низком уровне может не проверить свою работу. На low модель иногда объявляет правку готовой, не запустив тесты, например потому, что зависимости проекта не установлены.
Она делает больше, чем просили. На любом уровне, и сильнее на высоких, модель склонна дописывать тесты, документацию и вспомогательные файлы. На xhigh и max после готовой задачи она может начать собственные круги проверки. На открытый запрос вроде «покажи, что тут можно сделать» иногда принимается строить отчёт или презентацию, хотя от неё ждали только идей.
Иногда отвечает по памяти, а не по поиску. В чате и в задачах с документами модель порой полагается на знания из обучения там, где поиск поймал бы изменившиеся детали — цены, правила, требования. Anthropic советует прямо просить её сверяться с поиском.
Подозрительна к сообщениям посреди задачи. Модель обучена сопротивляться внедрённым командам, и иногда принимает настоящее сообщение пользователя, пришедшее в середине работы, за попытку подмены.
Новые отказы. Запросы, которые просят выписать ход мыслей прямо в ответ, могут вернуться отказом. Рискованные запросы по кибербезопасности заметно для пользователя уходят на Sonnet 5.
Для каких задач Sonnet 5.5 подходит, а для каких лучше Opus
Sonnet 5.5 стоит брать туда, где задача поставлена чётко: исправить баг, реализовать функцию по описанию, собрать отчёт, таблицу или презентацию, разобрать документ с графиками, пройти сценарий в интерфейсе программы. На таких задачах она почти не уступает флагману и вдвое дешевле его.
Opus 5.5 остаётся за работой без ясной рамки: многочасовые самостоятельные прогоны по большой кодовой базе, архитектурные решения, сложный код, где Sonnet отстаёт на восемь пунктов. Сама Anthropic формулирует это так: для самой тяжёлой работы на длинной дистанции лучше подходит Opus. Возможности флагмана мы разбирали в статье что умеет Claude Opus 5.5, а прямое сравнение двух моделей — в материале Sonnet 5.5 или Opus 5.5.
Как попробовать Claude Sonnet 5.5 в Veruna AI
Claude Sonnet 5.5 подключена в Veruna AI и открыта на подписке Max — условия на странице тарифов. Без VPN и без иностранной карты, оплата в рублях. Как устроен доступ из России, подробно описано в статье как пользоваться Claude Sonnet 5.5.
Формат платформы тут кстати: модели переключаются в одном окне. Можно дать одну и ту же задачу Sonnet 5.5, Opus 5.5 и Sonnet 5 и сравнить ответы рядом. Глубину рассуждений задаёт селектор в чате: у Sonnet 5.5 там три уровня — низкий (по умолчанию), средний и высокий. Выключить рассуждения нельзя, модель думает всегда. Для повседневных задач хватает низкого, а с учётом слабых мест выше: если модель на длинной задаче по коду останавливается спросить или не проверяет правку, поднимите уровень.
Короткие сценарии
Исправление бага. Ровно то, под что Anthropic выпускала модель: вставьте код и ошибку, попросите найти причину и проверить правку.
Отчёт или таблица по исходникам. Модель перепроверяет цифры по документам — на этом её отдельно хвалит Box.
Разбор графика или скриншота. Чтение графиков без инструментов выросло с 15,6% до 61,6%; для плотных диаграмм помогает приложить увеличенный фрагмент.
Большой рефакторинг на часы. Лучше Opus 5.5 или связка: план от Opus, реализация от Sonnet.
Частые вопросы
Что умеет Claude Sonnet 5.5? Писать и исправлять код по описанию, работать в терминале и в интерфейсах программ, собирать документы, таблицы и презентации, читать графики, схемы и скриншоты, держать в контексте документ до миллиона токенов. На входе текст, изображения и файлы, на выходе только текст.
Чем возможности Sonnet 5.5 отличаются от Sonnet 5? CursorBench 4.0 — 55,5% против 34,1%, OSWorld 2.1 — 80,1% против 57,0%, чтение графиков без инструментов — 61,6% против 15,6%, GDPval-AA — 1844 против 1449. По заявлению Anthropic, ответы ещё и более чем на 30% быстрее.
Sonnet 5.5 подходит для программирования? Да, это её основная специализация. На правках в редакторе кода она почти вровень с Opus 5.5 (55,5% против 57,8%), в терминале впереди (70,6% против 66,4%). На сложных задачах по коду Opus 5.5 сильнее: 54,4% против 46,2%.
Где Claude Sonnet 5.5 подводит? На низких уровнях рассуждений модель может остановиться посреди задачи и не проверить свою правку, на высоких — дописать лишнее и потратить очень много токенов: на max около 193 тысяч на задачу. Иногда отвечает по памяти там, где нужен поиск.
Умеет ли Sonnet 5.5 генерировать картинки? Нет. Модель принимает изображения на вход и описывает их, но на выходе выдаёт только текст. Для генерации картинок в Veruna AI есть отдельные модели в том же каталоге.