
Кратко
- Sonnet 5.5 вдвое дешевле Opus 5.5: $2 и $10 за миллион токенов против $4 и $20. Чтение из кэша у обеих стоит одинаково — $0,20.
- В релизной таблице Anthropic разница между ними — от одного до трёх пунктов на большинстве тестов. Sonnet впереди только в терминале: 70,6% против 66,4%.
- Где Opus заметно сильнее — сложный код: 54,4% против 46,2%. И независимый индекс Artificial Analysis: 58 баллов против 56.
- Ловушка одна: на максимальном уровне рассуждений Sonnet 5.5 тратит примерно на 60% больше токенов, чем Opus, и экономия может исчезнуть.
«Sonnet или Opus» — вопрос, который пользователи Claude задают с каждым поколением, и в рунете он звучит так же: «опус или сонет», «opus или sonnet». С Claude Sonnet 5.5 и Claude Opus 5.5 ответ стал менее очевидным, чем обычно. Модели вышли с разницей в шесть дней, младшая стоит вдвое дешевле, а в таблице отстаёт от старшей на пару пунктов. Opus от этого не стала лишней, но место, где она действительно нужна, сузилось, и найти его можно только по отдельным строчкам таблицы и по счёту за токены.
Sonnet 5.5 и Opus 5.5: что у них общего
Обе модели — из семейства Claude 5.5, вышли в сентябре 2026 года: Opus 5.5 — 22-го, Sonnet 5.5 — 28-го. Паспорт у них почти одинаковый: контекст в 1 млн токенов, ответ до 128 тысяч, до 300 тысяч через Batch API в бете, знания по июнь 2026 года. На входе текст и изображения, на выходе только текст. Обе доступны в Claude API, приложениях Claude, Amazon Bedrock, Google Cloud, Microsoft Foundry и на OpenRouter.
У обеих одинаковые ломающие изменения в API по сравнению с прошлым поколением: нельзя принудительно вызвать инструмент, блоки размышлений привязаны к модели, старый инструмент управления компьютером не принимается на Claude API и Google Cloud. Разница — в рассуждениях, скорости и цене.
Характеристики и цена: таблица
| Параметр | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Дата выхода | 28 сентября 2026 | 22 сентября 2026 |
| Идентификатор в API | claude-sonnet-5-5 | claude-opus-5-5 |
| Назначение по Anthropic | скорость и интеллект в балансе | долгая агентная работа и умственный труд |
| Скорость | «быстрая» | «средняя» |
| Рассуждения | адаптивные, можно выключить до high | адаптивные, всегда включены |
| Уровень по умолчанию в API | high | medium |
| Вход / выход, за млн | $2 / $10 | $4 / $20 |
| Чтение из кэша, за млн | $0,20 | $0,20 |
| Запись в кэш (5 мин / час) | $2,50 / $4 | $5 / $8 |
| Batch API, за млн | $1 / $5 | $2 / $10 |
| Ускоренный режим | нет | $8 / $40 |
Данные — из обзора моделей и прайса Anthropic.
Бенчмарки: где разница реальна
Удобно, что Anthropic положила обе модели в одну таблицу анонса Sonnet 5.5, так что сравнение идёт на одном стенде.
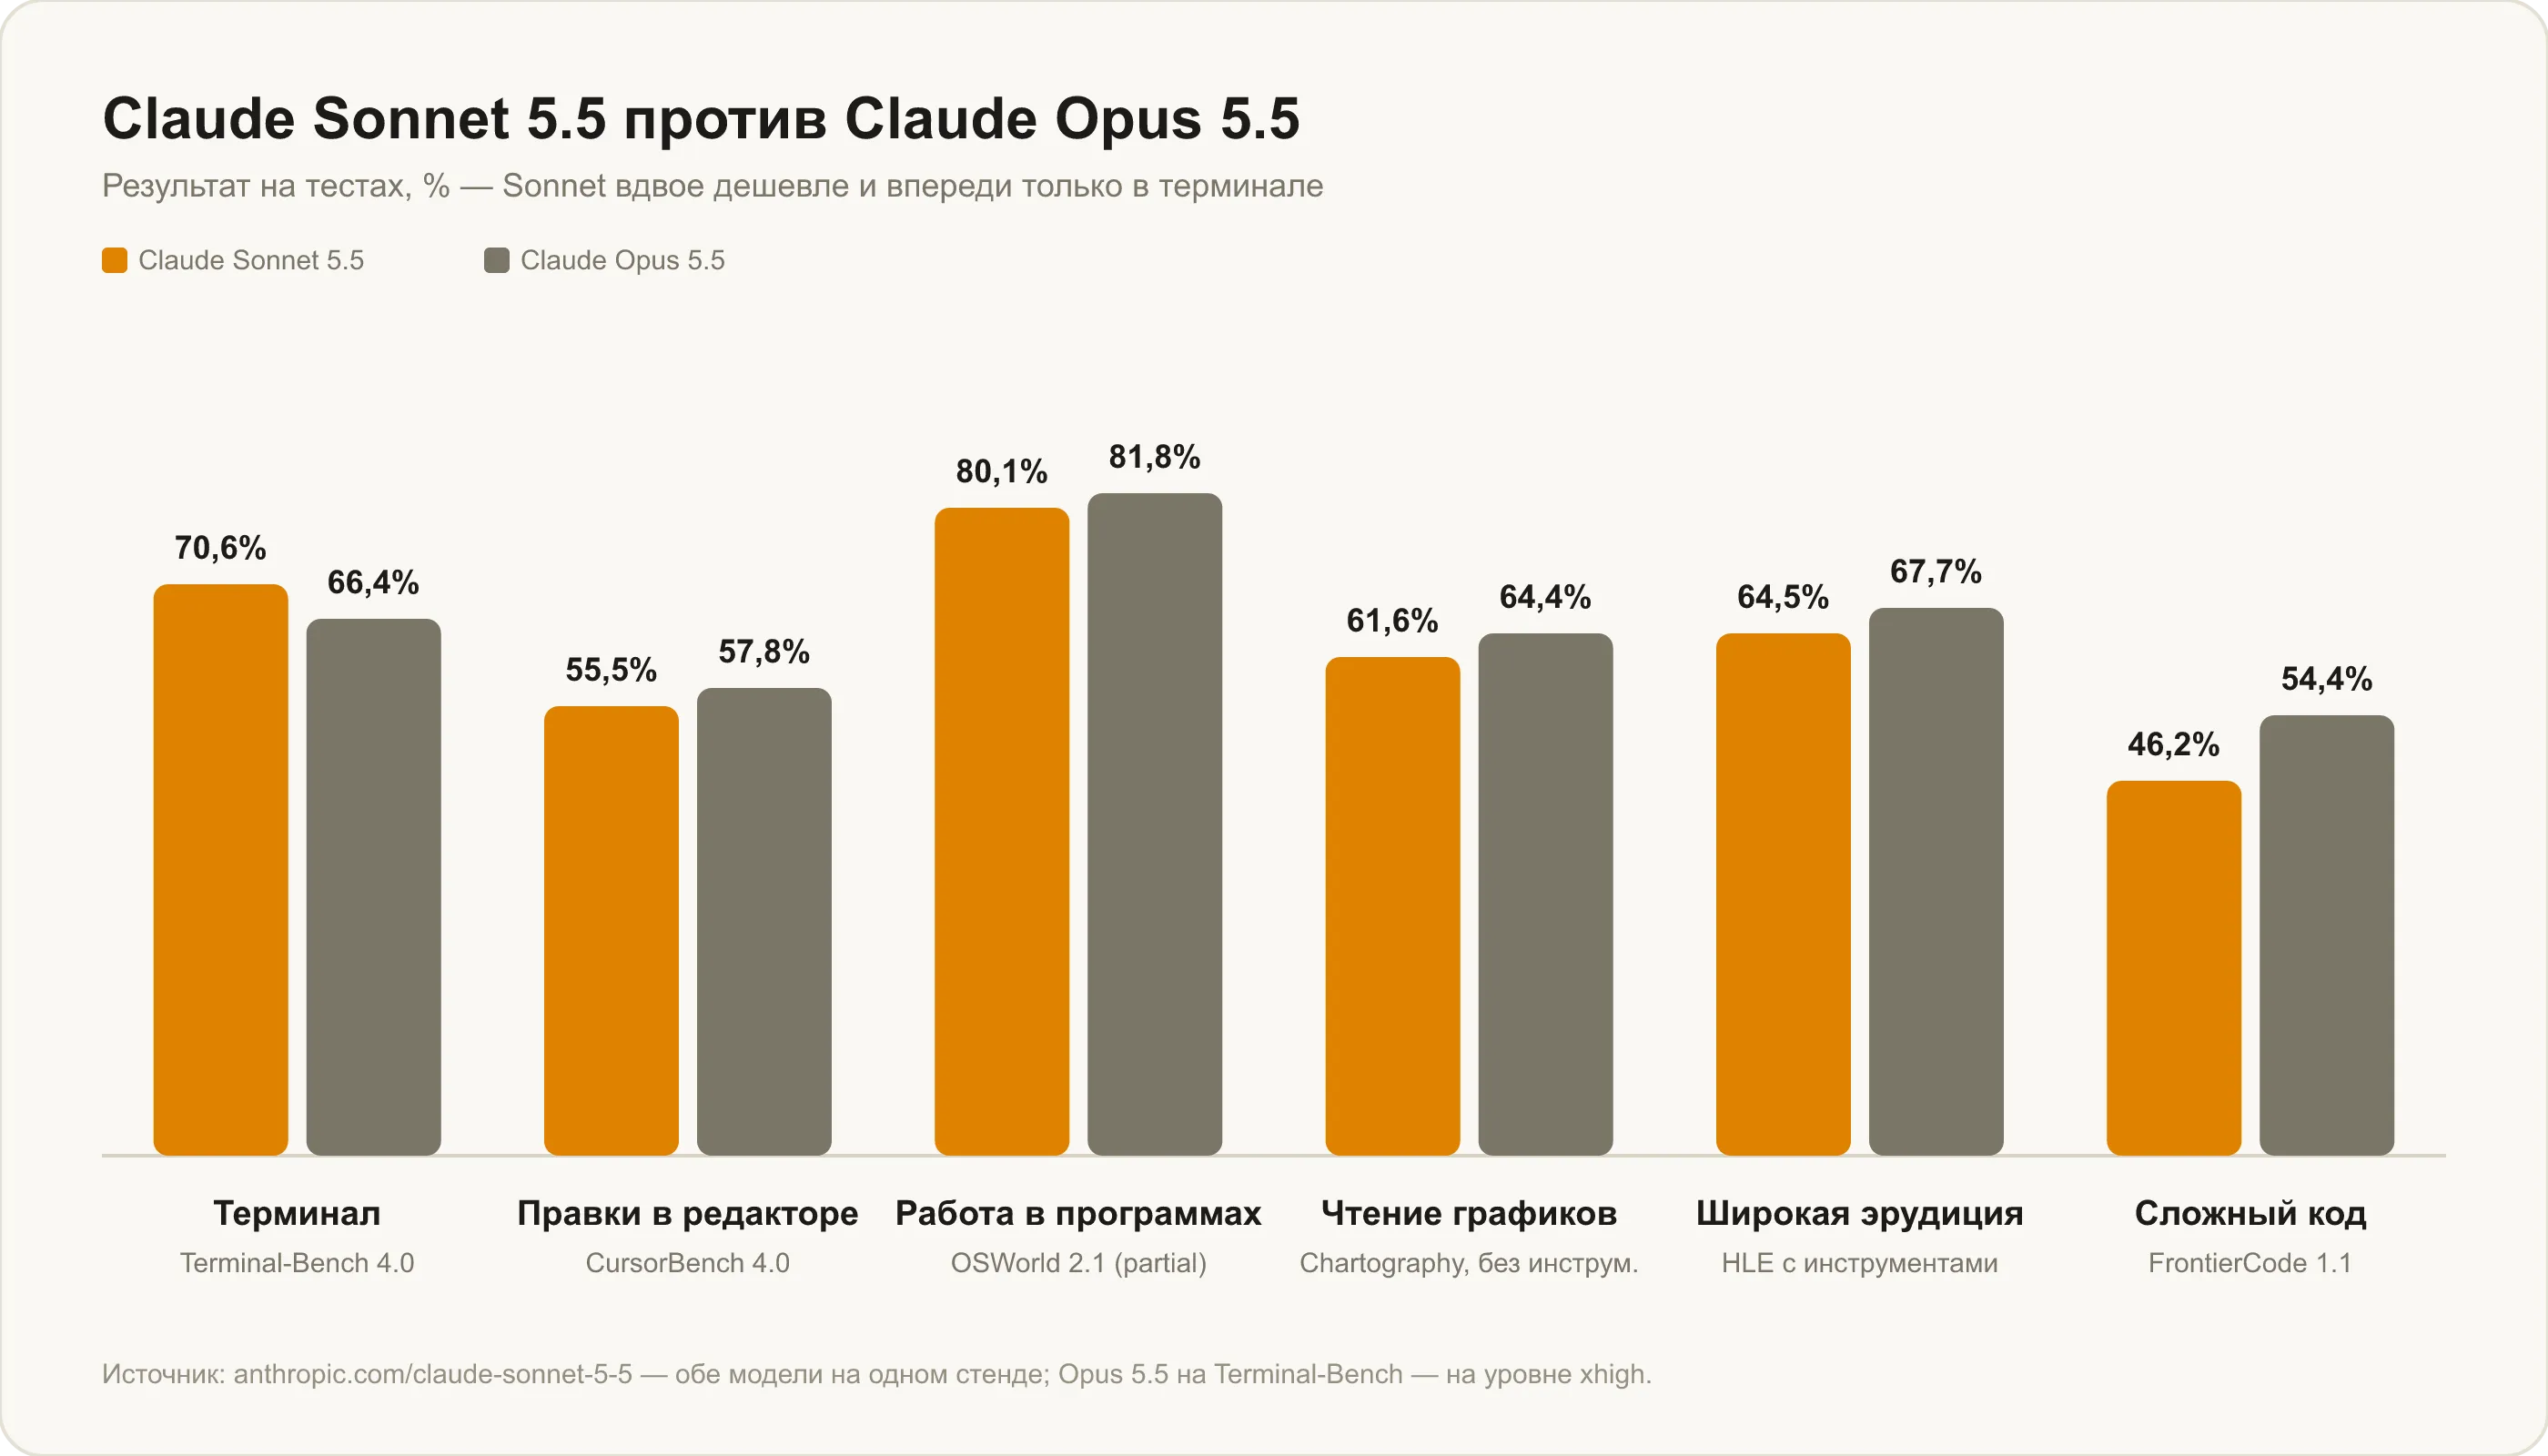
На работе в терминале (Terminal-Bench 4.0) Sonnet 5.5 впереди: 70,6% против 66,4% у Opus 5.5 на уровне xhigh. На правках в редакторе кода (CursorBench 4.0) — 55,5% против 57,8%. В работе внутри программ (OSWorld 2.1 в варианте partial) — 80,1% против 81,8%. На чтении графиков без инструментов (Chartography) — 61,6% против 64,4%. В широкой эрудиции с инструментами (Humanity's Last Exam) — 64,5% против 67,7%.
Одна строчка выбивается. На сложных задачах по коду (FrontierCode 1.1) Sonnet 5.5 набирает 46,2% против 54,4% у Opus — разрыв в восемь пунктов. Это и есть граница между моделями: где задачу нужно долго держать в голове целиком, флагман заметно сильнее.
Важная деталь для тех, кто читал наш разбор Opus 5.5. Тесты в анонсе Sonnet 5.5 частично идут в других версиях и условиях: OSWorld здесь версии 2.1 в варианте partial, а Chartography — без вспомогательных инструментов, поэтому у Opus 5.5 там 64,4%, а не 89,0%, как в её собственном релизе. Сравнивать корректно только внутри одной таблицы.
Офисная работа: практически ничья
Самое неожиданное — офисные задачи. На GDPval-AA, оценке работы по 44 профессиям, у Sonnet 5.5 рейтинг 1844, у Opus 5.5 — 1846. На работе с документами (AA-Briefcase) — 1811 против 1822. Это разница в пределах погрешности.
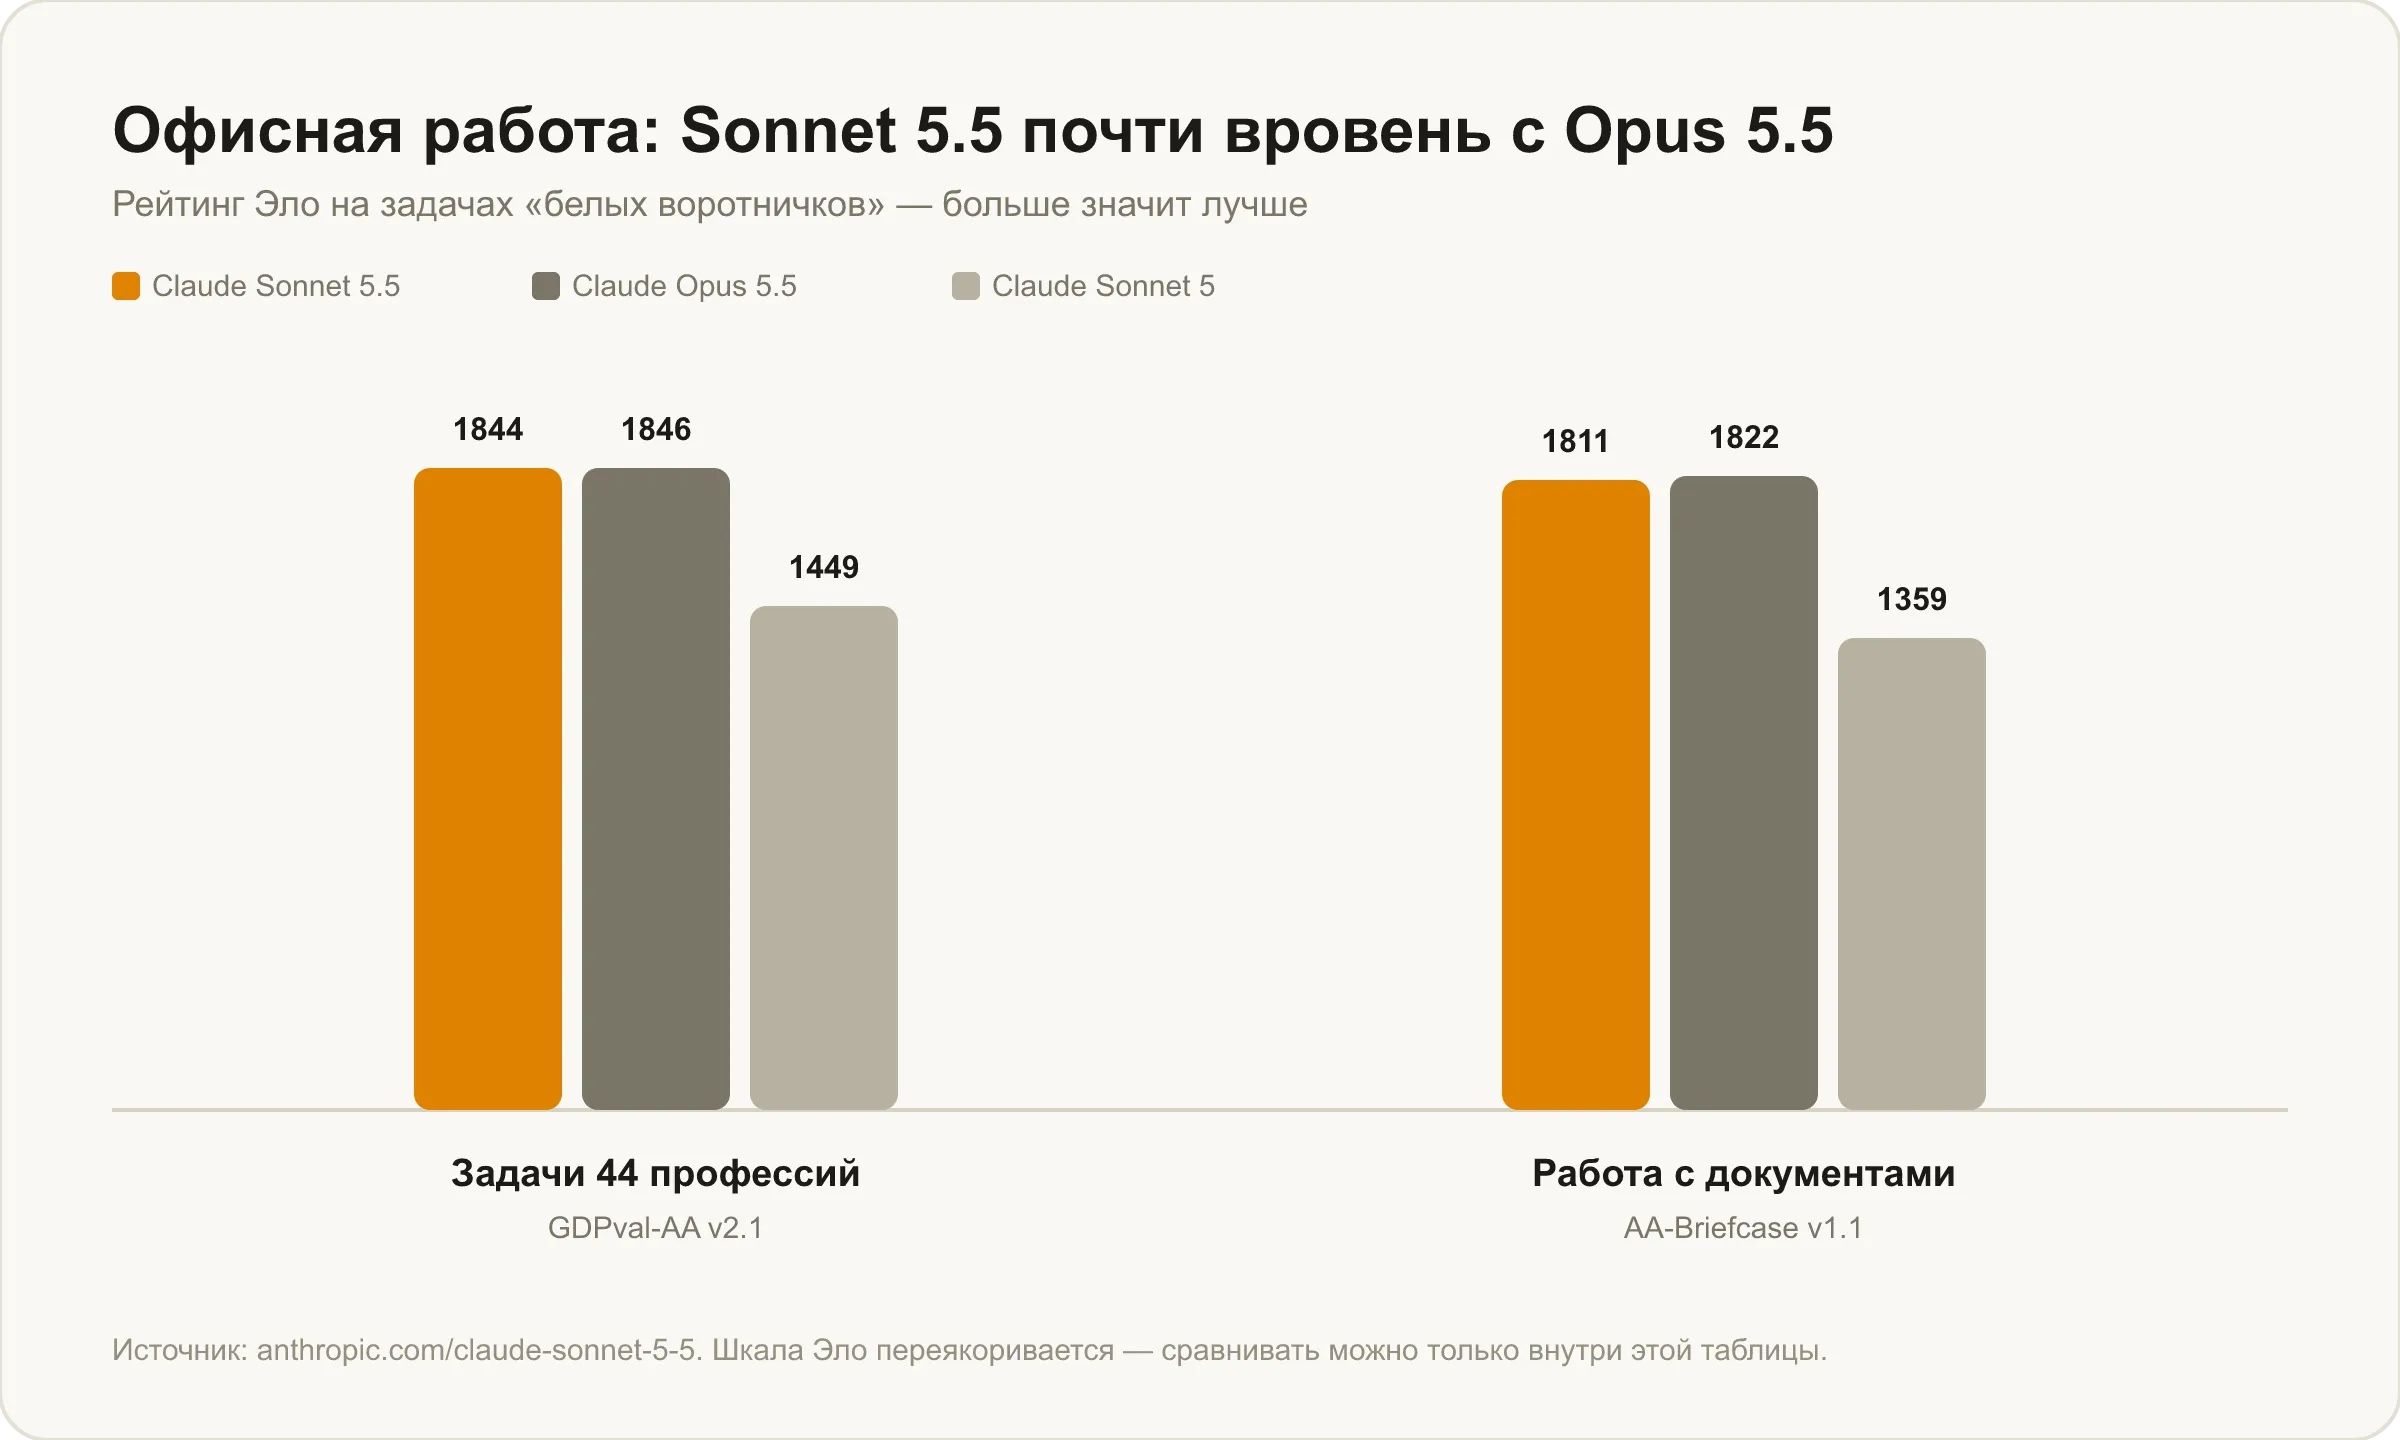
Для отчётов, таблиц, презентаций и разбора документов это главный аргумент в пользу Sonnet. Вдвое дешевле, быстрее, а по качеству разницу почти не видно.
Независимый замер: 56 против 58
У Opus 5.5 и Sonnet 5.5 есть общий независимый замер — Intelligence Index от Artificial Analysis. На максимальном уровне рассуждений Opus 5.5 набирает 58 баллов, Sonnet 5.5 — 56, второе место индекса. В работе в терминале у лаборатории вышло около 64% у Sonnet против 60% у Opus — тот же порядок, что у Anthropic, только цифры ниже.
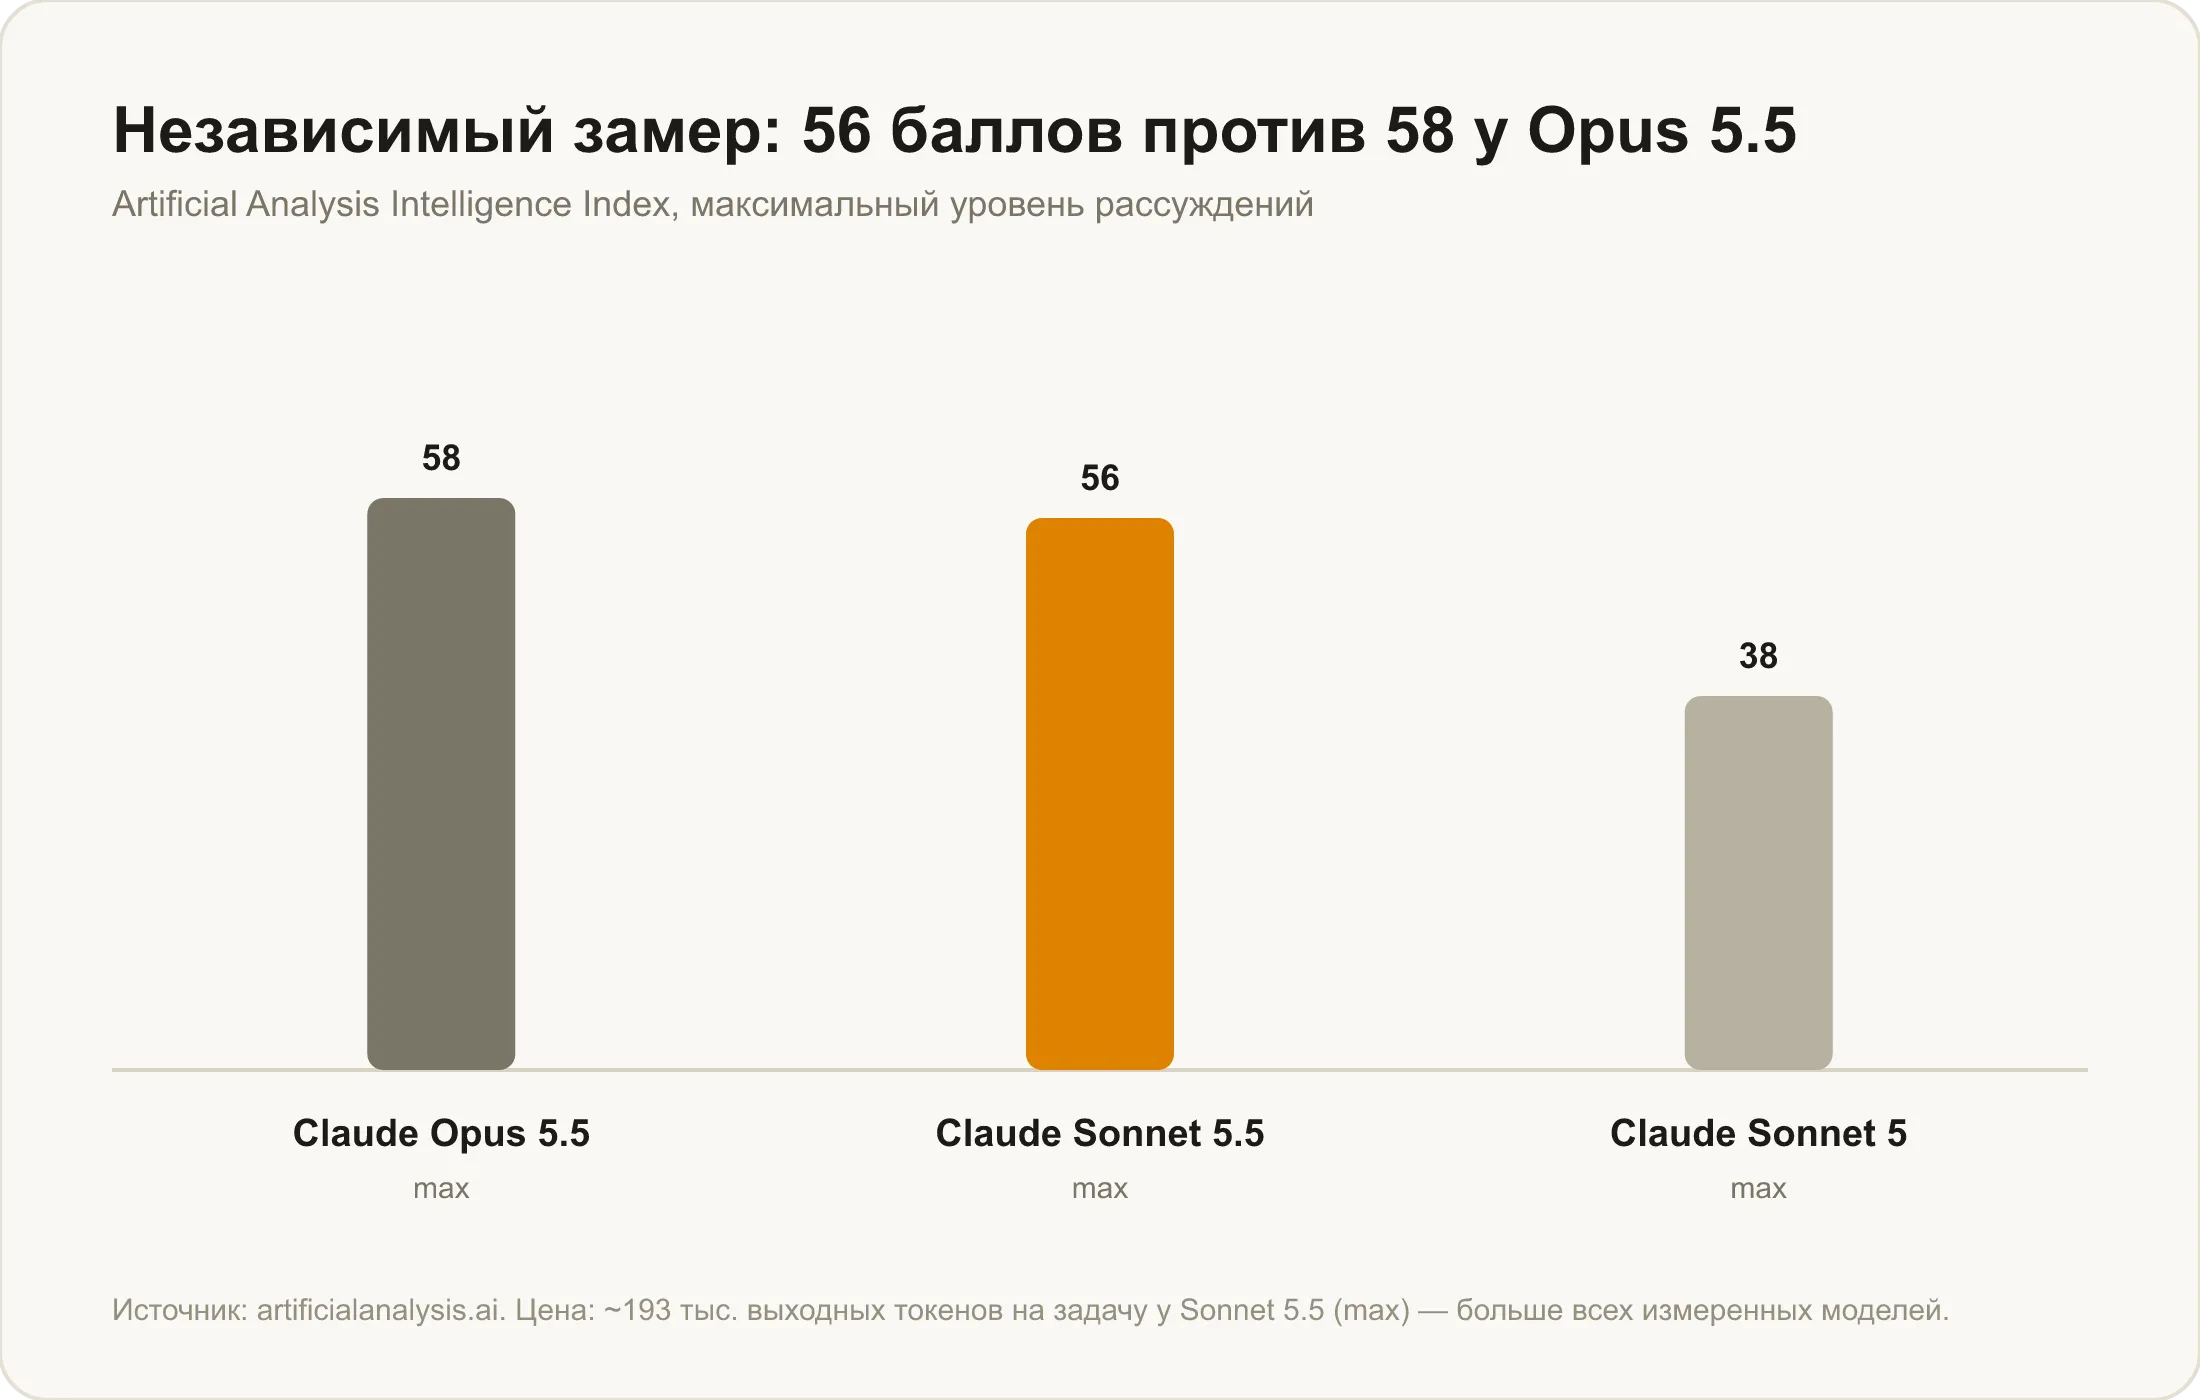
Два балла — небольшая разница. Но у этого замера есть цена, о которой ниже.
Цена: вдвое дешевле, но не всегда
По прайсу Sonnet 5.5 вдвое дешевле Opus 5.5 на входе, выходе, записи в кэш и пакетной обработке.
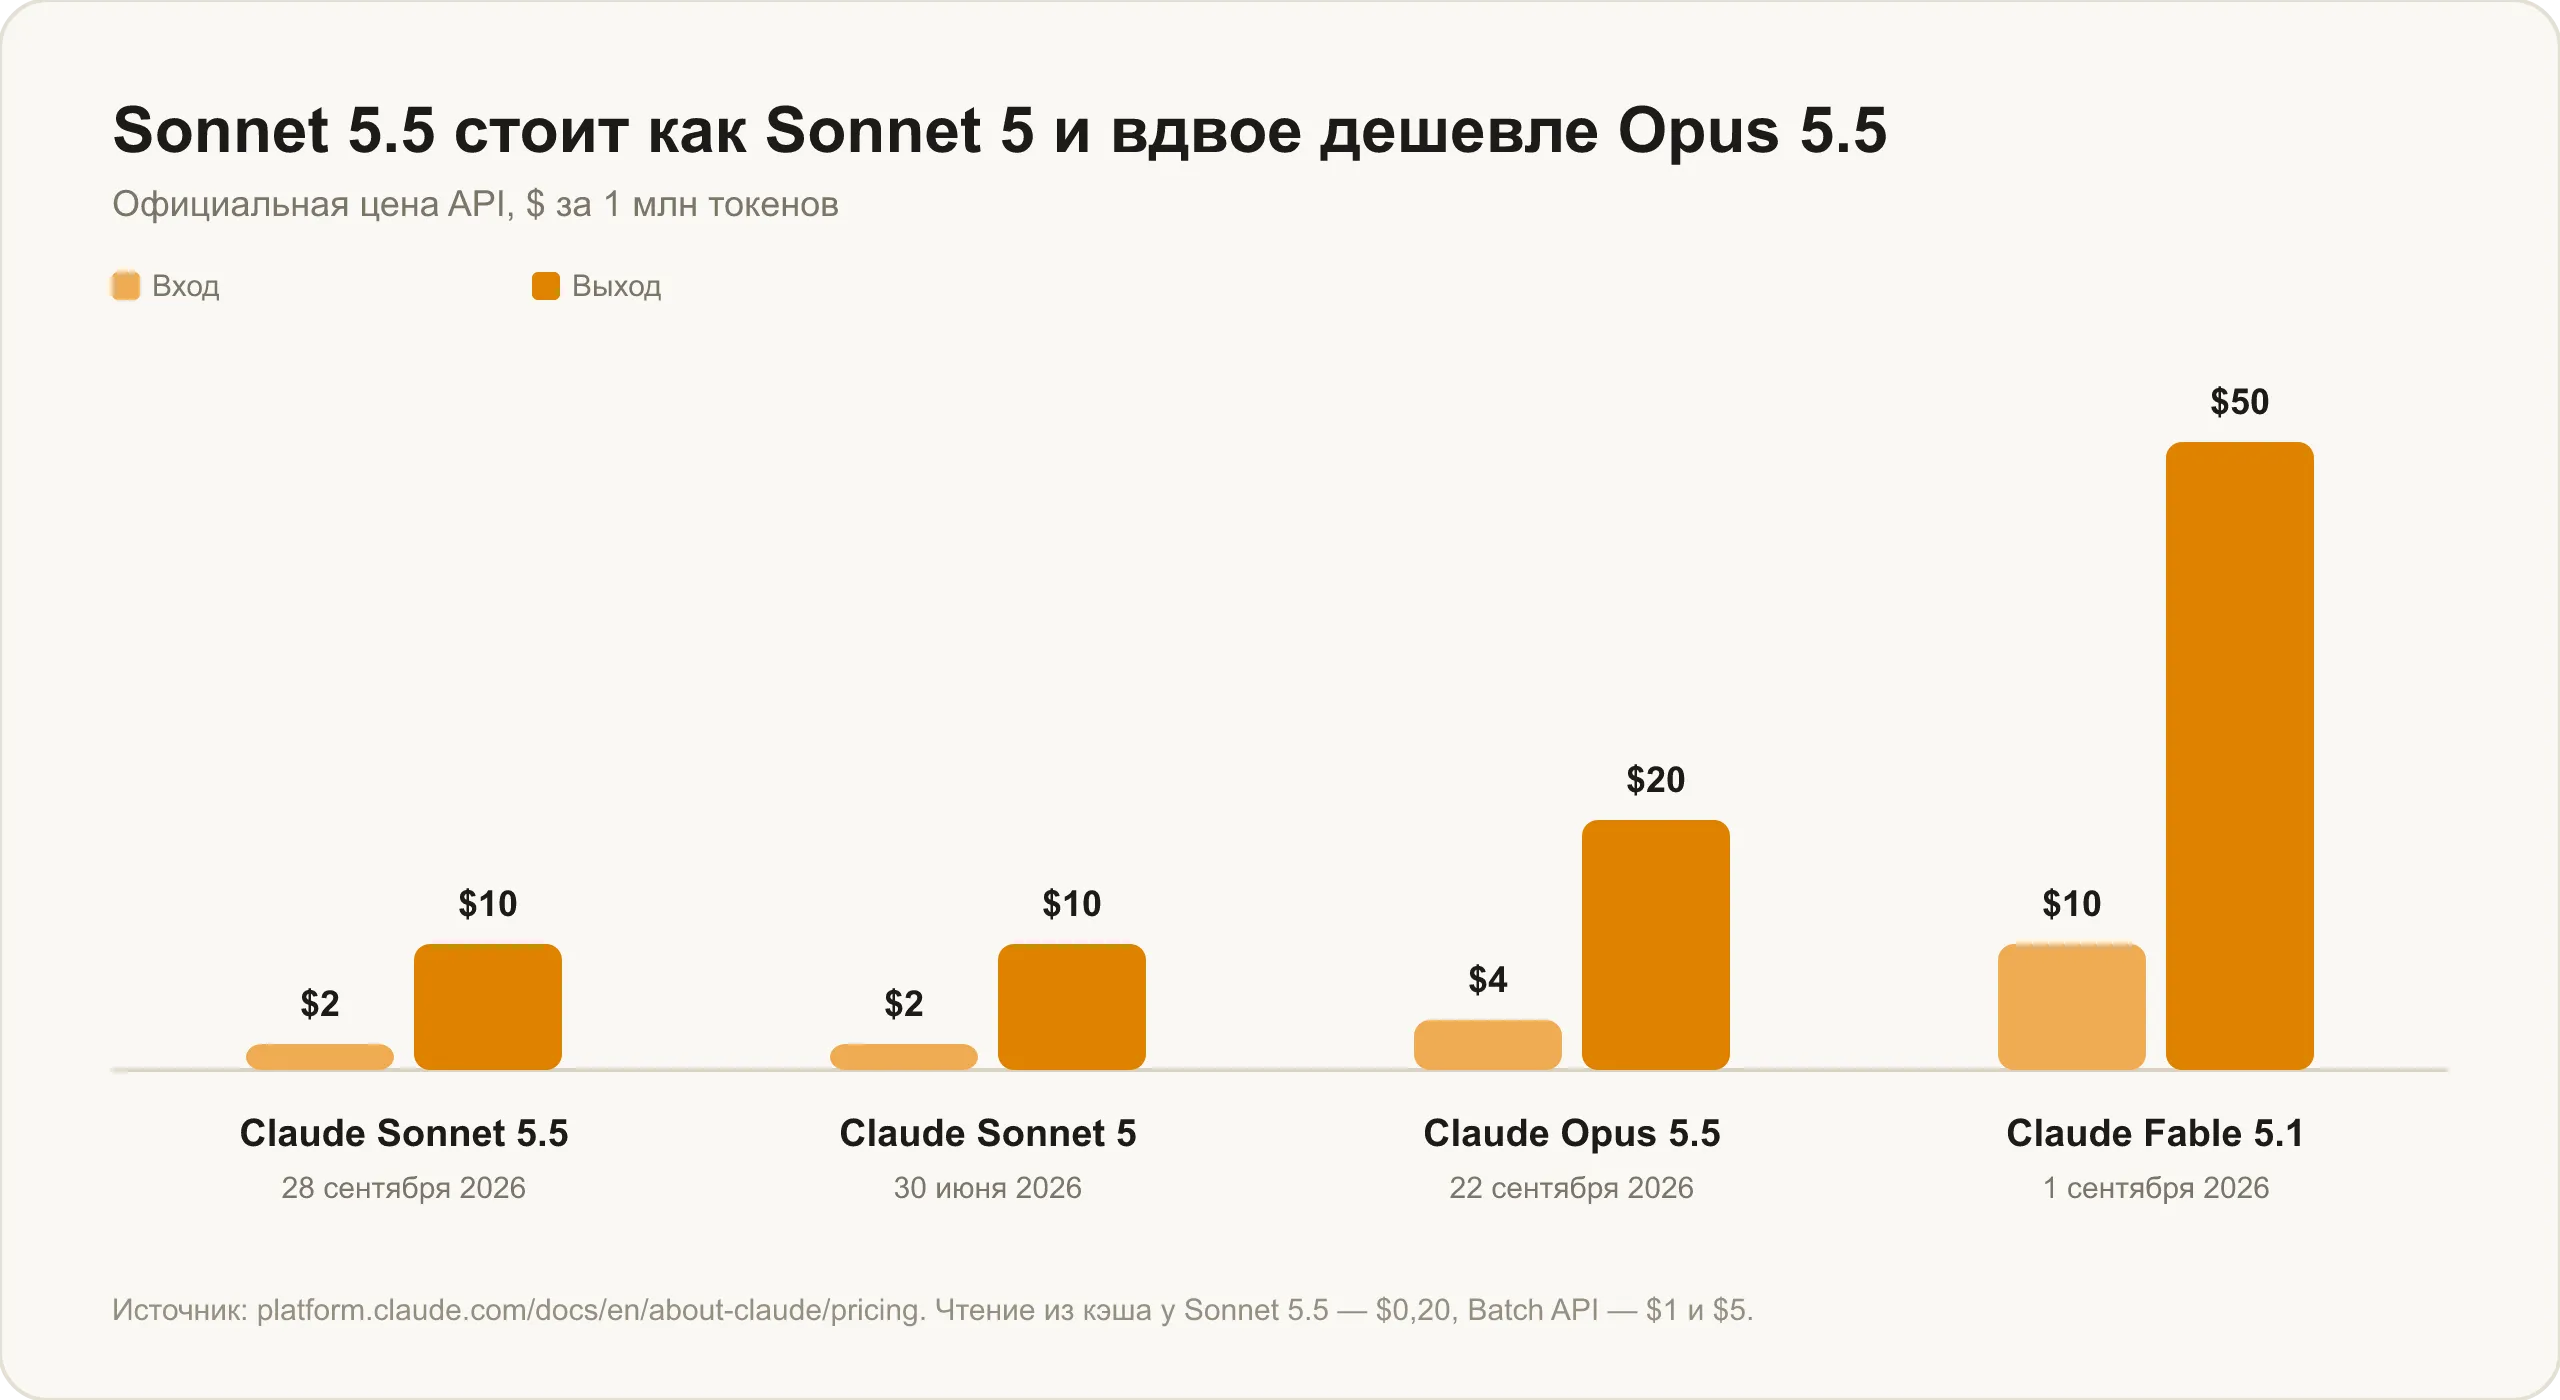
Одна позиция совпадает — чтение из кэша, $0,20 за миллион токенов у обеих. У Opus 5.5 оно стоит 5% от цены входа, у Sonnet — стандартные 10%. В длинной агентной сессии, где модель десятки раз перечитывает один и тот же большой контекст, львиную долю счёта составляет именно повторный ввод. Там разница между моделями сжимается и держится в основном на выходных токенах.
Вторая оговорка важнее. По замеру Artificial Analysis, на максимальном уровне рассуждений Sonnet 5.5 тратит около 193 тысяч выходных токенов на одну задачу — примерно на 60% больше, чем Opus 5.5 на том же уровне. Выход у Sonnet вдвое дешевле, а токенов уходит в 1,6 раза больше, так что от двукратной экономии на максимуме почти ничего не остаётся. Выигрывает Sonnet на умеренных уровнях, где она, по словам Anthropic, и тратит меньше токенов, и обгоняет прошлое поколение.
Скорость и рассуждения
В классификации Anthropic Sonnet 5.5 — «быстрая» модель, Opus 5.5 — «средняя». Ускоренного режима у Sonnet нет, у Opus он есть, но стоит вдвое дороже базы и работает только через собственный API Anthropic.
С рассуждениями модели устроены по-разному. У Opus 5.5 они включены всегда, отключить нельзя ни на каком уровне, а по умолчанию стоит medium. У Sonnet 5.5 рассуждения тоже адаптивные, но размышление перед ответом можно убрать режимом between_tools на уровнях до high, а по умолчанию в API стоит high (в приложениях Claude — medium). Это различие касается API. В чате Veruna AI обе модели рассуждают всегда, и у обеих одинаковый селектор из трёх уровней: низкий (по умолчанию), средний и высокий.
Связка: план от Opus, работа от Sonnet
У двух моделей есть приятная совместимость. В API Opus 5.5 умеет читать блоки размышлений Sonnet 5.5 — на Claude API и Google Cloud. Значит, разговор можно начать на Sonnet и поднять на Opus, когда задача окажется сложнее, чем казалось, и рассуждения не потеряются. Ни одна другая модель блоки Sonnet 5.5 не читает.
Похожую схему предлагает и разработчик из Creator в анонсе: когда Opus 5.5 задаёт архитектуру и общий каркас игры, реализацию он готов доверить Sonnet 5.5. В чате это работает ещё проще: дорогую модель берёте на план, дешёвую на исполнение, и переключаетесь в том же окне.
Что выбрать: Sonnet 5.5 или Opus 5.5
Берите Sonnet 5.5, если задача поставлена чётко. Исправить баг, реализовать функцию по описанию, собрать отчёт, таблицу или презентацию, разобрать документ, пройти сценарий в интерфейсе программы. Разница с Opus здесь в пару пунктов, а цена и скорость — в пользу Sonnet. Сюда же работа в терминале, где Sonnet даже впереди.
Берите Opus 5.5 для сложного кода и работы без ясной рамки: архитектура, многочасовой самостоятельный прогон по большой кодовой базе, задачи, где модель должна долго взвешивать варианты. Восемь пунктов на FrontierCode — это заметная разница. Сама Anthropic пишет, что для самой тяжёлой работы на длинной дистанции лучше брать Opus.
Не ставьте Sonnet 5.5 на максимум «для надёжности». На max она тратит больше токенов, чем Opus, и выигрыш в цене исчезает. Если умеренного уровня Sonnet не хватает, честнее переключиться на Opus.
Возможности каждой модели подробно разобраны в статьях что умеет Claude Sonnet 5.5 и что умеет Claude Opus 5.5. А как флагман Anthropic смотрится против OpenAI, мы сравнивали в материале GPT-6 Sol против Claude Opus 5.5.
Как сравнить Sonnet 5.5 и Opus 5.5 самому
Надёжнее всего — дать обеим одну и ту же задачу из своей работы. Разница в один-два пункта на тестах означает, что на вашем сценарии победителем может оказаться любая.
Обе модели подключены в Veruna AI и открыты на подписке Max — условия на странице тарифов. Без VPN, без иностранной карты, оплата в рублях. Переключаются они в одном окне, так что один промпт можно прогнать через обе и сравнить ответы рядом. Глубину рассуждений задаёт селектор в чате: у обеих моделей три уровня — низкий (по умолчанию), средний и высокий. Для честного сравнения ставьте одинаковый уровень. Как устроен доступ из России, описано в статьях как пользоваться Claude Sonnet 5.5 и как пользоваться Claude Opus 5.5.
Частые вопросы
Что лучше — Claude Sonnet 5.5 или Opus 5.5? По тестам Anthropic Opus 5.5 немного сильнее почти везде, кроме работы в терминале, где впереди Sonnet: 70,6% против 66,4%. Заметно Opus выигрывает только на сложном коде — 54,4% против 46,2%. При этом Sonnet вдвое дешевле, так что для чётко поставленных задач выгоднее она.
На сколько Sonnet 5.5 дешевле Opus 5.5? По прайсу — вдвое: $2 и $10 за миллион токенов против $4 и $20. Чтение из кэша стоит одинаково, $0,20. На максимальном уровне рассуждений Sonnet тратит примерно на 60% больше токенов, чем Opus, так что там разница почти исчезает.
Что быстрее — Sonnet 5.5 или Opus 5.5? Sonnet 5.5: Anthropic относит её к «быстрым» моделям, а Opus 5.5 — к «средним». В API у Sonnet размышление перед ответом можно почти отключить, а у Opus рассуждения включены всегда. В чате Veruna AI обе модели думают всегда; самый быстрый вариант — уровень «Низкий».
Когда брать Opus 5.5, а не Sonnet 5.5? Для сложного кода, архитектурных решений и долгой самостоятельной работы без чёткой рамки. Anthropic сама рекомендует Opus для самой тяжёлой работы на длинной дистанции.
Можно ли перейти с Sonnet на Opus посреди разговора? В чате — да, модель переключается в том же окне. В API Opus 5.5 умеет читать блоки размышлений Sonnet 5.5 на Claude API и Google Cloud, поэтому разговор можно поднять на старшую модель без потери хода рассуждений.