
Кратко
- Главное умение GLM-5.3 — не отпускать задачу, которая решается часами: на SWE-Marathon она набирает 42,5% против 19,4% у GLM-5.2, в терминале 28,3% против 4,6%.
- Контекст 1 048 576 токенов, вход и выход только текстовые, ответ до 128 тысяч токенов. Изображения флагман не принимает и не генерирует.
- Второе заявленное умение — поиск уязвимостей в чужом коде: 84,5% на CyberGym, лучший опубликованный результат на этом тесте.
- Слабое место видно не в отдельном навыке, а в общем зачёте: из шестнадцати строк собственной таблицы Z.ai модель лидирует в трёх.
- В таблице Z.ai на чужой замер опираются две строки. Ещё один независимый прогон сделала Together.ai уже после релиза, и он оказался выше заявленного.
Новых умений у версии 5.3 не появилось — выросла выносливость. Базовую модель Z.ai вообще не трогала, обе версии стоят на одних и тех же весах, а разницу дал ещё один круг дообучения. Разбираем, что умеет glm 5.3 по бенчмаркам и на практике, и отдельно то, где заявленное пока не с чем сверить. Про дату выхода и характеристики мы писали в материале про релиз GLM-5.3 — здесь только про возможности.
GLM-5.3: паспортные данные
Контекстное окно GLM-5.3 — 1 048 576 токенов, примерно полторы тысячи страниц текста за один заход. За один ответ модель может выдать до 128 тысяч токенов, этого хватит на полную переработку большого файла или на подробный план миграции кода. Идентификатор в API — glm-5.3 (документация Z.ai).
На входе только текст. Это важное ограничение, которое легко пропустить: фотографию, скриншот ошибки или скан документа флагману Z.ai скормить нельзя, и рисовать он тоже ничего не умеет. Любопытно, что младшая GLM-5.3 Flash как раз мультимодальная и понимает картинки и видео — по этой части она обгоняет старшую модель.
Рассуждения отключить нельзя. В API три уровня глубины — low, high и max, по умолчанию стоит max. У GLM-5.2 режим без рассуждений был, в 5.3 его убрали, так что даже на коротком вопросе модель сначала думает. Мы заводили GLM-5.3 в каталог Veruna AI и подтверждаем оба ограничения на практике: переключателя «отвечай без раздумий» у модели нет, а вход она принимает только текстовый.
Главный рывок: терминал и долгие агентные задачи
Z.ai прямо называет цель обновления: задачи, которые агент решает много шагов подряд. Под это модель и дообучали — в терминале её гоняли с бюджетом до 600 ходов и таймаутом в десять часов на задачу.
В цифрах официальной таблицы это выглядит так. В терминале (Terminal-Bench 3.0) GLM-5.3 даёт 28,3% против 4,6% у предыдущей версии. На долгих задачах в коде (SWE-Marathon v1.1) — 42,5% против 19,4%. На правках в реальных кодовых базах (DeepSWE v1.1) — 66,9% против 46,2%. В автоматизации рутинных операций (AutomationBench) — 48,2% против 26,2%. В эрудиции с инструментами (HLE with Tools) — 62,5% против 54,7% (карточка модели на Hugging Face).
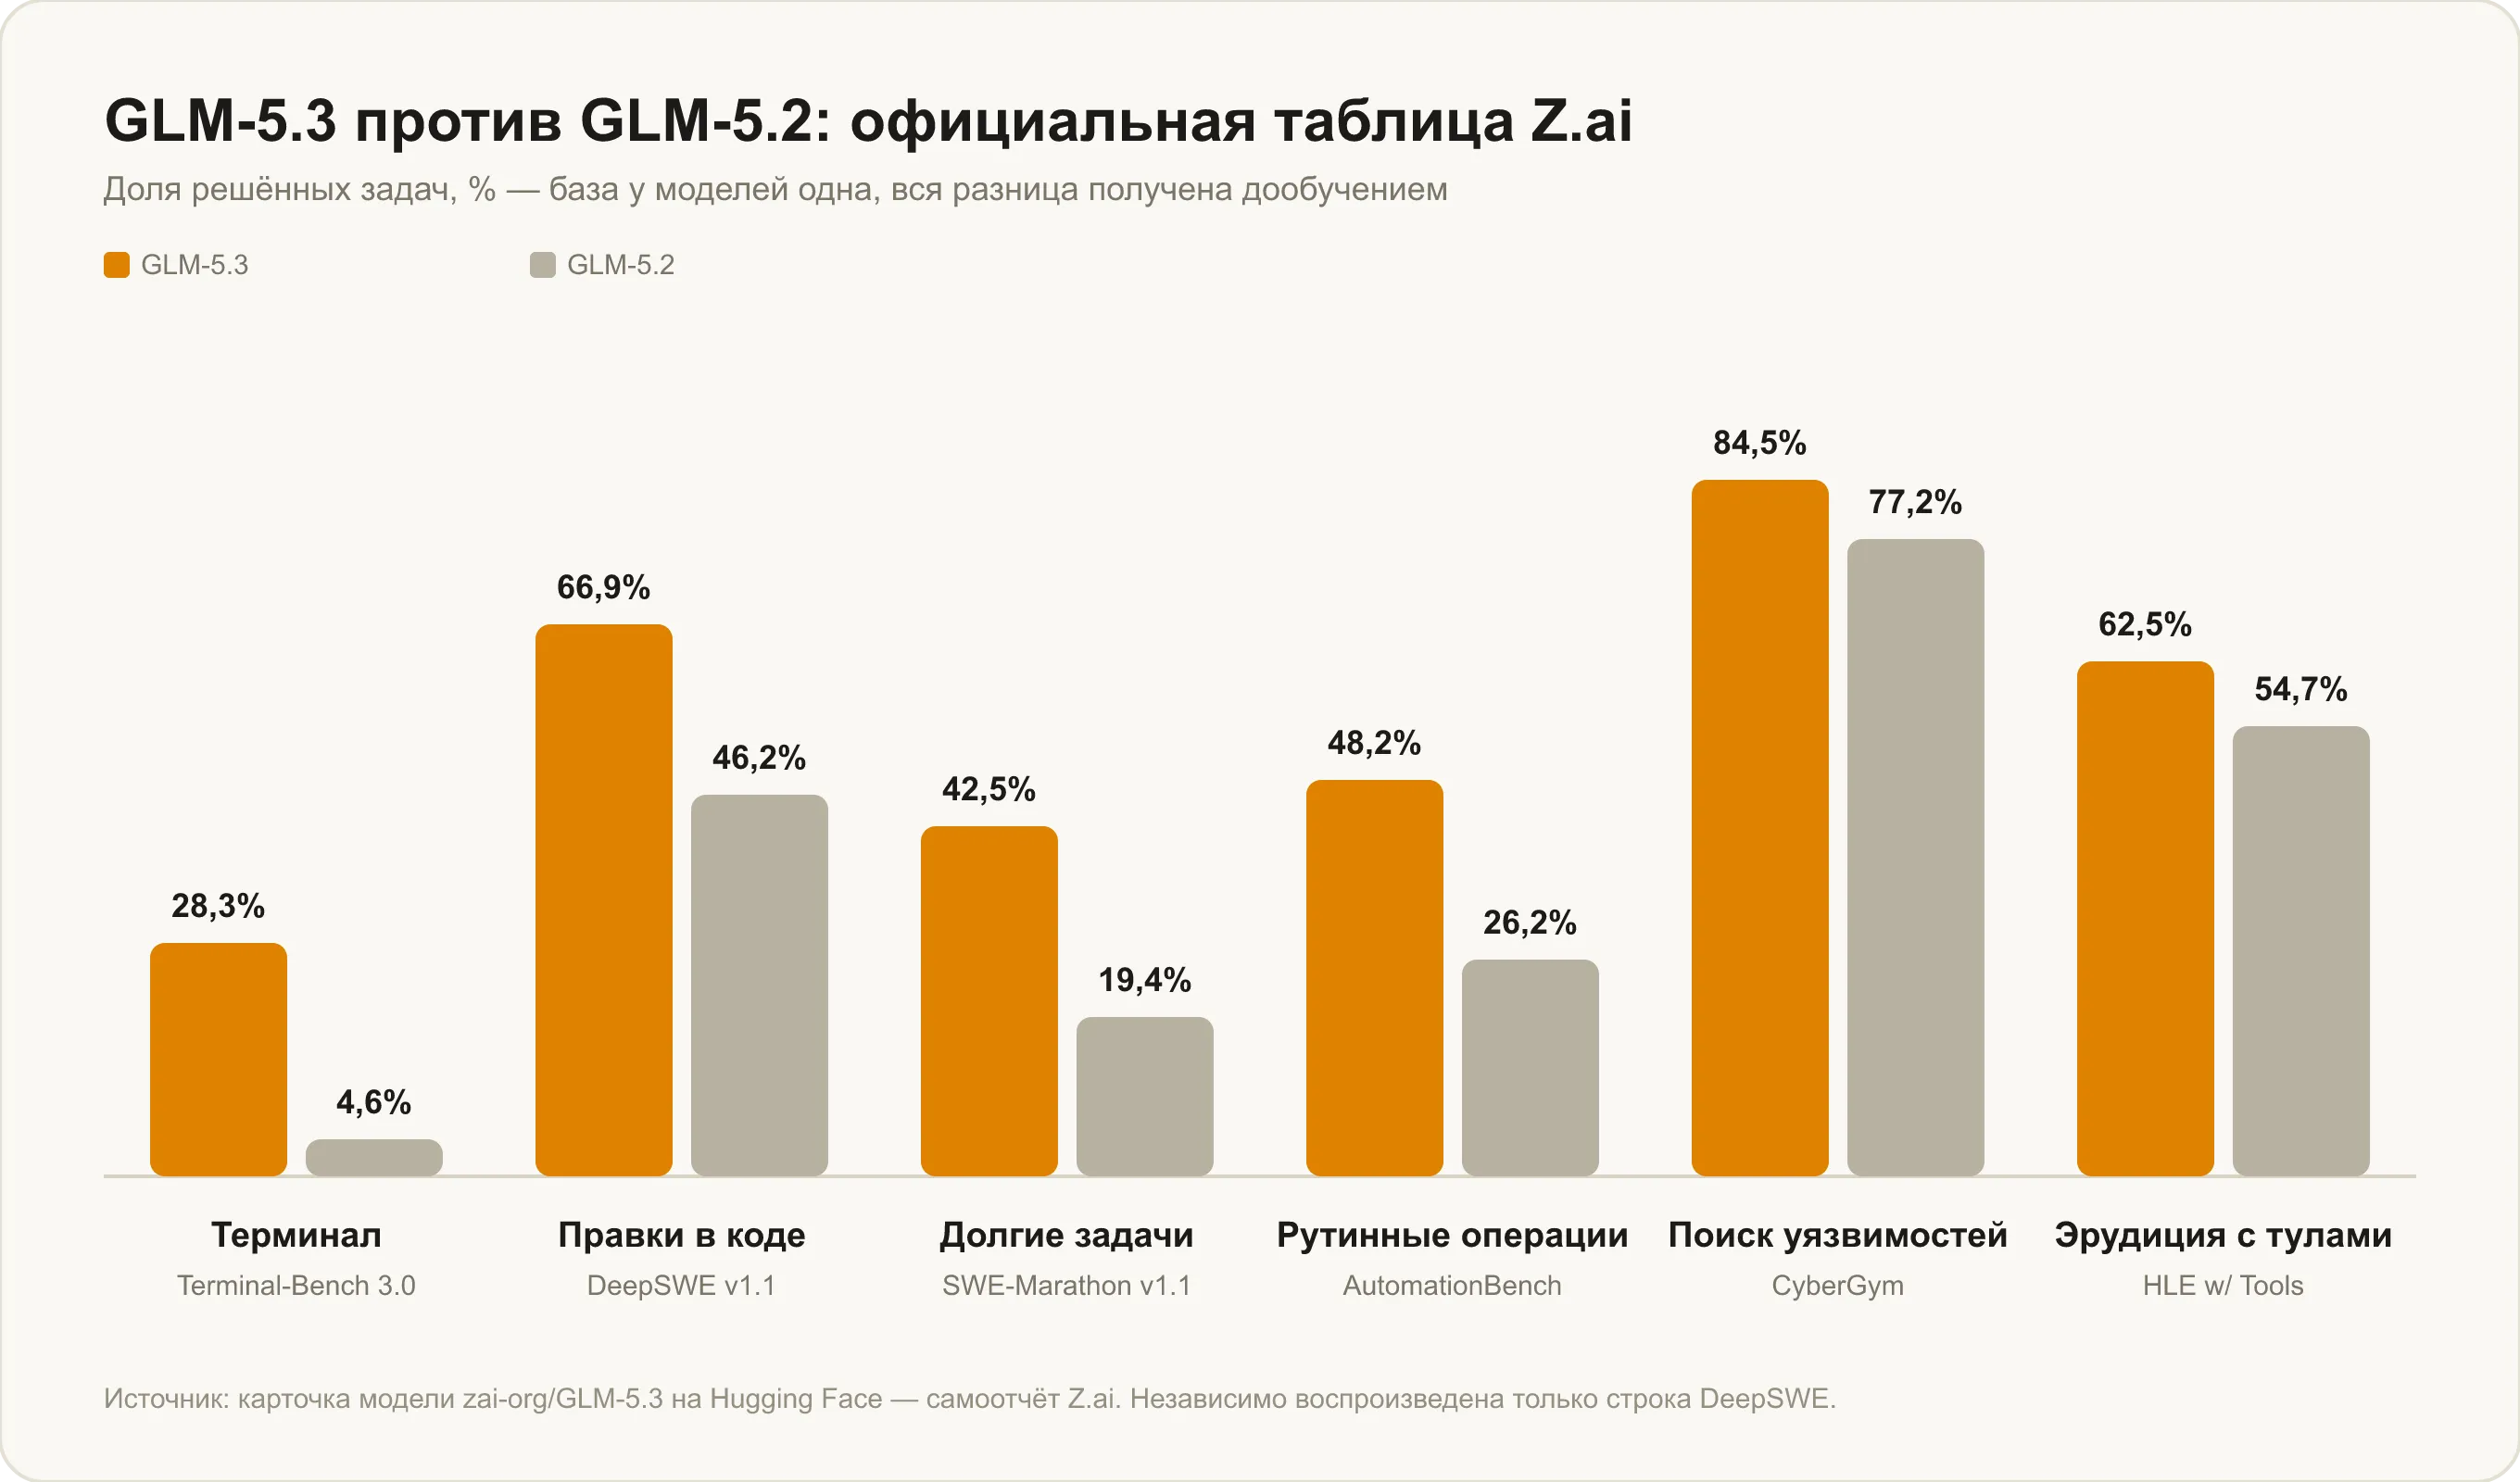
На коротких запросах этот прирост почти не виден, и обозреватели на это обращают внимание отдельно: весь выигрыш живёт на длинной дистанции. Практический вывод простой — GLM-5.3 задумана как модель для агента, который работает сам, а не как собеседник для быстрого вопроса. Про сам переход индустрии к такому формату мы писали в материале от чата к агентам.
Есть и внутренний тест Z.ai Code Bench, на котором компания заявляет прирост в 50% относительно GLM-5.2. Бенчмарк закрытый, методика не опубликована, обзоры приводят по нему несовпадающие числа, так что относиться к этой цифре стоит как к заявлению разработчика.
Где GLM-5.3 в общем зачёте по коду
DeepSWE v1.1 удобен тем, что по нему опубликованы результаты сразу многих текущих моделей, и на нём видно расстановку сил без пересчётов.
GLM-5.3 набирает 66,9%. Выше неё — Muse Spark 1.3 (75,4%), GPT-6 Astra (74,1%), GPT-5.6 Sol Max (72,7%), Grok 4.7 (71,0%), Claude Fable 5.1 (70,0%) и открытая Kimi K3 (67,5%). То есть китайский флагман отстаёт от верхушки на восемь-девять пунктов и проигрывает даже другой открытой модели.
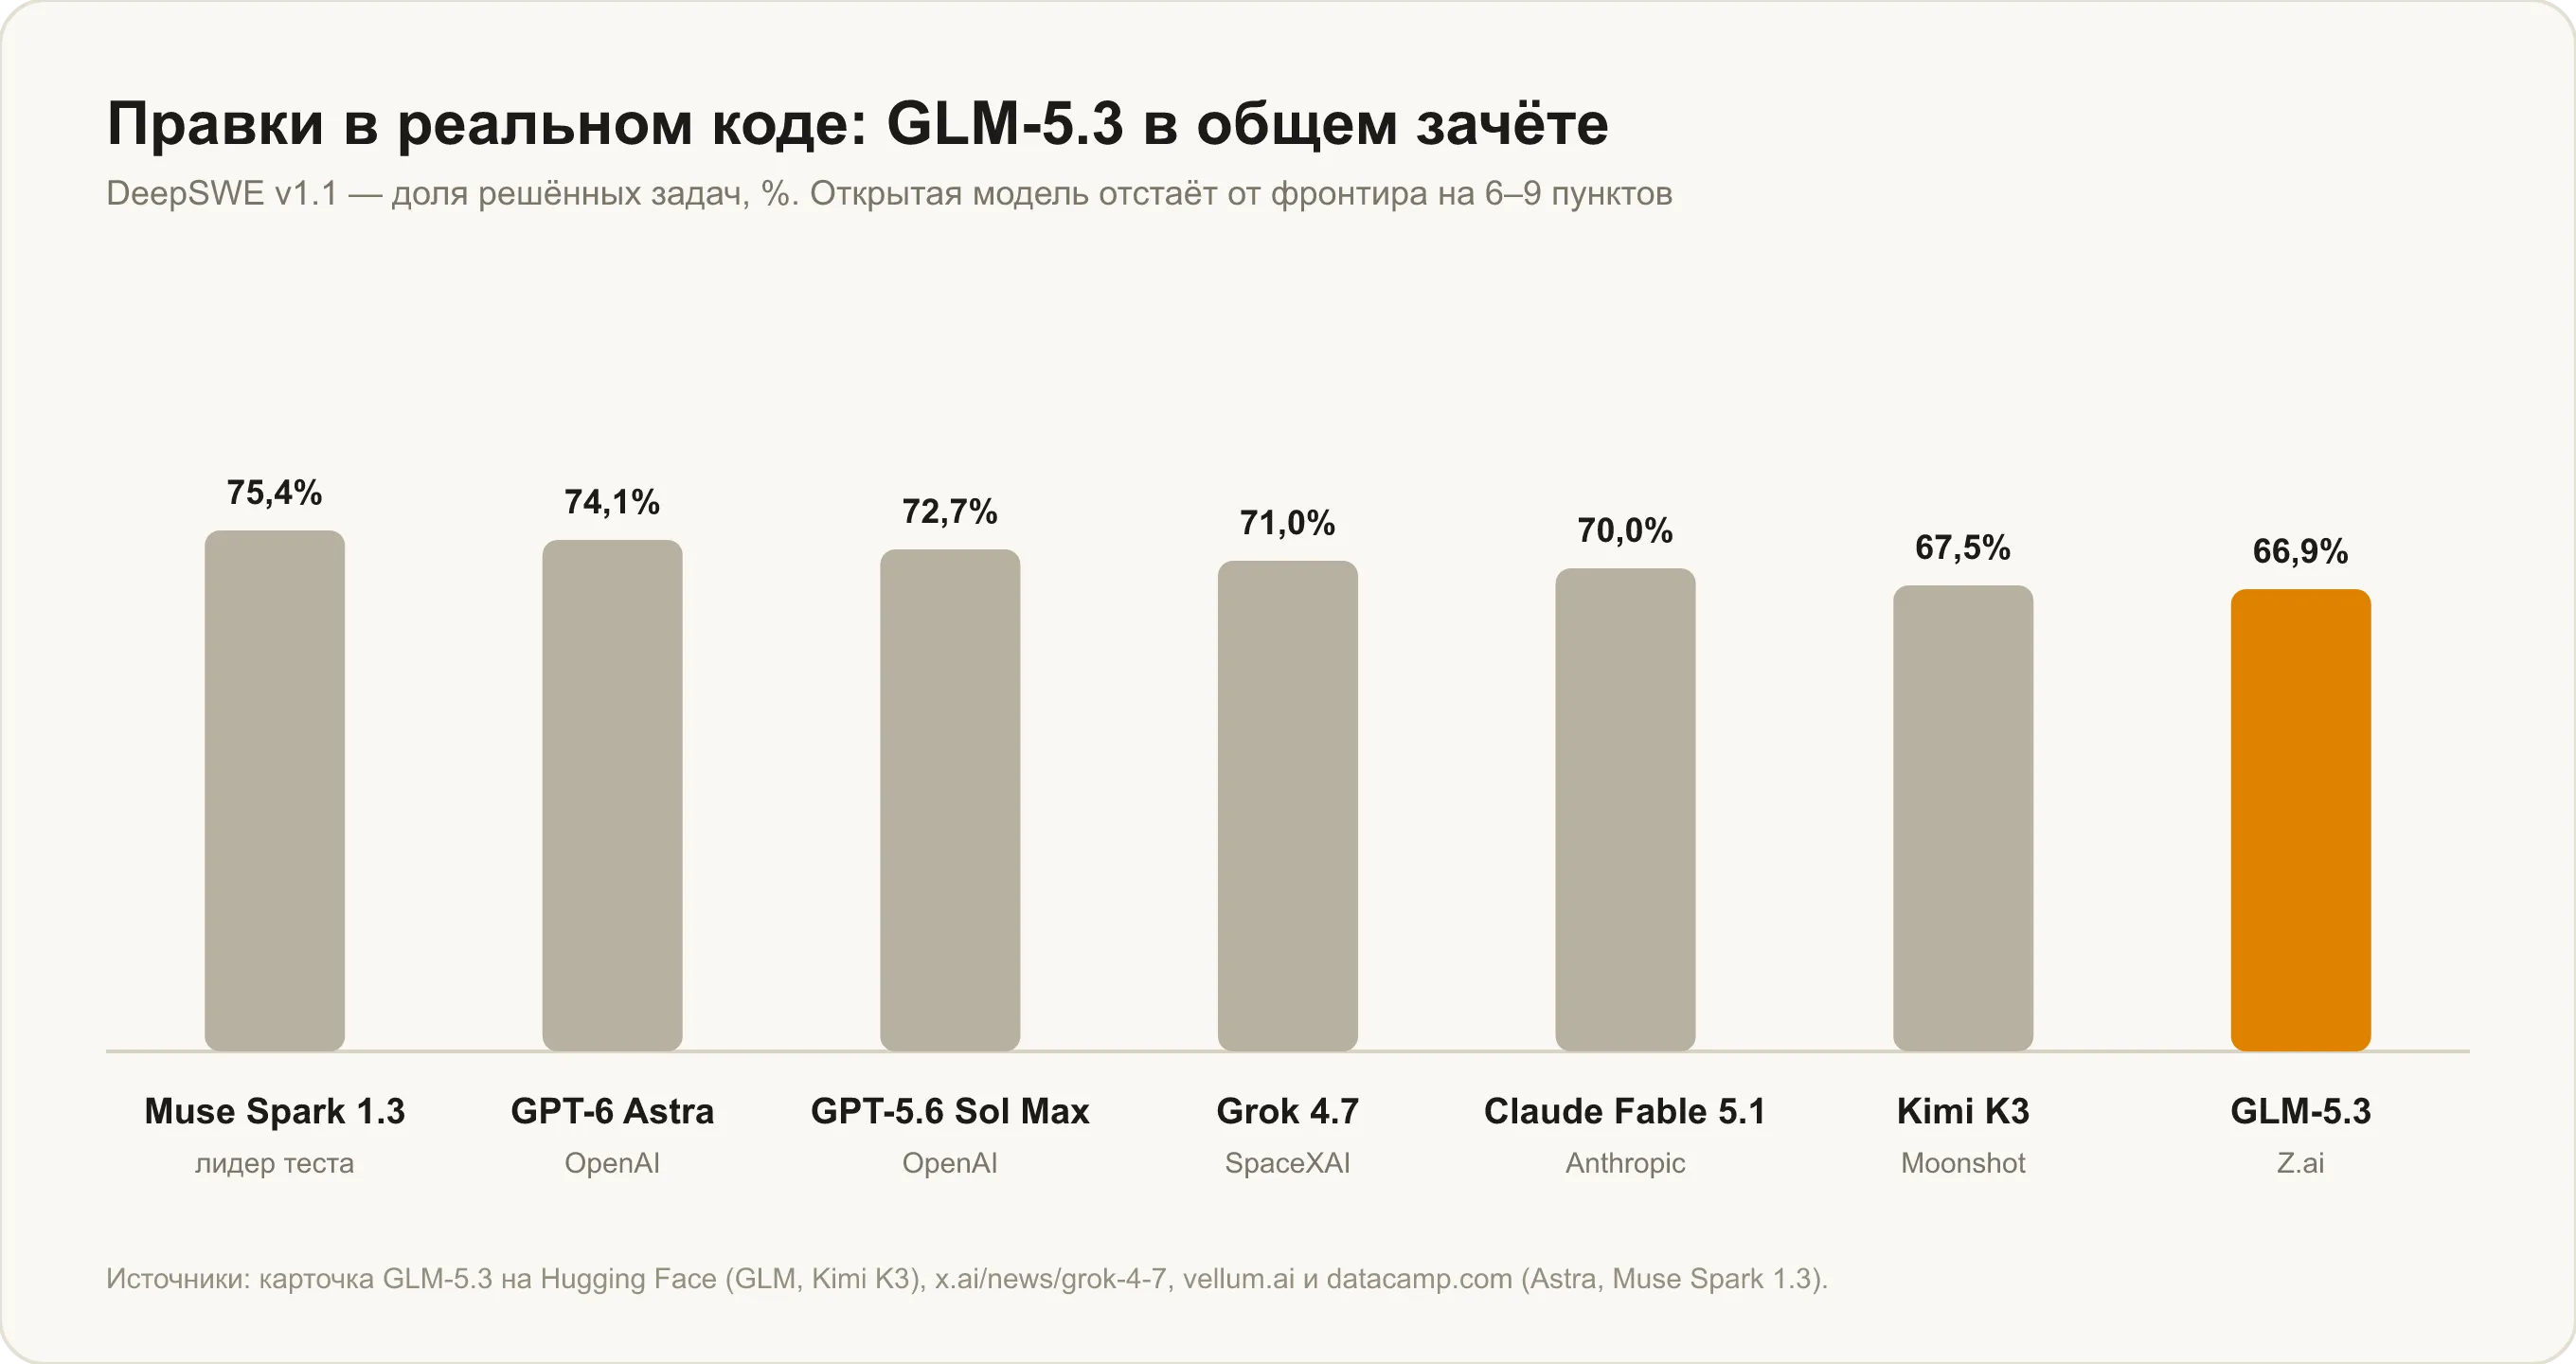
Похожая картина и в терминале. Рост с 4,6% до 28,3% — это шесть раз, но у Claude Fable 5 на том же тесте 33,7%, у GPT-5.6 Sol — 34,6%. Формулировка Z.ai «лучшая открытая модель для кода» тут абсолютно корректна, а вот «лучшая модель для кода» была бы неправдой. Какая нейросеть сильнее в разных сценариях работы с кодом, мы разбирали отдельно — в материале какая нейросеть лучше пишет код.
Ещё одна строка, где GLM-5.3 оказалась последней в собственной таблице, — Toolathlon, тест на работу с большим набором инструментов: 73,0% против 76,5% у Kimi K3 и 76,2% у Claude Opus 4.8. Для модели, которую продают как агентную, это неприятный результат.
Кибербезопасность: где заявка сильнее результата
Вторая половина релизного пиара — про поиск уязвимостей. На CyberGym GLM-5.3 даёт 84,5%, и это действительно лучший опубликованный результат на тесте. Условия: 1507 задач, один прогон, без веб-инструментов.
Проблема в том, что отрыв от ближайшего конкурента, Claude Fable 5 с результатом 83,8%, составляет 0,7 процентного пункта. При одном прогоне и без доверительных интервалов такая разница укладывается в обычный разброс между запусками, о чём пишут и сами обозреватели.
И если посмотреть дальше по цепочке, всё становится ещё скромнее. Найти дыру и воспользоваться ею — разные задачи: ExploitBench у GLM-5.3 54,4% против 78,0% у Claude Fable 5 и 76,5% у GPT-5.6 Sol. То есть находить дыры модель умеет, а доводить находку до рабочего эксплойта получается заметно хуже.
Отдельная история с заявленными 2436 уязвимостями в 269 проектах. Число посчитано накопительно вместе с GLM-5.2, публично подтверждены из него 53 записи, остальное под эмбарго и проверке не поддаётся (developer-tech.com). Часть кредитов при этом настоящая: благодарности Z.ai Security есть в рекомендациях FreeBSD и Red Hat.
Что из этих цифр перепроверено
Почти вся таблица получена самой Z.ai на собственном харнессе. На чужой замер там опираются две строки: GDPval-AA v2, где Artificial Analysis насчитала 1769 баллов против 1508 у GLM-5.2, и FrontierSWE с 78,1%, который гонял независимый подрядчик Proximal.
Исключение одно. Together.ai в конце августа прогнала DeepSWE сама: 900 попыток на всех 113 задачах, четыре прогона на конфигурацию. Вышло 69,0% с погрешностью 2,7 пункта — выше самоотчёта Z.ai (together.ai). Обычно бывает наоборот, и это скорее говорит в пользу модели, чем против неё.
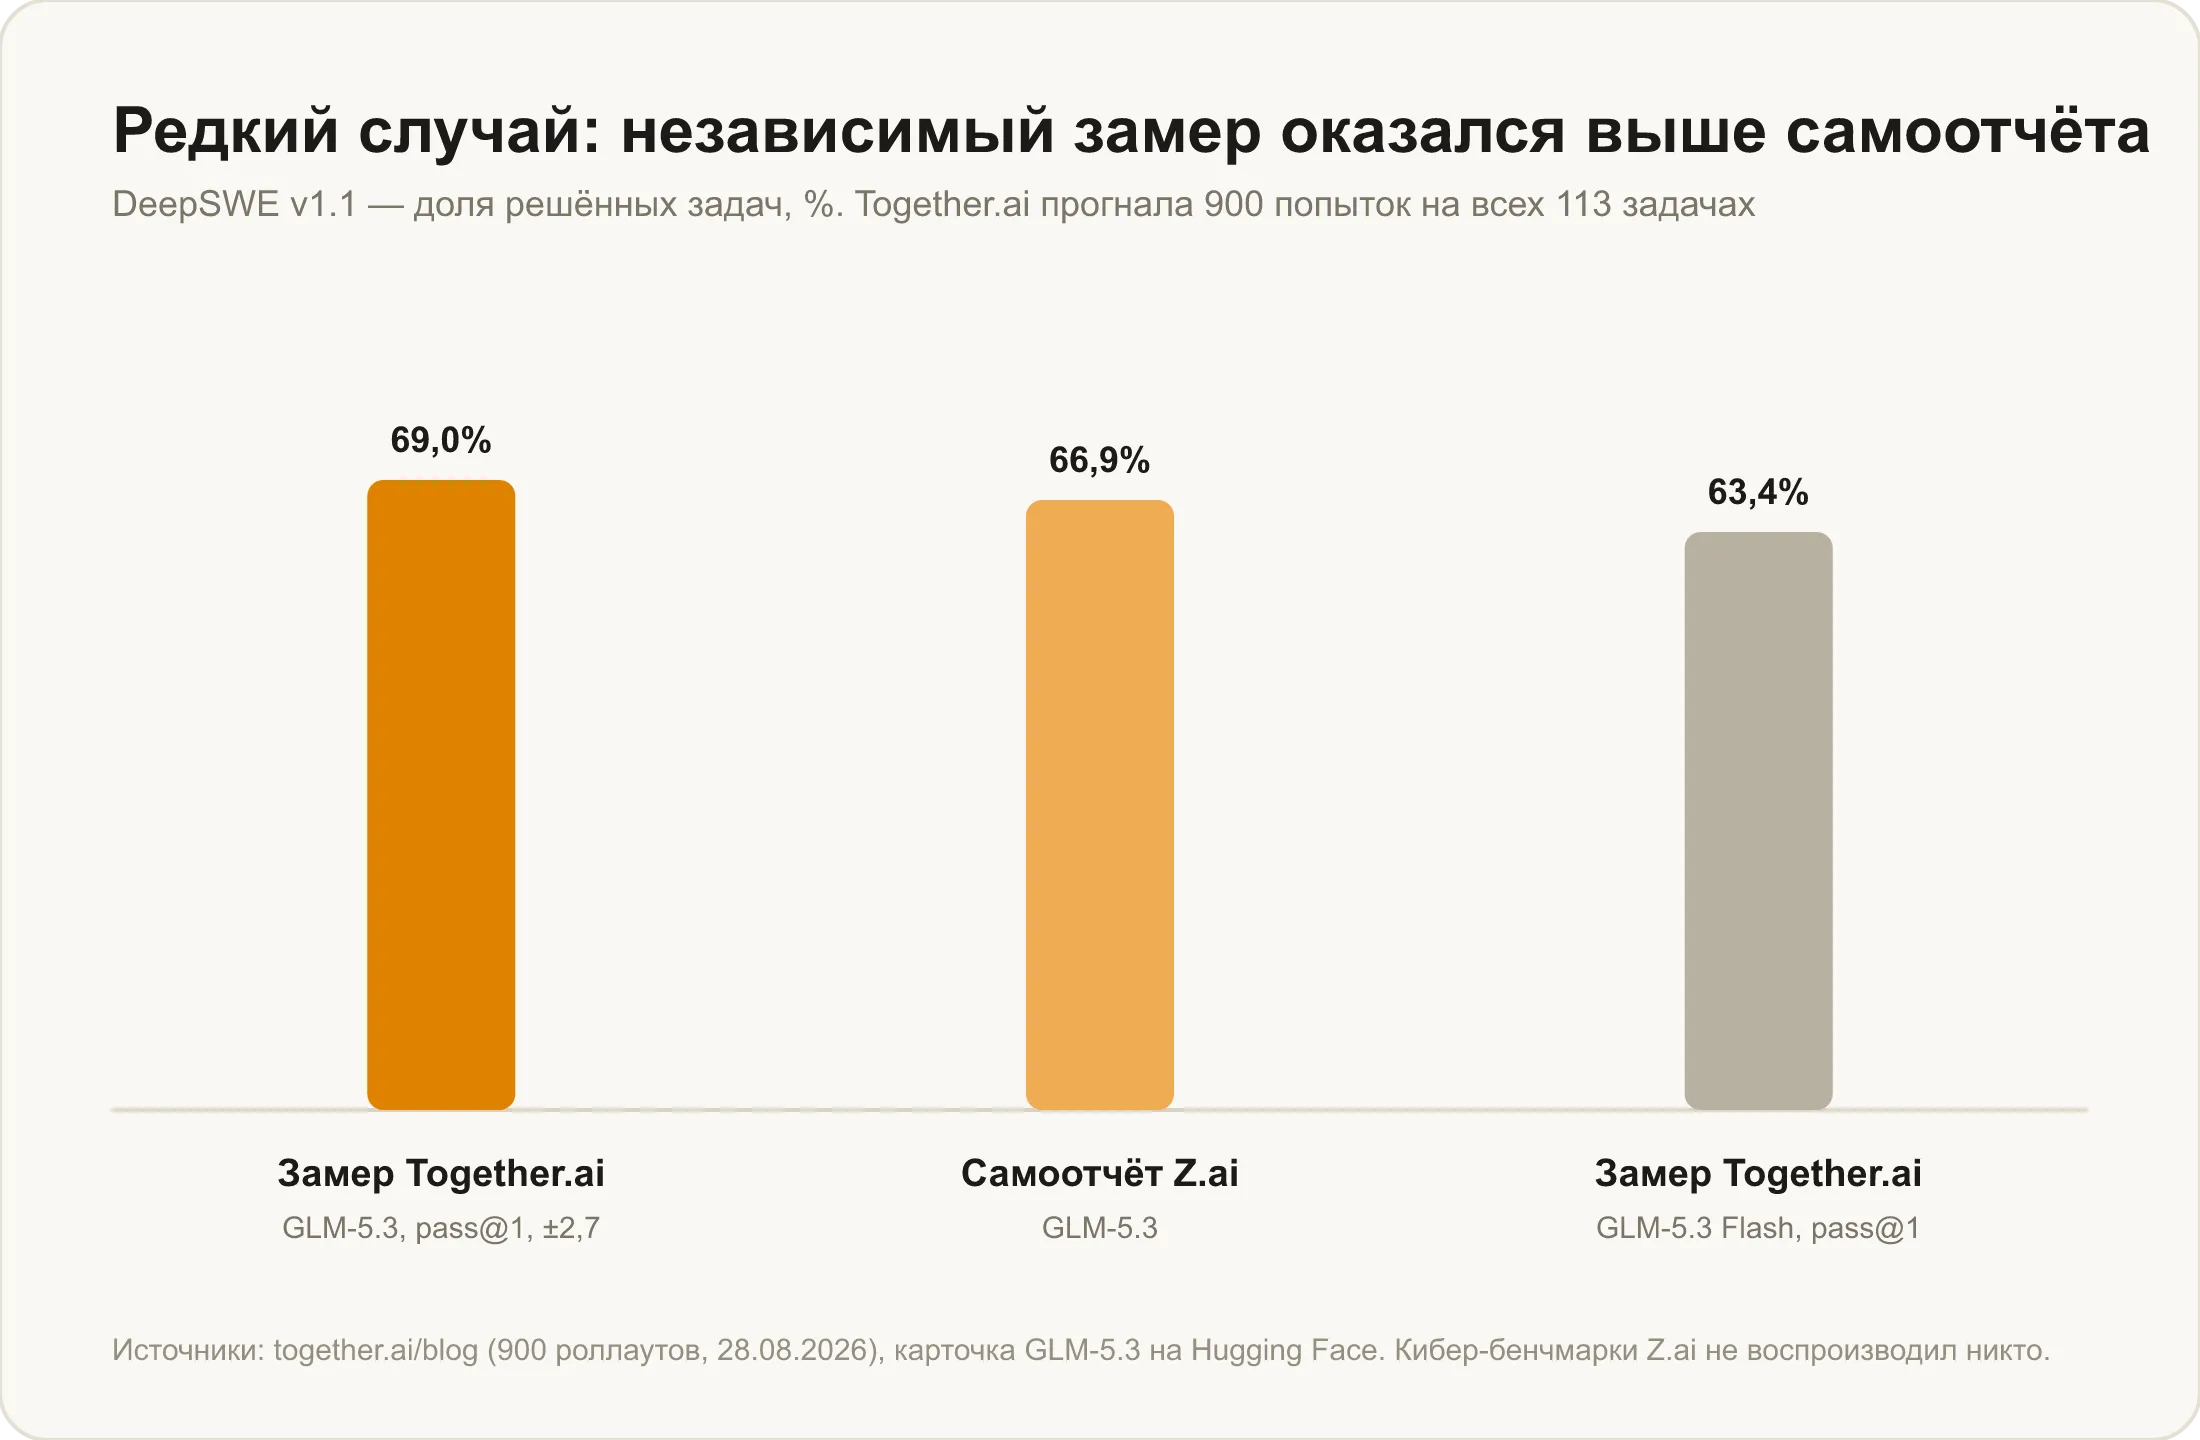
Весь кибер-блок при этом не воспроизвёл никто, хотя API работает с 18 августа. Системную карту и отчёт по безопасности, ради которых Z.ai на две недели задержала публикацию весов, тоже так и не выложили.
История линейки тут показательна: лаборатория LayerLens перепрогнала предыдущее поколение GLM через 24 дня в тех же условиях и получила разброс в двенадцать пунктов на одном из тестов. Воспроизводимость замеров у моделей этой серии исторически так себе, так что читать любую отдельную цифру как точную характеристику не стоит. Все данные в статье актуальны на 22 сентября 2026 года.
Чего GLM-5.3 не умеет
Флагман работает только с текстом: ни изображений на входе, ни генерации картинок на выходе. Для задач со скриншотами и сканами нужна другая модель, и в каталоге Veruna AI их много — подобрать помогает материал как выбрать нейросеть под задачу.
Скорость у модели средняя: 61 токен в секунду при медиане около 75 по своему классу. Плюс болтливость — на прогоне индекса Artificial Analysis GLM-5.3 выдала 210 млн выходных токенов при медиане 140 млн (artificialanalysis.ai). Дешёвый токен это частично съедает: один прогон задачи обошёлся в $2,01, и по стоимости решённой задачи модель оказывается середняком, а не дешёвым вариантом.
Отключить рассуждения нельзя, так что на коротком запросе ответ всегда придёт с задержкой. Тут логика та же, что у Grok 4.7, где режима «отвечай сразу» тоже нет: на простой вопрос разумнее переключиться на модель полегче.
Для каких задач GLM-5.3 подходит, а для каких избыточна
Модель стоит брать туда, где решение растягивается на десятки шагов и агент должен сам держать план: доработка объёмной кодовой базы, многочасовые агентные сценарии, автоматизация рутинных операций, разбор чужого кода на предмет слабых мест. В этих сценариях разрыв с предыдущей версией измеряется разами.
Для короткого вопроса, разовой правки текста или бытового уточнения она избыточна. Рассуждения не выключаются, скорость средняя, а преимущество на такой дистанции просто не успевает проявиться.
Работу с картинками и документами-сканами модель не потянет в принципе: вход только текстовый. И если задача не про код и не про агента, а, скажем, про письмо или анализ текста, то смысла брать именно GLM-5.3 мало: в общем индексе Artificial Analysis она уступает флагманам OpenAI и Anthropic заметно.
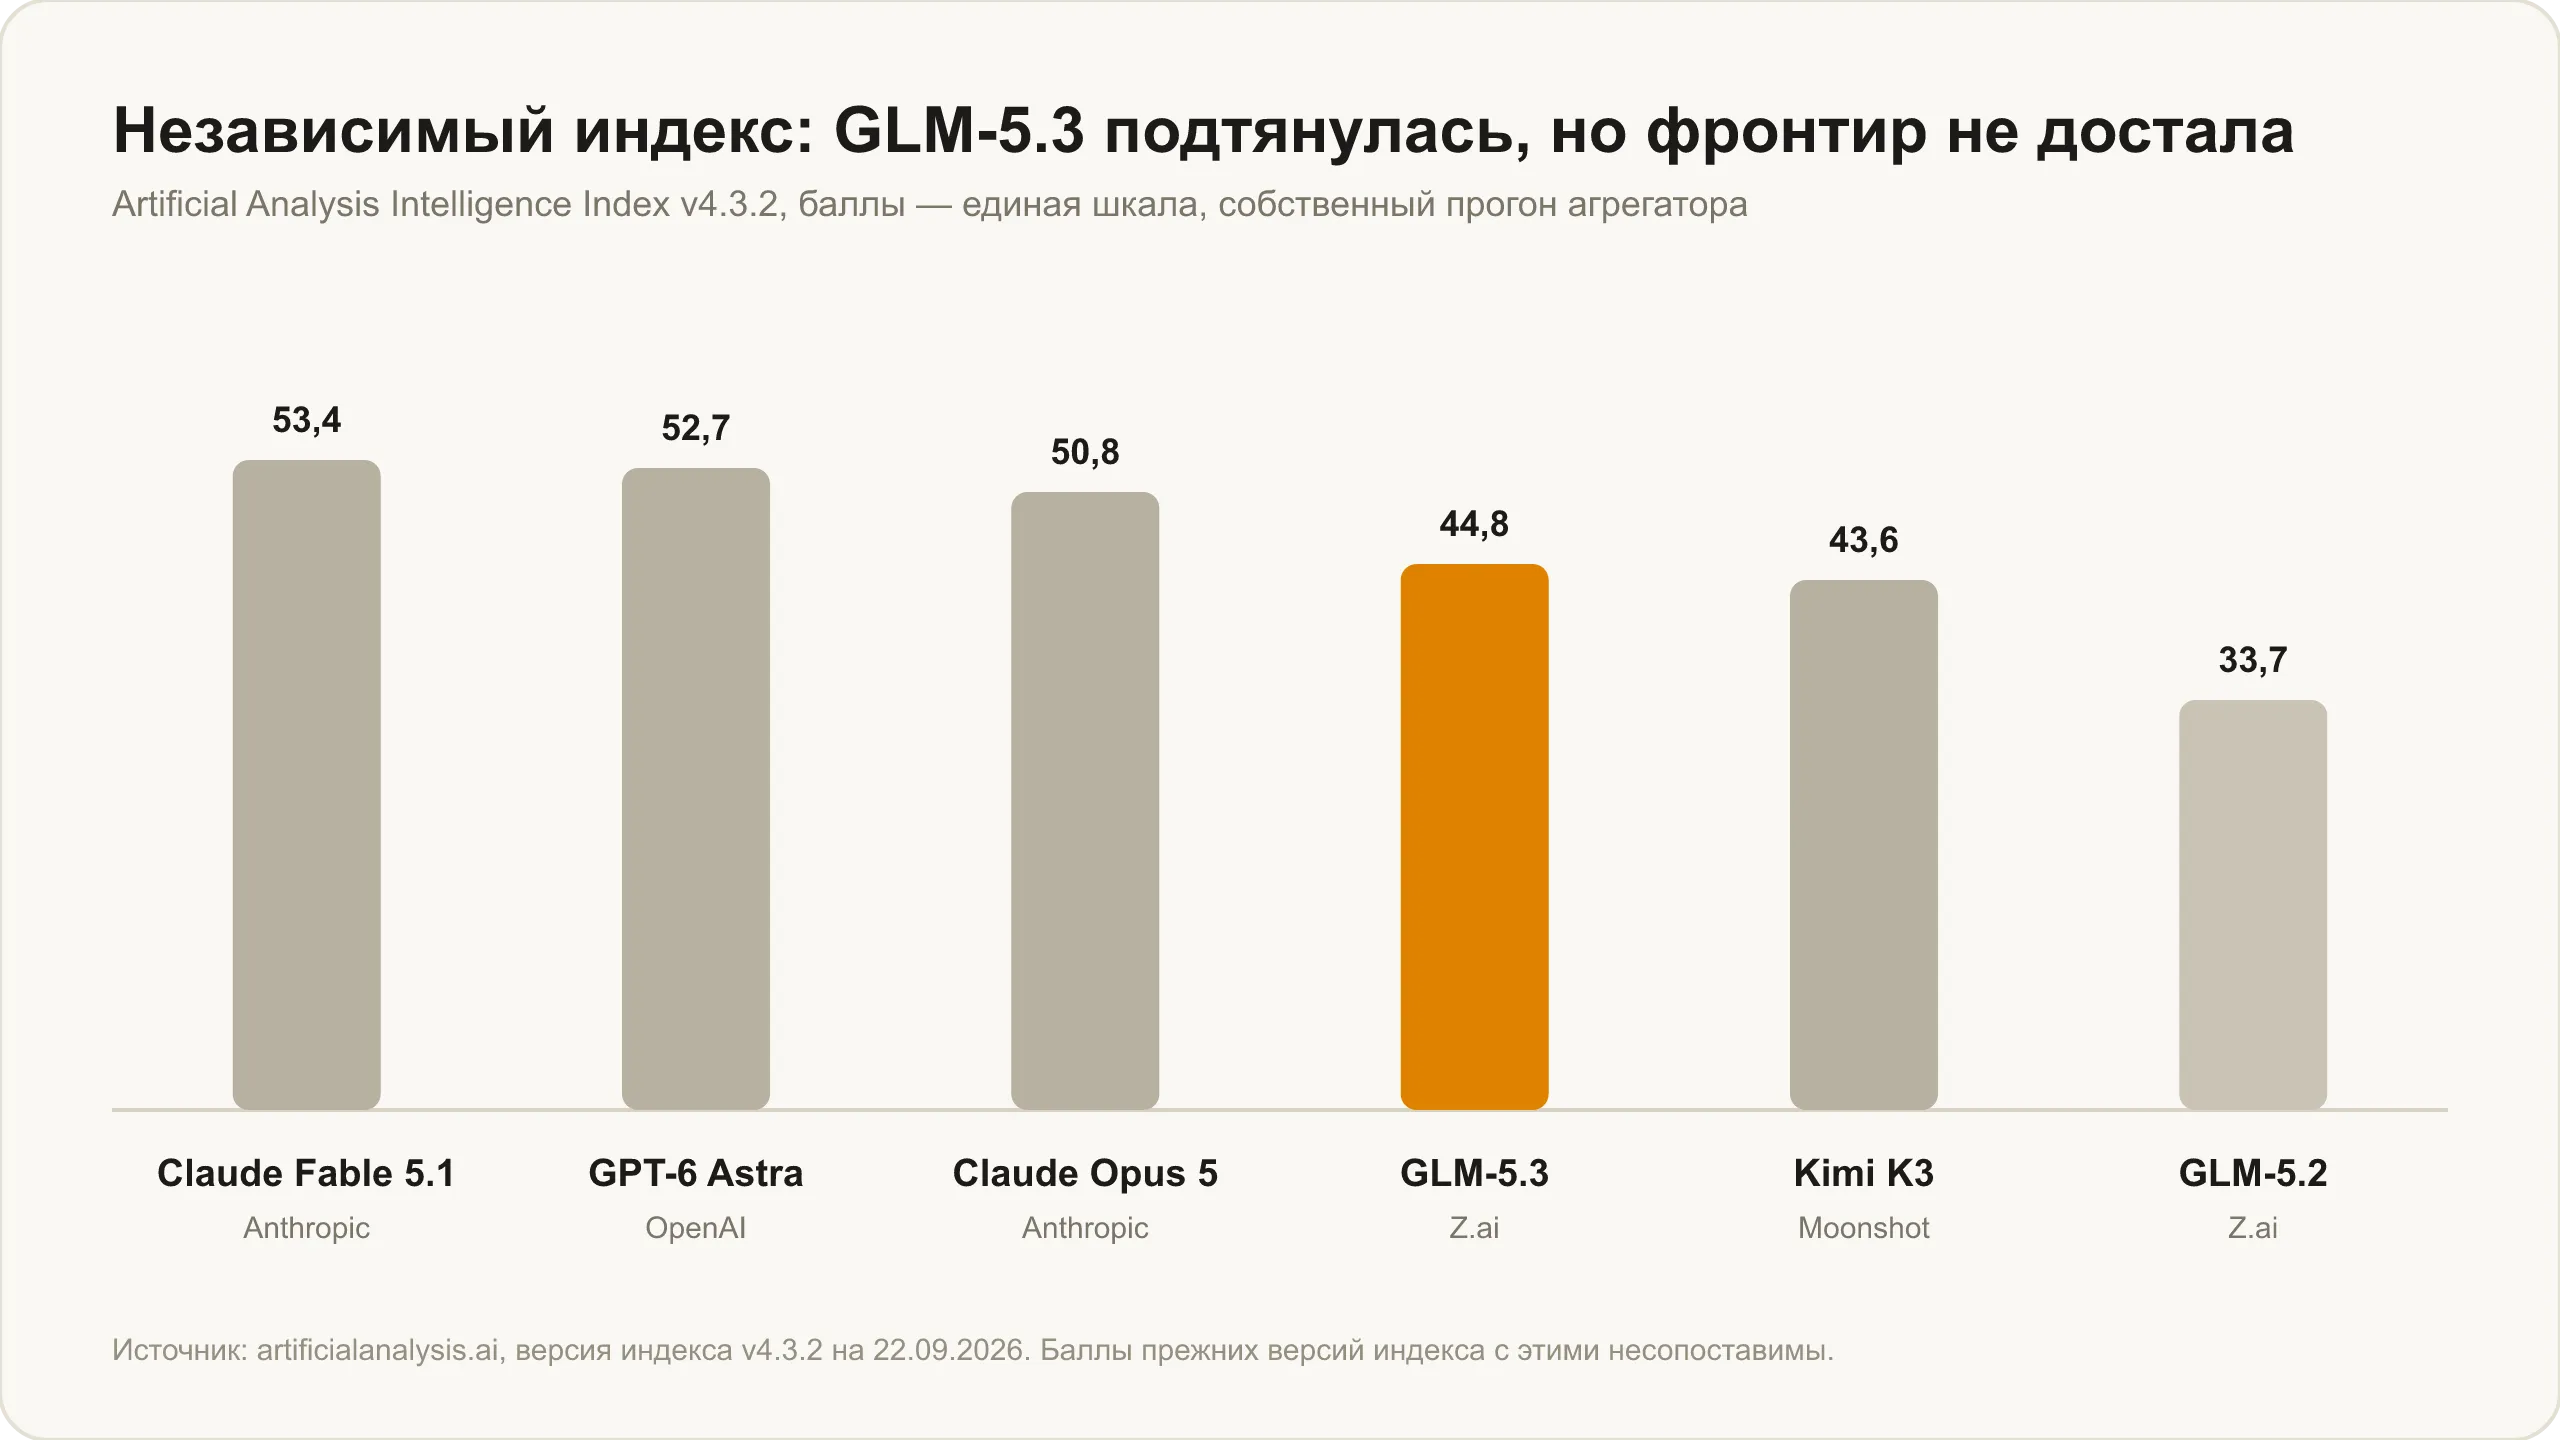
Баллы на этом графике стоит сравнивать только между собой: агрегатор недавно пересобрал методику, и с числами из наших прежних статей про модели Anthropic и OpenAI текущая шкала несопоставима.
Как попробовать GLM-5.3 в Veruna AI
GLM-5.3 заведена в каталог моделей Veruna AI и открывается на подписке Pro и выше — актуальные условия смотрите на странице тарифов. Без VPN, оплата в рублях: подключение устроено так же, как и к остальным моделям каталога. Про сам процесс доступа из России подробно — в статье как пользоваться GLM-5.3.
Платформа полезна не одной конкретной моделью, а тем, что модели переключаются в одном окне. Тяжёлую GLM-5.3 логично брать под многошаговую самостоятельную работу, а на короткий вопрос переключаться на модель полегче, не открывая второй сервис. Рядом в каталоге лежит предыдущая версия, GLM-5.2, — удобно, если хочется сравнить два поколения на одной задаче.
Короткие сценарии
Многочасовая задача в коде без пошагового контроля — ровно то, подо что обновление и затачивали: разрыв с прошлой версией на SWE-Marathon больше чем двукратный.
Разбор чужого кода на слабые места — область, где модель показывает лучший опубликованный результат, хотя отрыв от конкурентов там минимальный.
Работа с очень длинным текстом — миллион токенов контекста позволяет загрузить объёмный модуль целиком, но помните, что модель многословна и счёт за задачу растёт быстрее, чем кажется по прайсу.
Быстрый вопрос, картинка или скан — не сюда. Рассуждения не отключаются, а изображения на вход флагман не принимает вовсе.
Частые вопросы
Что умеет GLM-5.3? Модель держит в контексте до 1 048 576 токенов и работает как агент в терминале: вызывает инструменты и ведёт задачу много шагов подряд. Её сильная сторона — многошаговые задачи в коде, автоматизация рутинных операций и поиск уязвимостей. Генерации картинок нет, картинки на вход она тоже не принимает: и вход, и выход только текстовые.
Стоит ли переходить на GLM-5.3 с GLM-5.2? Если вы гоняете агентные сценарии на десятки шагов — да, разрыв там двукратный и больше, а цена за токен осталась прежней. Если модель используется для коротких ответов, выгода спорная: рассуждения в 5.3 отключить нельзя, и минимальный счёт за запрос вырастает. Конфиги при переезде тоже придётся править.
GLM-5.3 лучше Kimi K3? Смотря на чём. На DeepSWE Kimi K3 набирает 67,5% против 66,9%, на Toolathlon — 76,5% против 73,0%, на SWE-Marathon — 48,1% против 42,5%. GLM-5.3 отыгрывает в терминале и в эрудиции с инструментами, а по сводному индексу Artificial Analysis модели идут вплотную. Если коротко: по коду чаще впереди Kimi K3, по агентной работе в терминале — GLM-5.3.
Правда ли GLM-5.3 лучшая в кодинге? Лучшая среди открытых — да, так формулирует и сама Z.ai. Лучшая вообще — нет: на DeepSWE её обходят Muse Spark 1.3, GPT-6 Astra, GPT-5.6 Sol Max, Grok 4.7, Claude Fable 5.1 и Kimi K3.
Можно ли отключить рассуждения у GLM-5.3? Нет. Доступны три уровня глубины — low, high и max, по умолчанию max, но режима без рассуждений у модели нет. У предыдущей версии он был, это изменение ломает совместимость при переезде.