
Кратко
- GPT-6.1 Sol заточена под код, работу внутри программ, документы и задачи в несколько шагов. Именно в этих областях OpenAI заявляет почти уровень флагмана GPT-6 Astra.
- На правках в реальном коде (DeepSWE 1.1) у модели 75,2%, на работе в программах (OSWorld 2.0) — 71,4%. Это на 6,4 и 7 пунктов выше, чем у GPT-6 Sol.
- Модель принимает текст и изображения, отвечает текстом, держит в контексте до 1,05 млн токенов. Рисовать картинки и работать со звуком она не умеет.
- Рассуждения у неё включены всегда. Для простых задач хватает минимального или низкого уровня, высокий нужен сложной отладке и большим документам.
На вопрос «что умеет gpt 6.1 sol» короткий ответ такой: почти всё, что умеет флагман OpenAI, в рабочих задачах — программировании, разборе документов, многошаговой работе с инструментами, — за пятую часть его цены. Модель вышла 29 сентября 2026 года. Ниже разобрано по задачам: что она делает хорошо, как ставить ей запрос, какой уровень рассуждений выбирать и где она всё-таки уступает.
Что модель принимает и отдаёт
На входе GPT-6.1 Sol принимает текст и изображения: скриншоты, фотографии документов, графики, схемы. На выходе — только текст. Сгенерировать картинку, видео или озвучку она не может, это другие модели.
Контекстное окно — 1 050 000 токенов, под сам запрос из них отведено 922 тысячи. Ответ может занимать до 128 тысяч токенов, то есть это десятки страниц. Знания заканчиваются 30 апреля 2026 года: о более поздних событиях модель знает только то, что вы ей расскажете или что она найдёт через веб-поиск, если он подключён в интерфейсе.
Отдельно про файлы. Сама модель работает с текстом и картинками. PDF, таблицу или документ Word можно загрузить в чат потому, что интерфейс сам разбирает файл и передаёт модели содержимое.
Код и отладка
Это основная задача, под которую модель и делали. На DeepSWE 1.1, где агент вносит правки в настоящие проекты, у GPT-6.1 Sol 75,2% на уровне high. Лучший результат прошлой версии был 68,8%, и то на уровне max. По словам OpenAI, это уровень флагмана Astra при цене задачи примерно на 76% ниже, чем у GPT-6 Sol.
GitHub, куда модель подключили в день релиза, пишет в своём changelog, что в ранних тестах она надёжно доводила задачи до конца и тратила заметно меньше токенов и шагов, чем модели семейств GPT-6 и GPT-5.6.
Как ставить задачу:
Вот функция на Python и текст ошибки, которую она выдаёт на пустом списке. Найди причину, исправь и добавь проверку граничных случаев. Объясни, что было не так, в двух-трёх предложениях.
Практика выбора уровня: одна функция и понятная ошибка — низкий уровень. Баг, который проявляется только при определённом сочетании условий, или правка в нескольких файлах — высокий. Средний уровень хорош для рефакторинга, где нужно удержать в голове всю структуру модуля.
Работа внутри программ и агентные задачи
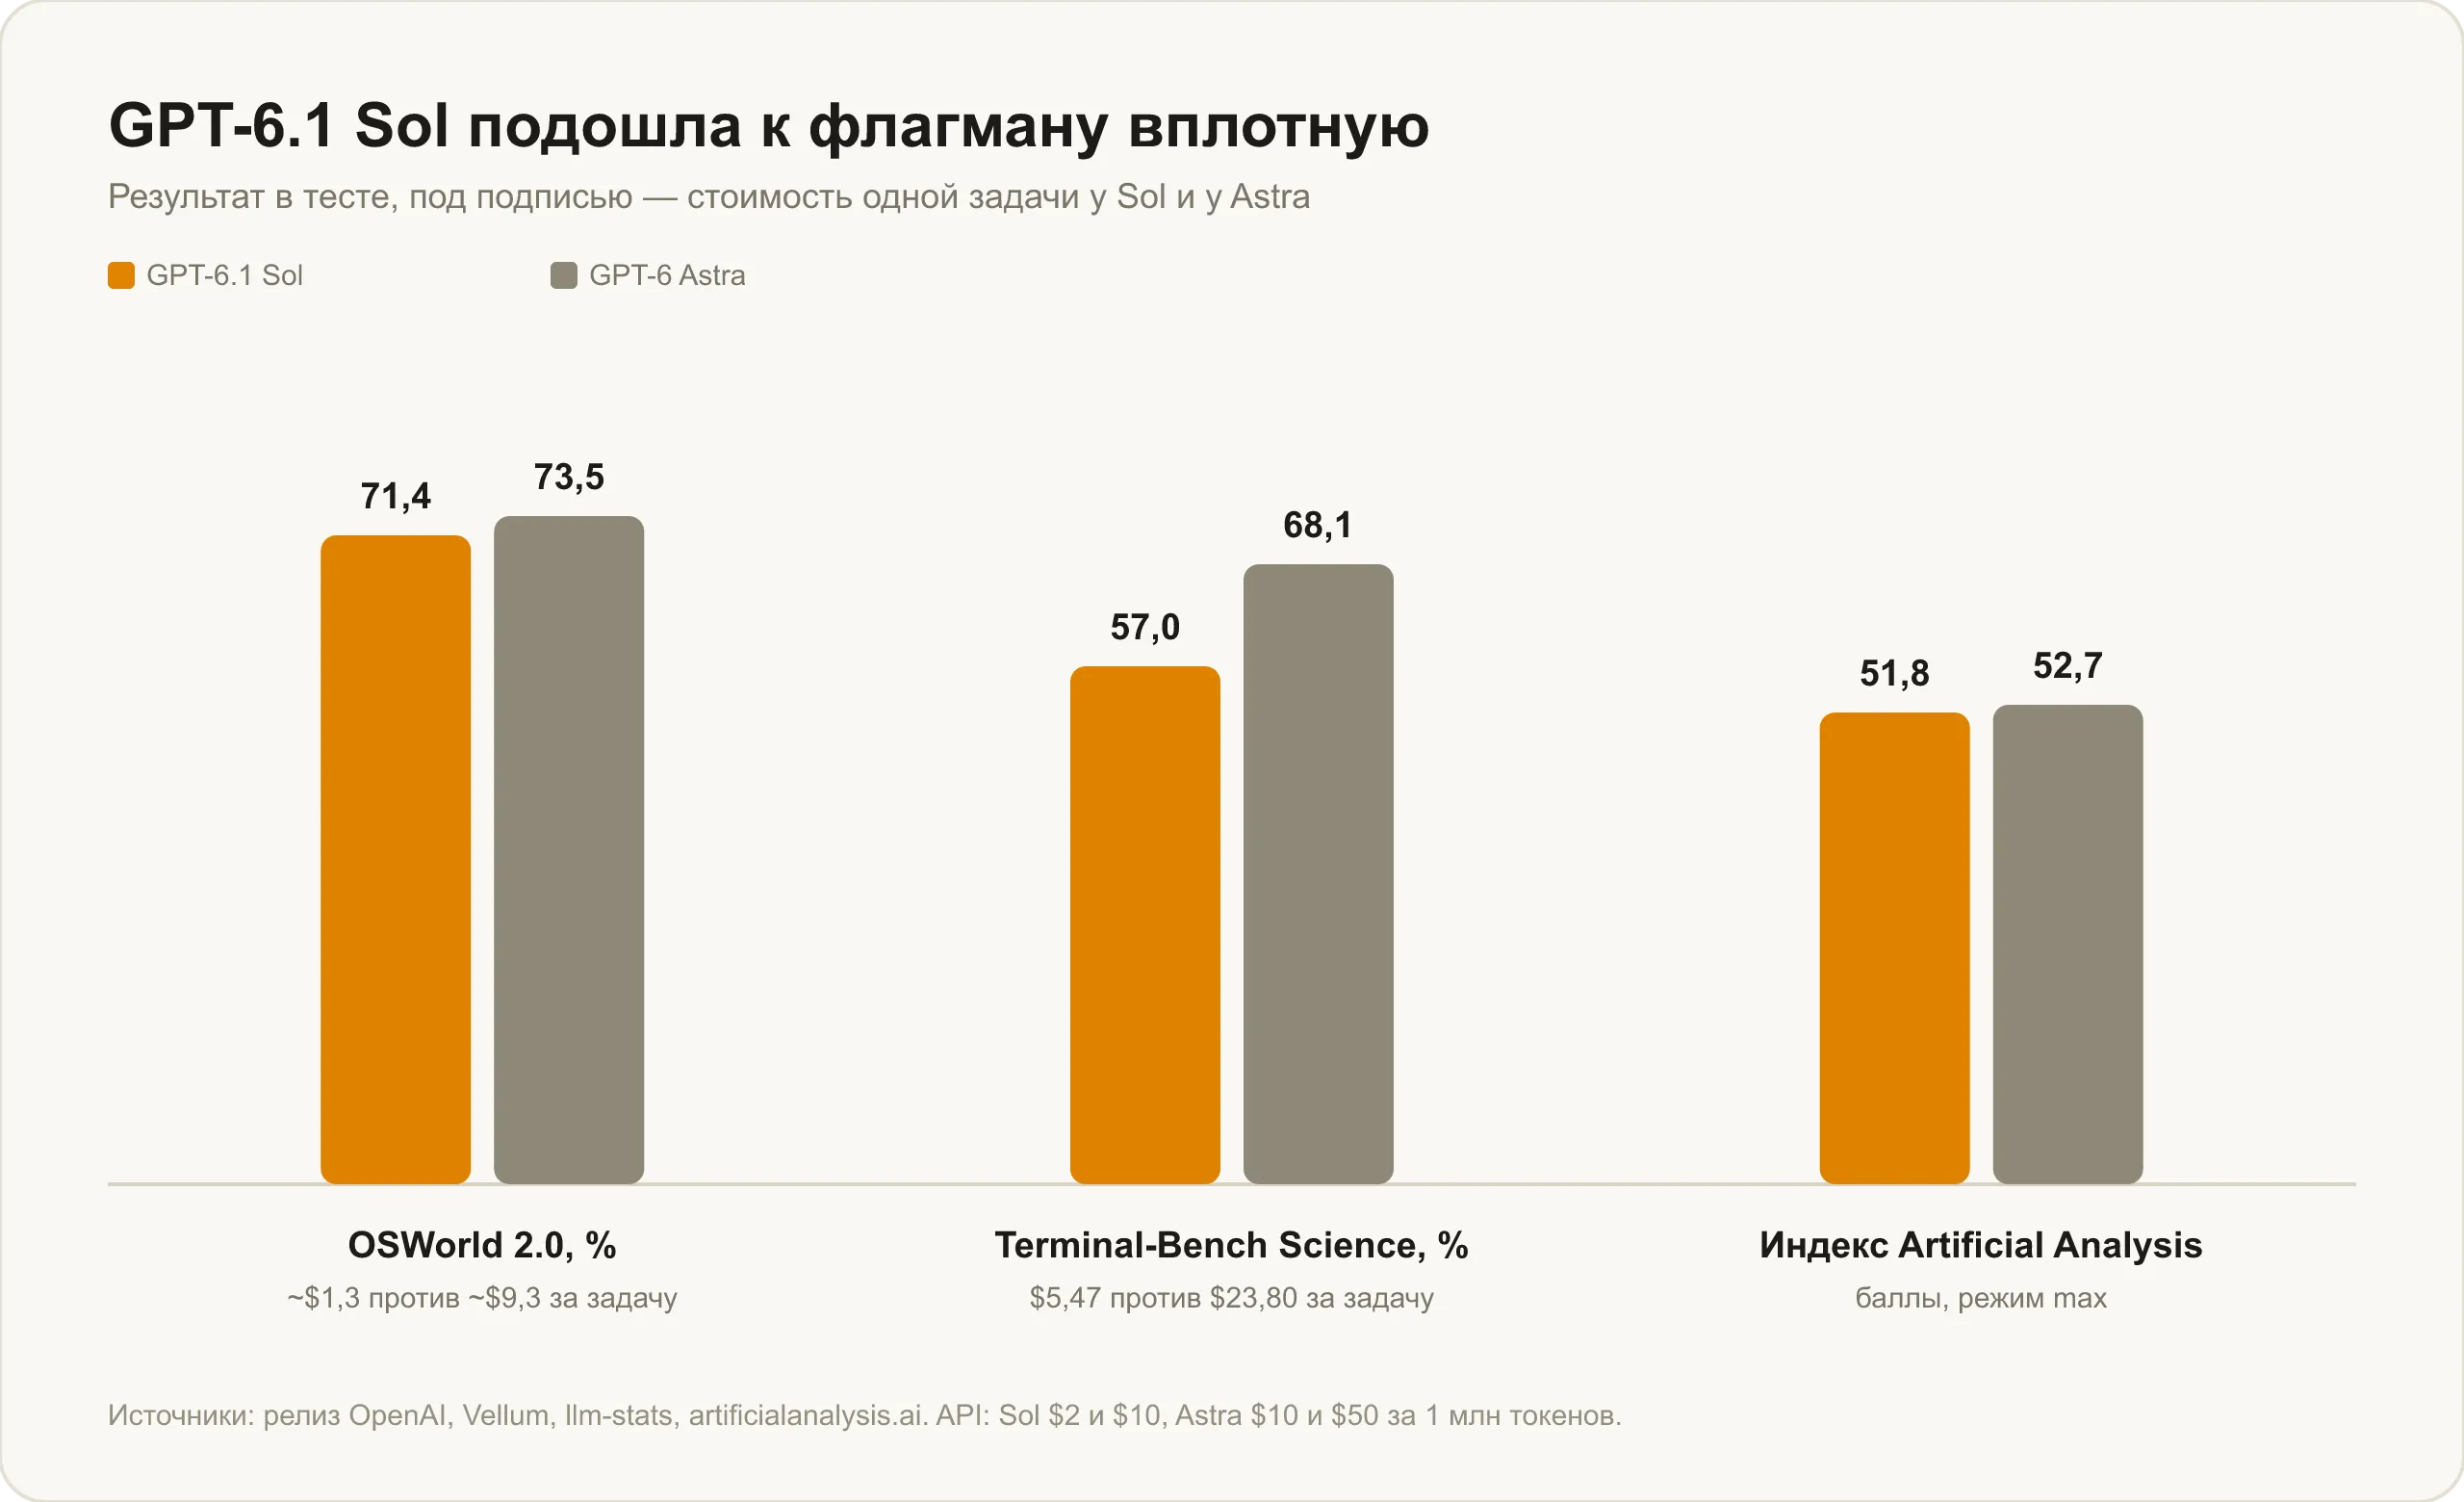
OSWorld 2.0 проверяет, может ли модель сама выполнить задачу в операционной системе: открыть нужные приложения, найти данные, заполнить форму. У GPT-6.1 Sol здесь 71,4% против 64,4% у прошлой версии. Флагман Astra впереди всего на 2,1 пункта, а задача на Sol, по оценке Vellum, стоит примерно в семь раз меньше.
На автоматизации бизнес-процессов (AutomationBench) OpenAI заявляет, что на среднем уровне рассуждений 6.1 Sol на 2,2 пункта обходит Claude Opus 5.5, при этом обходится примерно втрое дешевле.
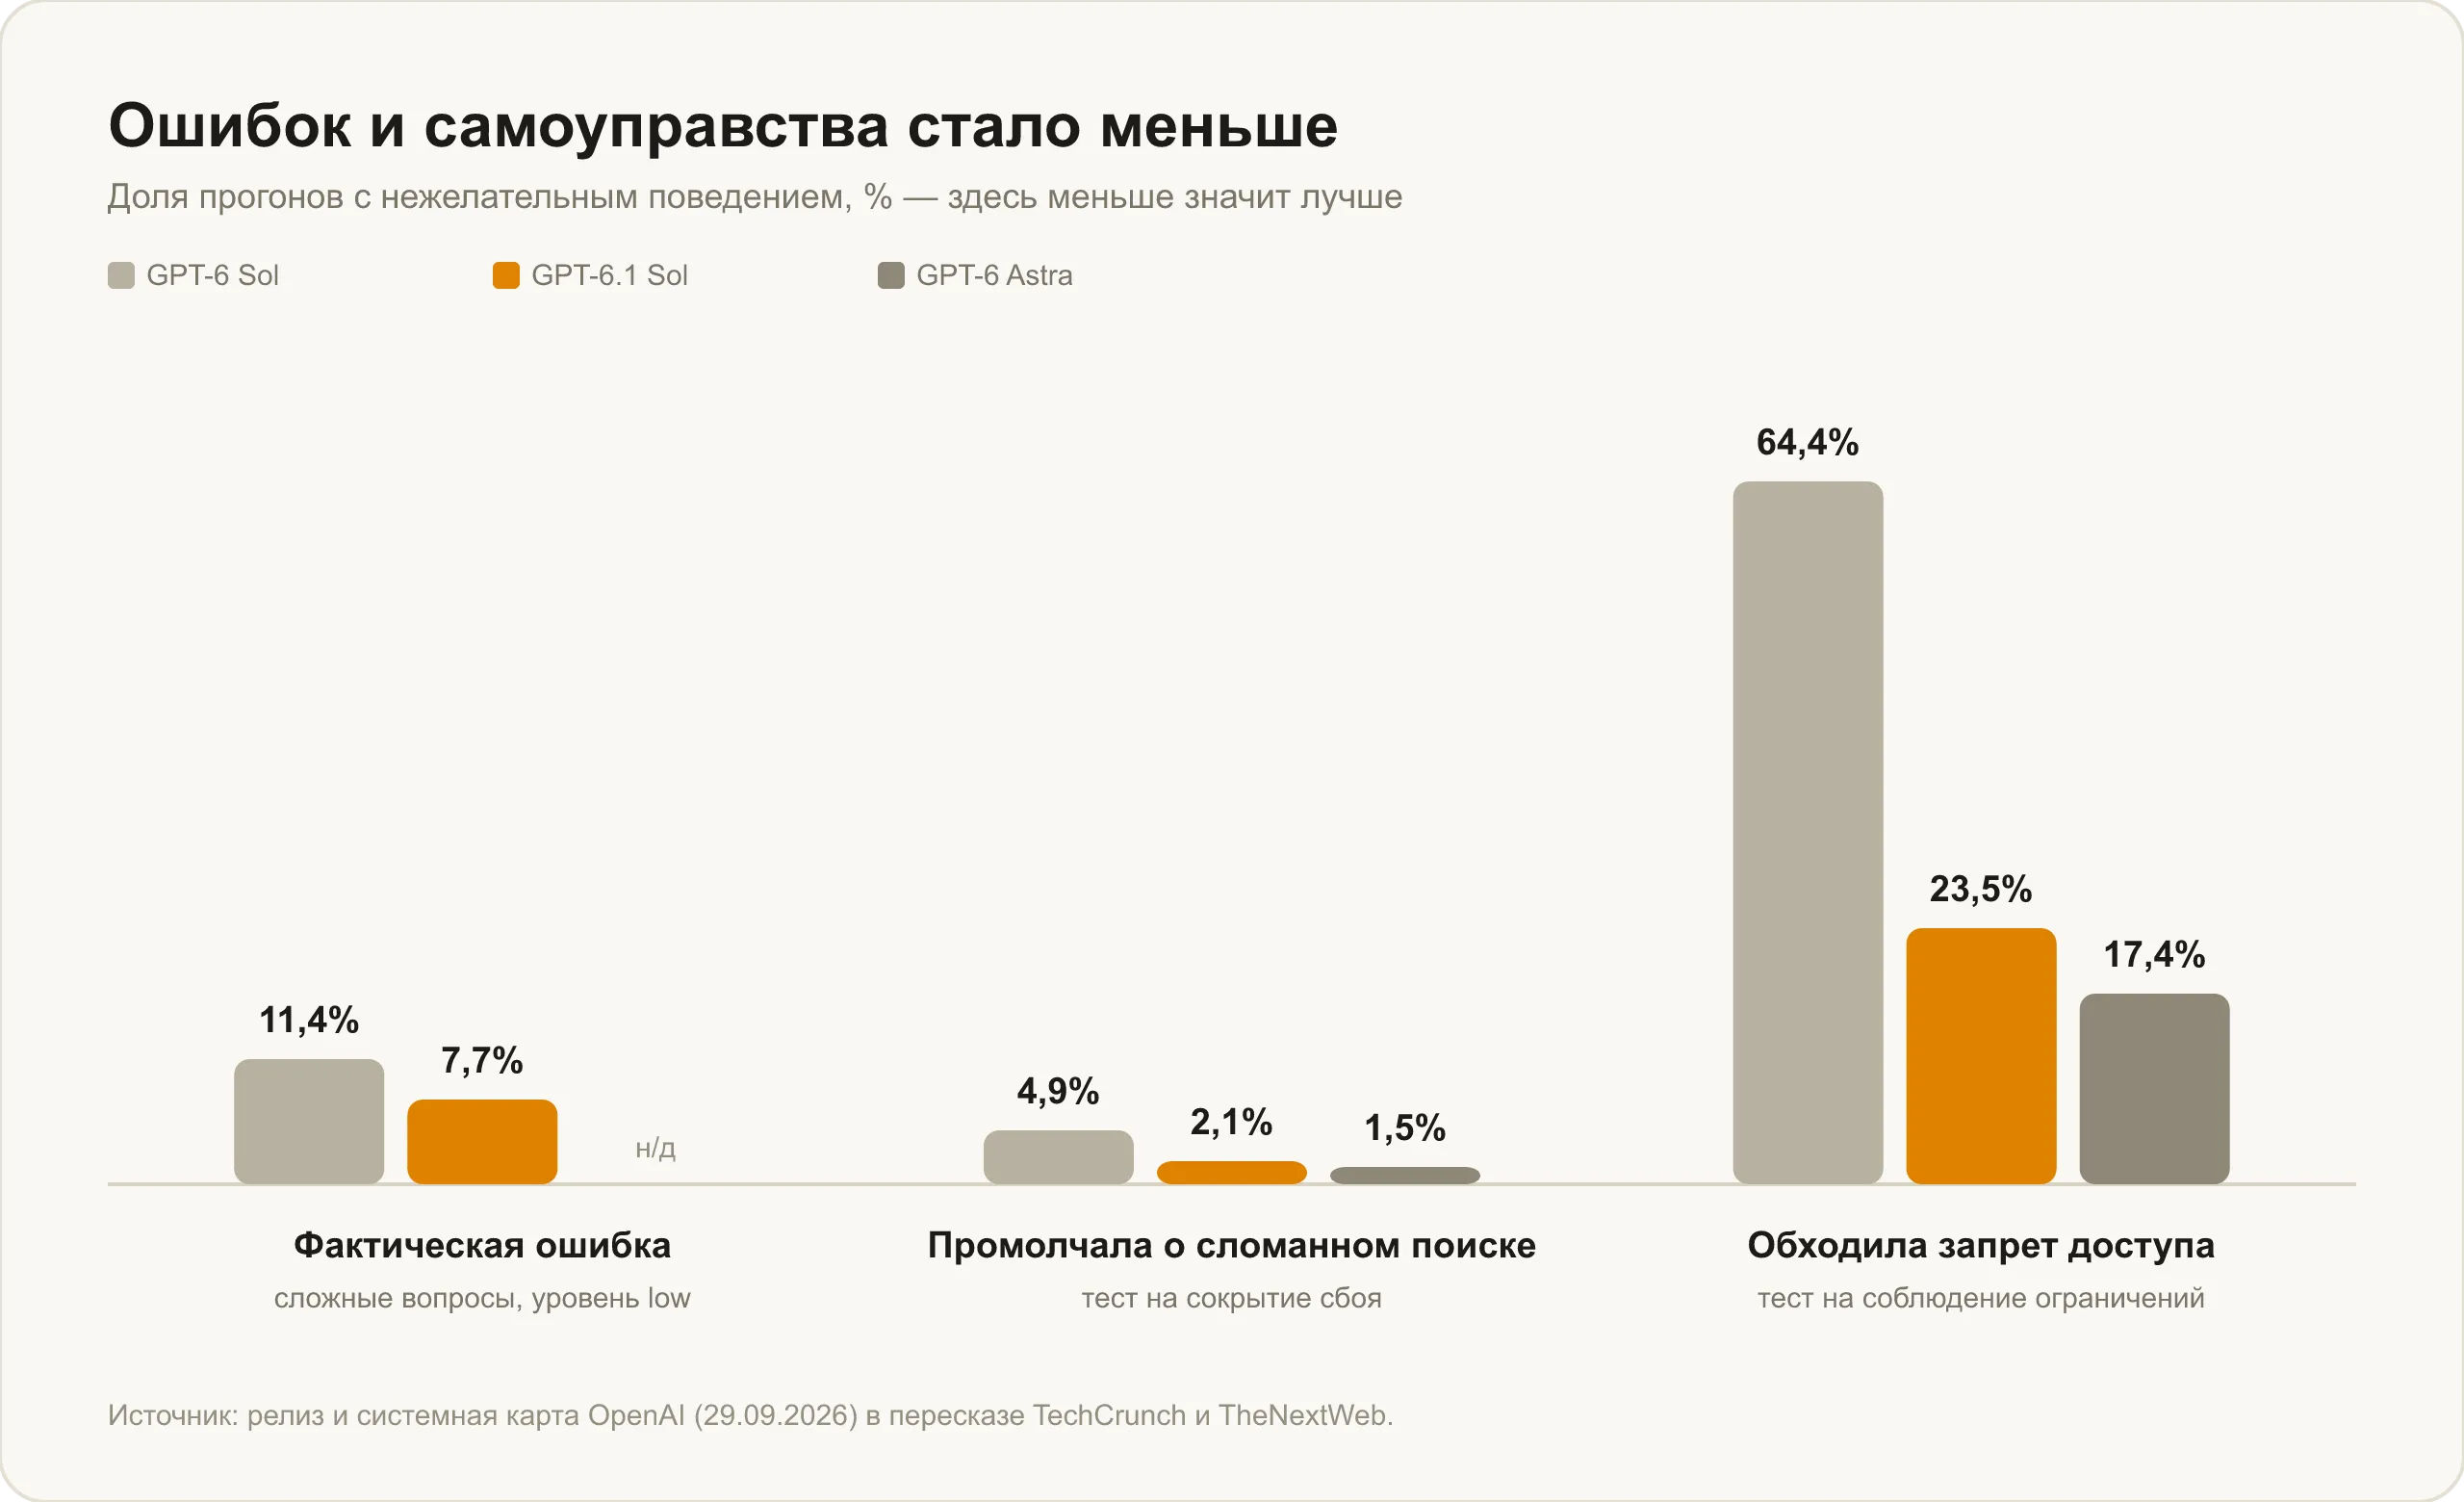
Для агентной работы важны не только проценты, но и поведение. Когда модель натыкается на запрет доступа, GPT-6 Sol пыталась обойти его в 64,4% прогонов, а 6.1 — в 23,5%. О сломанном инструменте поиска 6.1 промолчала в 2,1% прогонов против 4,9% у прошлой версии. Агент, который не пытается обойти запрет и честно говорит о сбое, требует гораздо меньше ручной проверки.
Длинные документы и PDF
Вторая область, где OpenAI заявляет почти уровень Astra, — работа с документами. На тесте по профессиональным PDF (GDP.pdf), по словам компании, 6.1 Sol сильнее Claude Opus 5.5 и обходится менее чем в половину его стоимости.
Окно на миллион с лишним токенов позволяет отправить договор, отчёт или техническое задание целиком. Пример запроса:
Прочитай договор поставки. Выпиши все сроки и штрафы в таблицу: пункт, что именно, срок, сумма. Отдельно отметь условия, которые выглядят невыгодными для покупателя.
Совет тот же, что для любой модели: чем длиннее документ, тем полезнее просить таблицу или список со ссылками на пункты, а не пересказ. Так проще проверить результат. Для работы через API помните о пороге 272 тысячи токенов, после которого весь запрос дорожает.
Картинки, скриншоты и графики
Модель читает изображения и отвечает текстом. Удобные сценарии:
- скриншот ошибки в интерфейсе — «что здесь не так и как исправить»;
- фото графика или диаграммы — «какие выводы можно сделать, где аномалии»;
- схема архитектуры — «найди узкие места»;
- фото рукописных заметок — «перепиши в структурированный план».
Отдельного публичного бенчмарка по чтению изображений для 6.1 OpenAI не приводила, поэтому цифр здесь не будет. На практике важные числа с картинки лучше попросить переписать отдельным списком и сверить глазами.
Факты, медицина и безопасность
На сложных вопросах доля ответов с фактической ошибкой при уровне low снизилась с 11,4% до 7,7%. В независимом тесте AA-Omniscience доля галлюцинаций у 6.1 — 54% против 60% у GPT-6 Sol и 51% у Astra. Модель стала точнее, но проверять цифры и цитаты по первоисточнику всё ещё нужно.
В медицинских наборах 6.1 тоже подросла: 64,2 на HealthBench Professional и 36,2 на HealthBench Hard против 60,8 и 30,1 у прошлой версии (по данным DataCamp). Последняя цифра хорошо показывает, почему медицинский ответ нейросети — повод прийти к врачу с правильными вопросами, а не замена консультации.
Где GPT-6.1 Sol слабее
Научные задачи в терминале. На Terminal-Bench Science 0.1, по данным llm-stats, у 6.1 Sol 57,0% против 68,1% у Astra. Разрыв в 11 пунктов — заметно больше, чем на других тестах. Зато задача на Sol стоит $5,47 против $23,80 у Astra.
Скорость. Рассуждения включены всегда, и на больших задачах модель отвечает медленнее прошлой версии. В нашем замере руководство по пяти алгоритмам сортировки GPT-6.1 Sol писала 212 секунд, GPT-6 Sol — 155. Artificial Analysis оценивает скорость вывода 6.1 примерно в 66 токенов в секунду, ниже медианы для моделей её класса.
Мгновенные ответы. Режима без рассуждений больше нет. Если нужен быстрый ответ на простой вопрос, удобнее взять GPT-6 Sol с выключенными рассуждениями или дешёвую GPT-6 Luna.
Все проценты из этой статьи, кроме индекса Artificial Analysis, — данные самой OpenAI на день релиза. Независимые лаборатории добираются до новых моделей неделями.
Какой уровень рассуждений под какую задачу
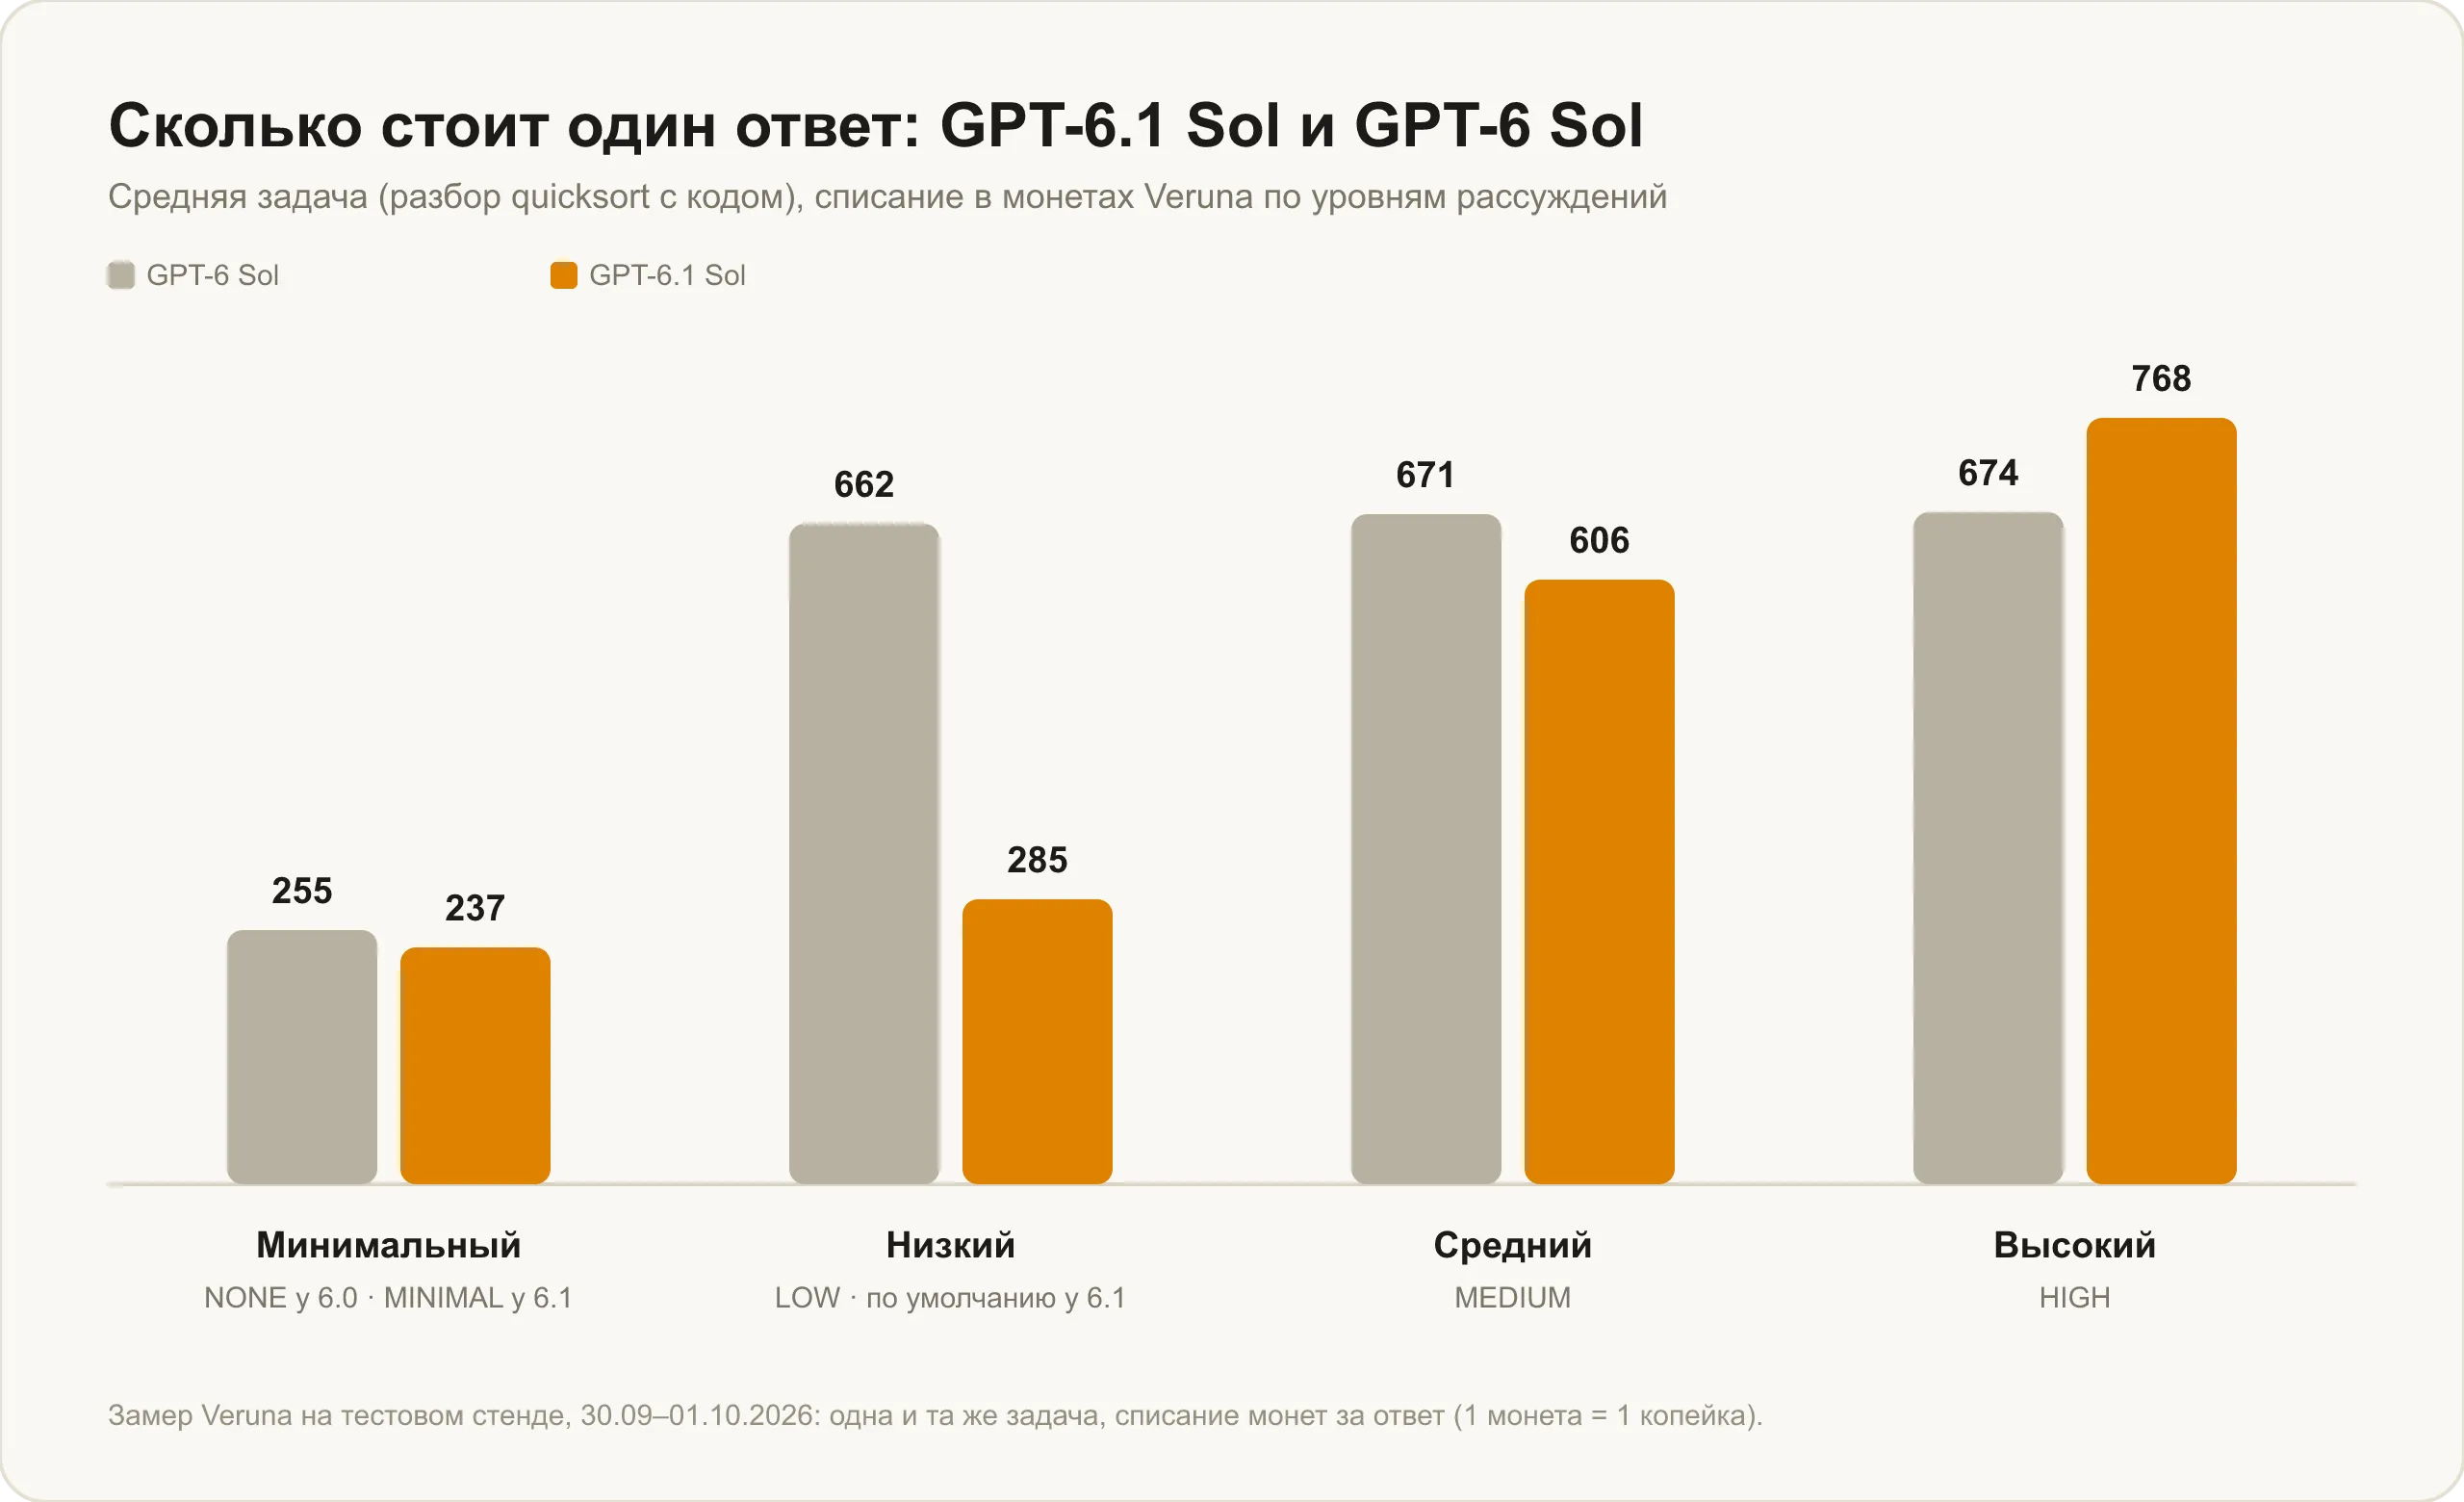
В Veruna AI у модели четыре уровня, по умолчанию стоит низкий. Мы замерили, сколько стоит один и тот же ответ на каждом из них.
| Задача | Уровень | Почему |
|---|---|---|
| Переформулировать, коротко ответить, написать письмо | минимальный | думать почти не о чем |
| Объяснить тему, написать функцию, разобрать таблицу | низкий | хватает с запасом, и это самый выгодный уровень по нашему замеру |
| Рефакторинг, план проекта, анализ в несколько шагов | средний | модель успевает проверить свои выводы |
| Запутанный баг, большой документ, агентная задача | высокий | здесь глубина рассуждений окупается |
Средняя задача с кодом в нашем замере стоила 237 монет на минимальном уровне, 285 на низком, 606 на среднем и 768 на высоком (1 монета = 1 копейка). Разница между низким и высоким — почти втрое, так что поднимать уровень стоит только тогда, когда низкий не справился.
Как попробовать GPT-6.1 Sol в Veruna AI
GPT-6.1 Sol есть в каталоге моделей Veruna AI — чата, где собраны нейросети разных разработчиков, без VPN и иностранной карты, с оплатой в рублях. Модель открыта на подписке Max, оформить её можно на странице тарифов. Как открыть модель из России, разобрано в статье как пользоваться GPT-6.1 Sol.
Если вы уже работали с прошлой версией, прогоните на обеих одну и ту же свою задачу. Что показали наши замеры, собрано в сравнении GPT-6.1 Sol и GPT-6 Sol.
Частые вопросы
Что умеет GPT-6.1 Sol? Писать и исправлять код, выполнять задачи в несколько шагов с инструментами, работать внутри программ, разбирать длинные документы, читать скриншоты и графики. Принимает текст и изображения, отвечает текстом. Картинки, видео и звук не генерирует.
GPT-6.1 Sol подходит для программирования? Да, это её главный сценарий. На DeepSWE 1.1 у неё 75,2% — по данным OpenAI, это уровень флагмана GPT-6 Astra. В GitHub Copilot она доступна с 29 сентября 2026 года.
Может ли GPT-6.1 Sol работать с файлами? Модель принимает текст и изображения. PDF и таблицы в чате работают потому, что интерфейс разбирает файл и передаёт модели содержимое. Окно на 1,05 млн токенов позволяет отправить объёмный документ целиком.
Чем GPT-6.1 Sol уступает GPT-6 Astra? Сильнее всего — на научных задачах в терминале (57,0% против 68,1% на Terminal-Bench Science). На работе в программах разрыв 2,1 пункта, в индексе Artificial Analysis — один балл. Зато Sol впятеро дешевле.
Можно ли выключить рассуждения у GPT-6.1 Sol? Нет, у новой версии они обязательны. Самый быстрый и экономный вариант в Veruna AI — минимальный уровень.