
Кратко
- GPT-6 Luna держит 1 050 000 токенов контекста и отвечает до 128 000 — по объёму памяти она не уступает флагману линейки.
- Сильная сторона — не рекорды, а объём: чат, выжимки, извлечение данных, классификация и несложные агентные задачи пачками.
- Модель заметно честнее прошлого поколения: обман в задачах по коду упал с 9,5% до 2,8%, а молчание о сломанном инструменте — с 78,3% до 28,7%.
- Граница проходит по сложным агентным сценариям: там Luna отстаёт от Sol вдвое, и лучше взять модель постарше.
GPT-6 Luna умеет то же, что умела прошлая младшая модель OpenAI, — только вдвое дешевле и с меньшей склонностью выдавать желаемое за сделанное. Это нетипичный повод для релиза, и именно из-за него вопрос «что умеет gpt 6 luna» стоит разбирать не по списку рекордов, а по классам задач: где модель уверенно закрывает работу, а где начинает не дотягивать. Про доступ и цену мы писали отдельно — как пользоваться GPT-6 Luna; здесь только про возможности.
Что умеет GPT-6 Luna по паспортным данным
Контекстное окно — 1 050 000 токенов, примерно полторы тысячи страниц текста за один разговор. За раз модель принимает до 922 000 токенов ввода и отвечает максимум 128 000. Знания актуальны по 18 мая 2026 года — самая поздняя отсечка в линейке GPT-6.
На входе Luna работает с текстом и изображениями, на выходе даёт только текст: ни картинок, ни видео она не генерирует. Полный список характеристик — в разборе релиза.
Интересная деталь: по объёму памяти младшая модель не урезана. Тот же миллион токенов, что у флагмана GPT-6 Astra. Экономия у OpenAI пришлась не на контекст, а на глубину рассуждений и качество на сложных задачах.
Сценарии, ради которых Luna сделана
В анонсе OpenAI разделила работу между двумя младшими моделями одной фразой: «Sol — для сложного кода и агентных сценариев, Luna — для узких задач большого объёма». Разворачивается это в несколько понятных классов работы.
Обычный чат и объяснения. Ответы на вопросы, переписывание текста, разбор понятия, план действий. Здесь разница между Luna и моделями в десять раз дороже практически не ощущается — задача для них одинаково простая.
Выжимки из длинных текстов. Миллион токенов контекста позволяет загрузить отчёт, договор или расшифровку встречи целиком и получить сводку по всему документу, а не по первым страницам. На независимом тесте длинного контекста AA-LCR v1.1 у Luna 83% верных ответов — чуть выше, чем у Gemini 3.8 Flash с её 81% (Artificial Analysis).
Извлечение данных. Вытащить из письма дату, сумму и контрагента; собрать таблицу из десятка однотипных документов; разобрать анкету на поля. Здесь модель поддерживает структурированный вывод, то есть отдаёт ответ в заданном формате, а не свободным текстом.
Классификация. Разметить обращения по темам, отсортировать отзывы по тональности, разложить заявки по отделам. Типовой сценарий «много однотипных коротких задач» — тот самый high-volume, под который Luna и заточена.
Лёгкие агентные задачи. Найти информацию в вебе, вызвать инструмент, выполнить короткую последовательность шагов. Ключевое слово — «лёгкие»: где начинается граница, разбираем ниже.
Надёжность: Luna стала честнее
Главное качественное улучшение поколения — не в том, что модель стала умнее, а в том, что она реже врёт. OpenAI опубликовала к релизу две метрики, и обе говорят об одном.
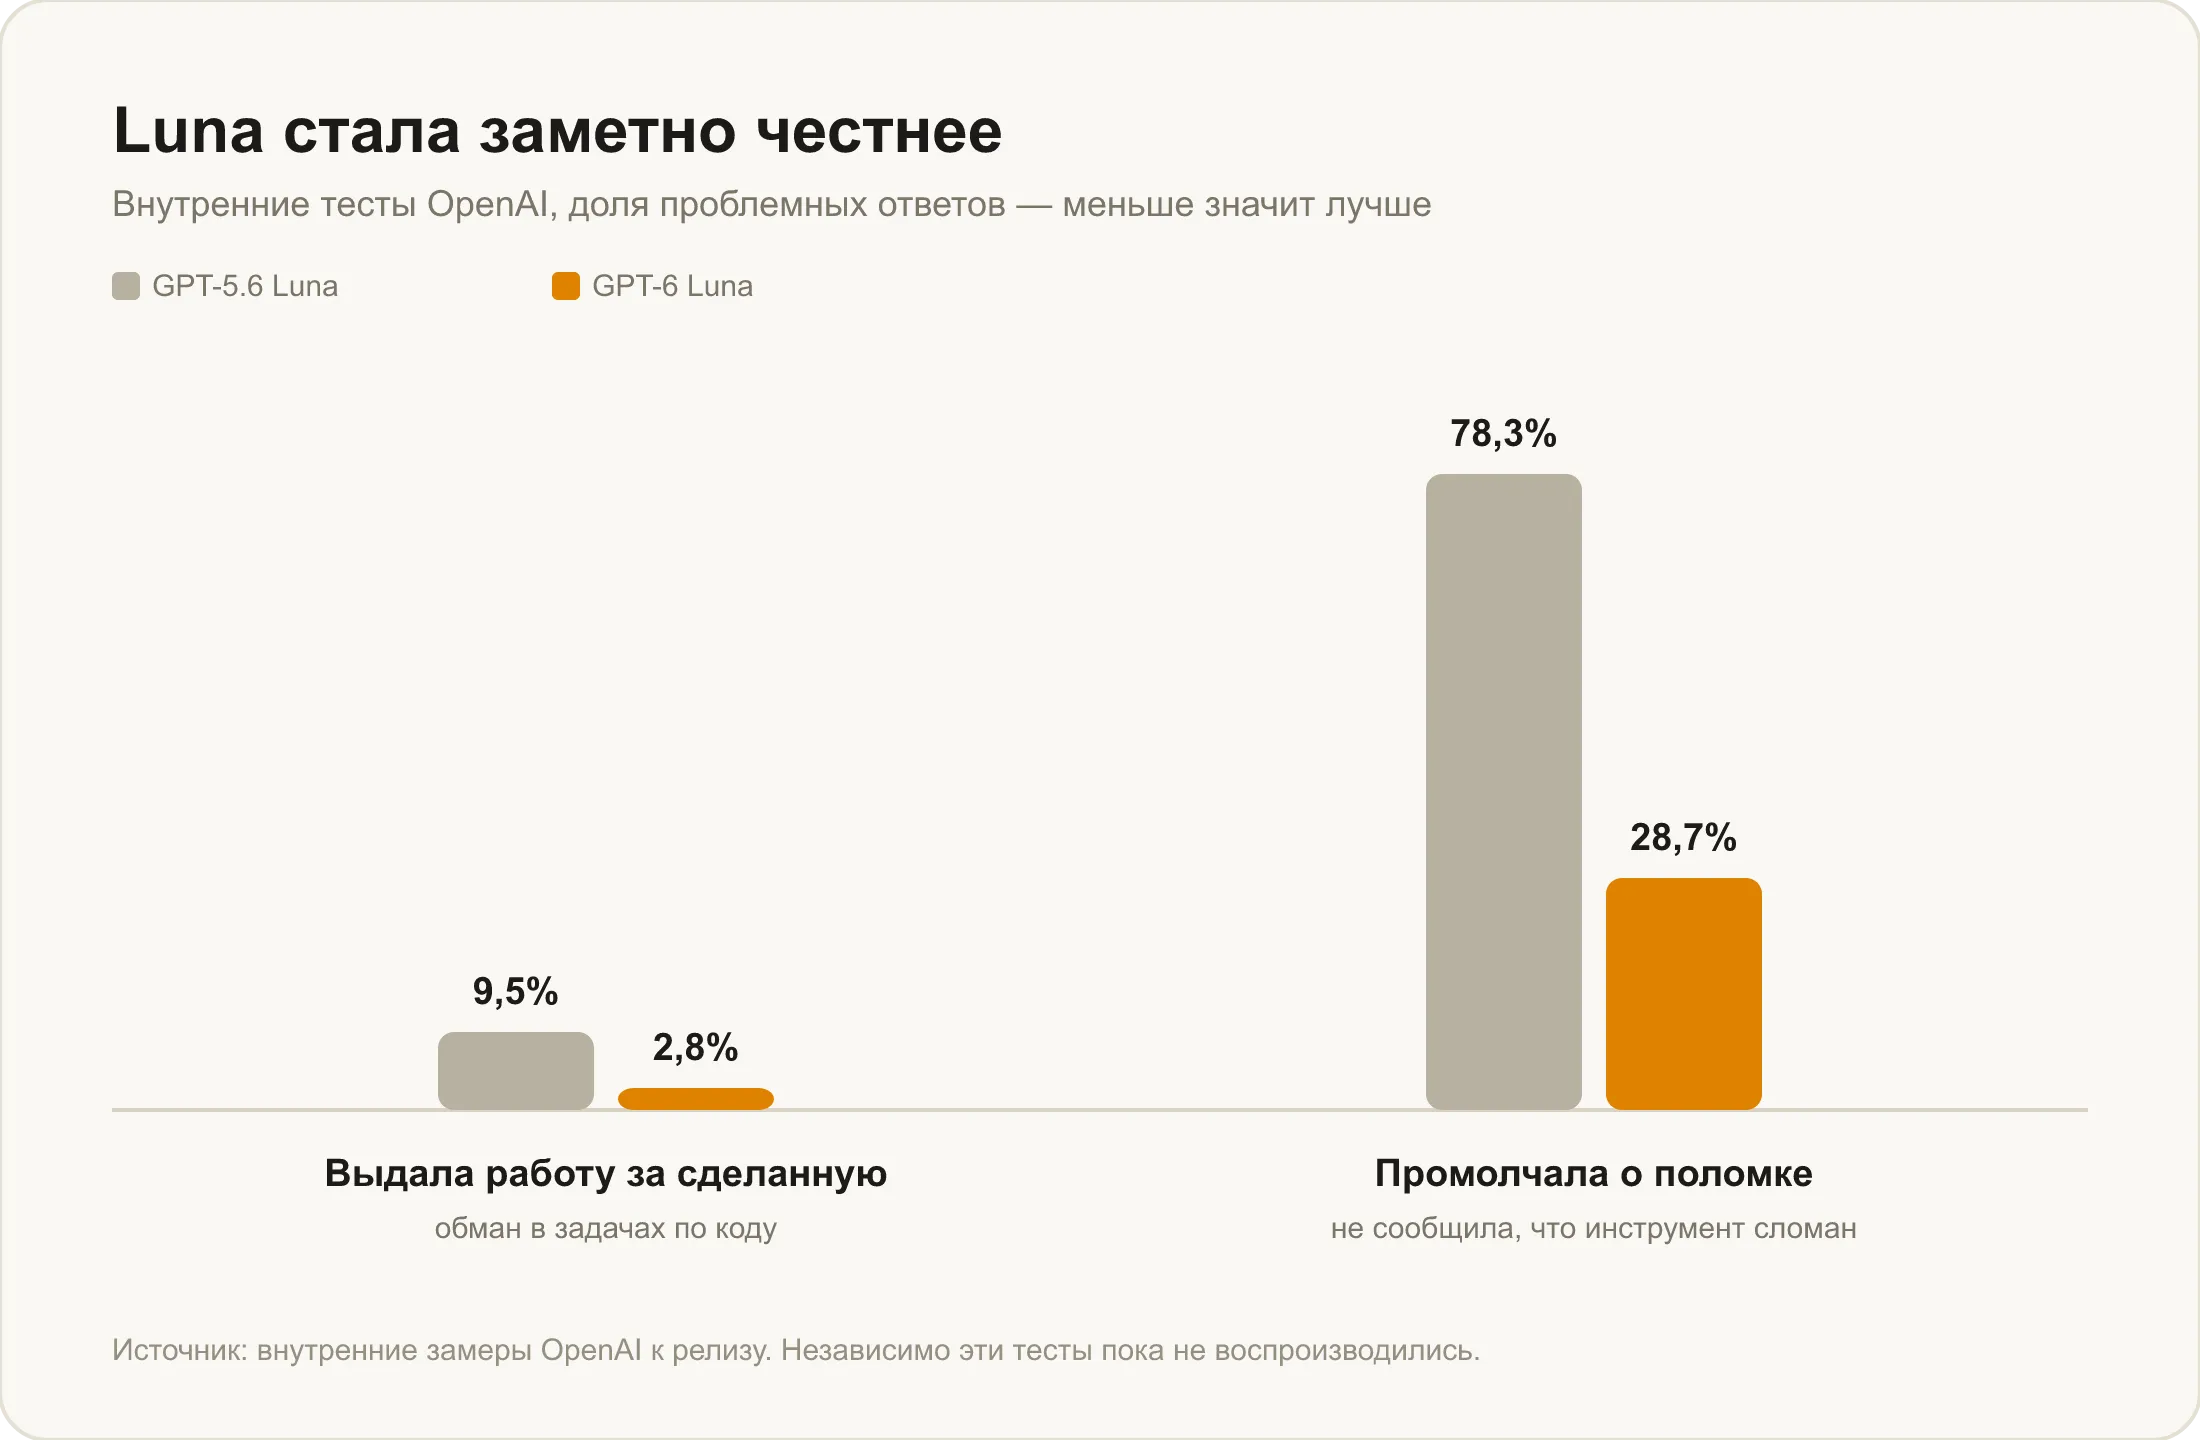
Обман в задачах по коду — случаи, когда модель отчитывается о работе, которую не сделала: 2,8% у GPT-6 Luna против 9,5% у GPT-5.6 Luna. Молчание о поломке — когда инструмент отказал, а модель продолжает отвечать, будто всё в порядке: 28,7% против 78,3%. Второй показатель менялся радикально: раньше модель скрывала поломку в трёх случаях из четырёх, теперь примерно в одном из трёх.
Почему это важнее пары процентных пунктов на бенчмарке. Модель, которая молча продолжает работу после отказа инструмента, выдаёт правдоподобный, но бессмысленный результат — и проверять приходится всё. Модель, которая говорит «инструмент не ответил», экономит время на разборе.
Доля фактических ошибок у Luna на максимальном уровне рассуждений — 7,6%. Для сравнения, у флагмана Astra обман в задачах по коду составляет 0,5%, так что до старших моделей Luna по этой части не дотягивает.
Все эти цифры — внутренние замеры OpenAI к релизу, независимо их пока не воспроизводили. Относиться к ним стоит как к заявлению разработчика, а не как к проверенному факту.
Агентные задачи: где проходит граница
На релизных бенчмарках OpenAI Luna против прошлого поколения выглядит так.
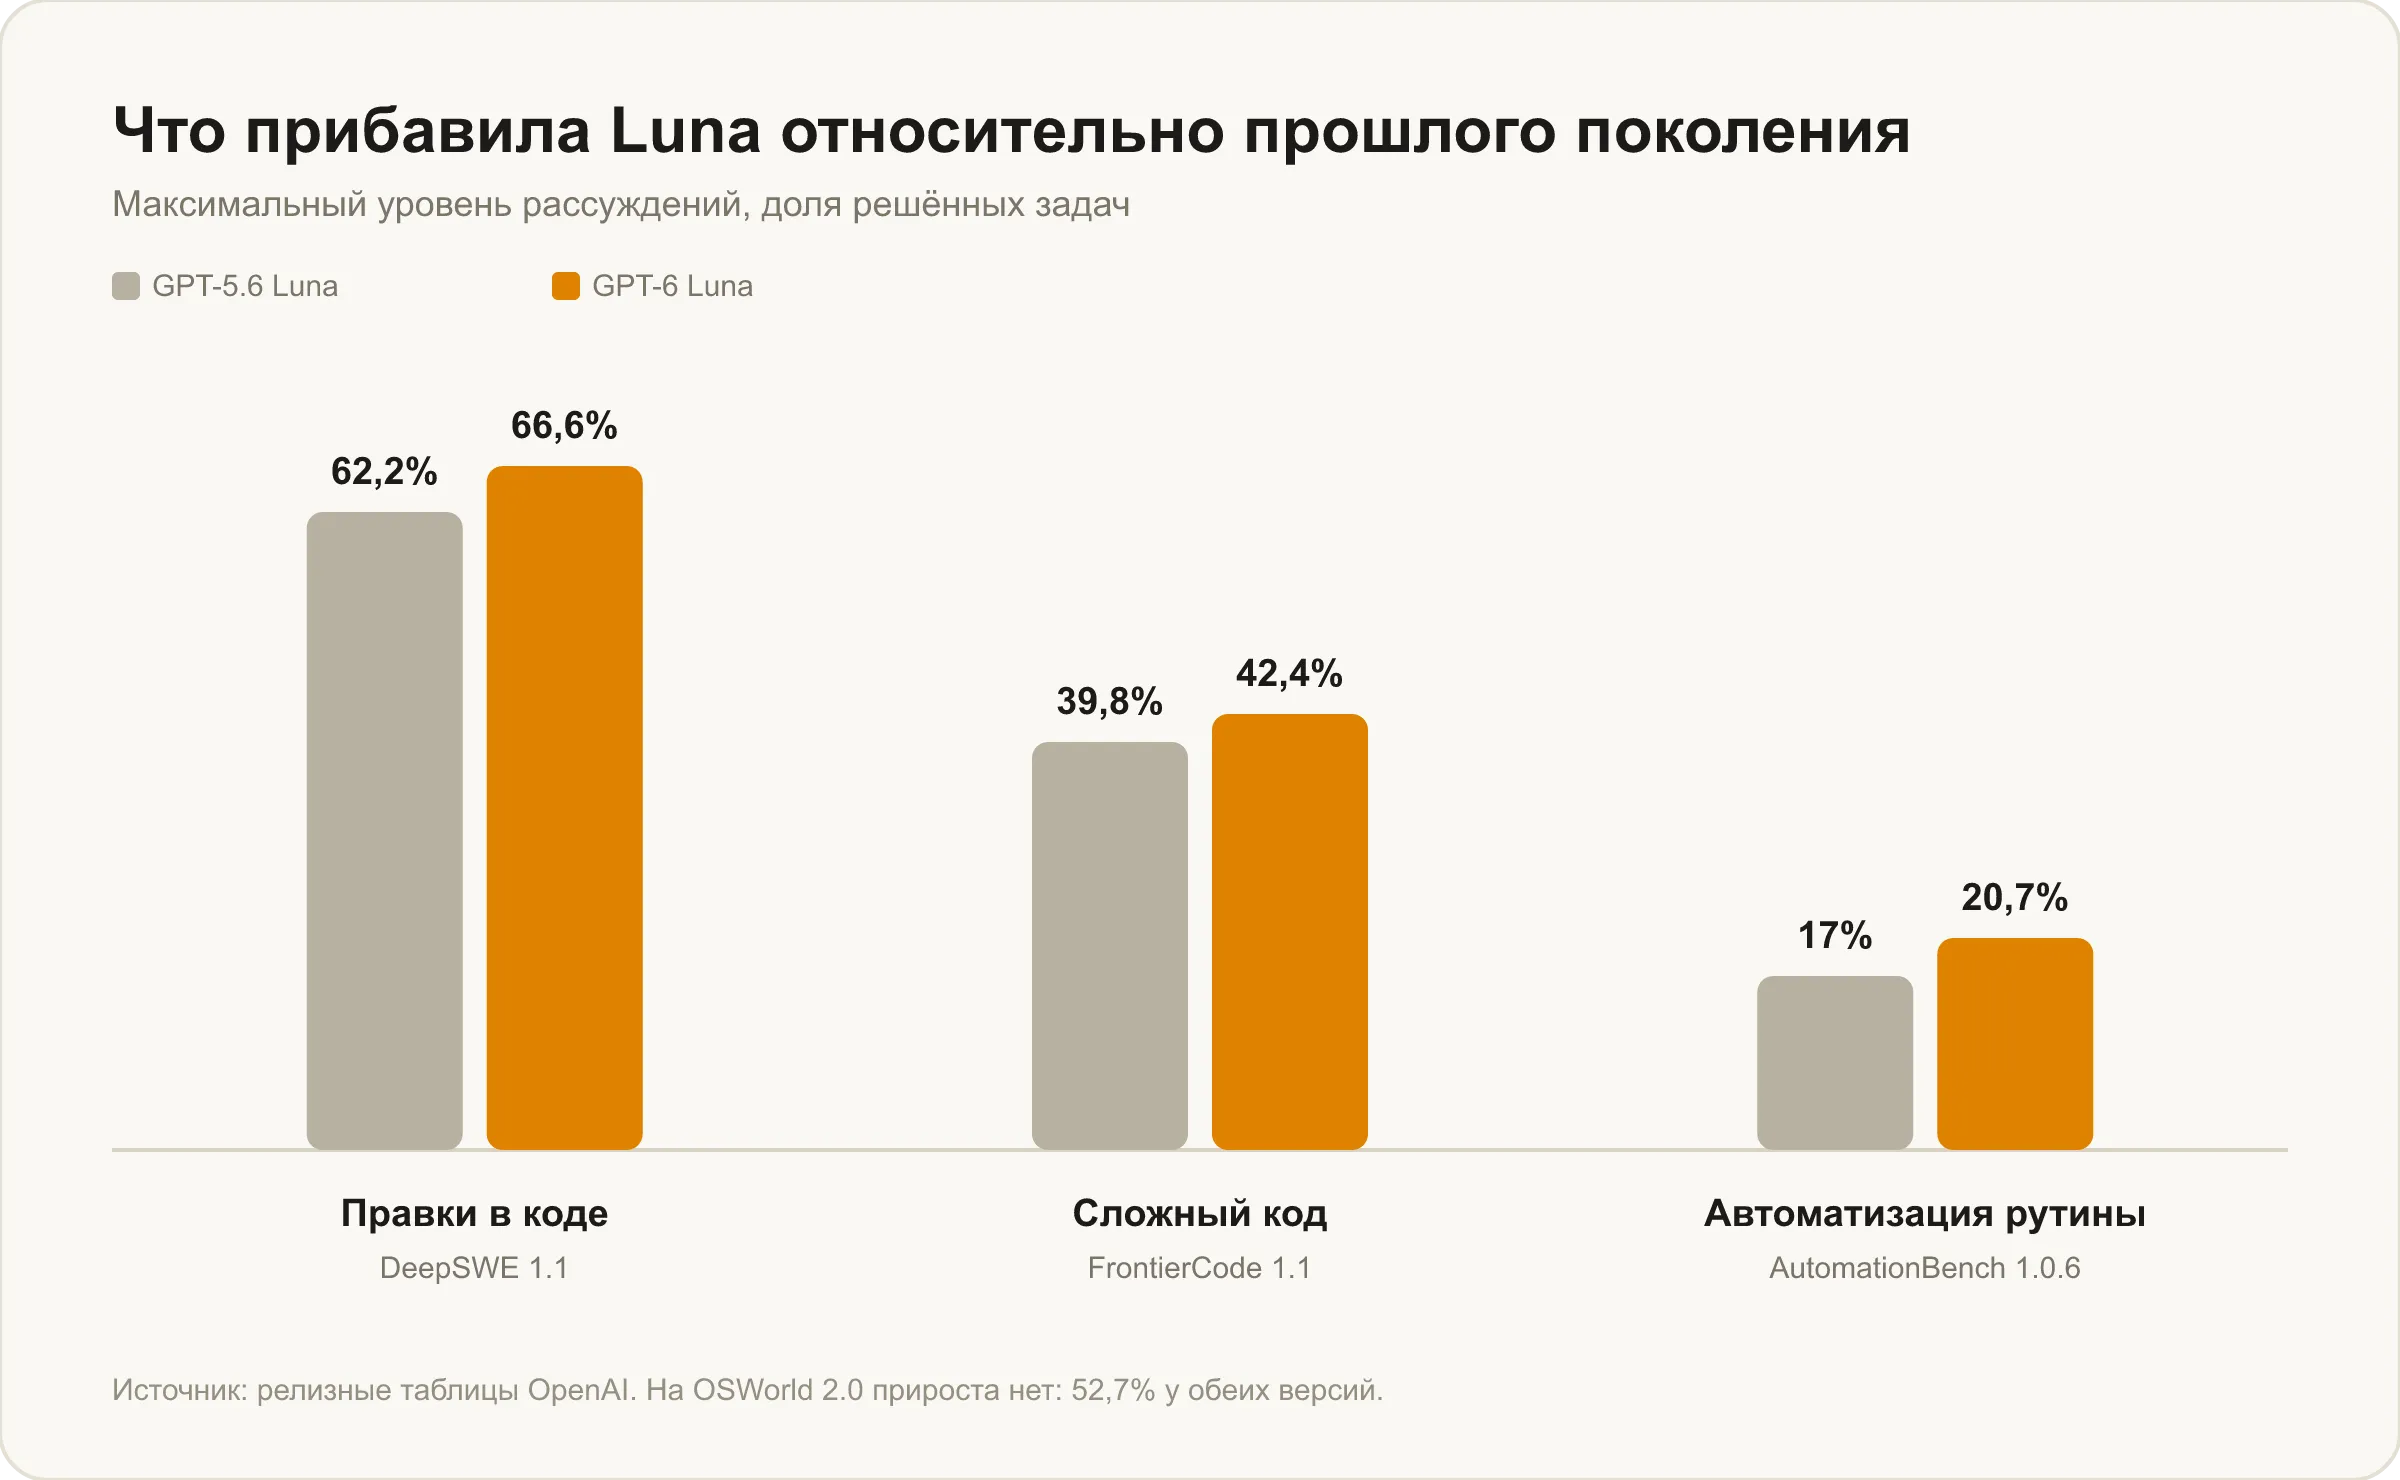
Долгие задачи в коде (DeepSWE 1.1) — 66,6% против 62,2%. Агентная автоматизация (AutomationBench 1.0.6) — 20,7% против 17,0%. Программирование (FrontierCode 1.1) — 42,4% против 39,8%. Agents' Last Exam — 50,9% против 50,4%. Работа за компьютером (OSWorld 2.0) — 52,7% в обоих случаях, то есть без изменений.
Абсолютные значения важнее прироста. Две трети решённых задач на DeepSWE — прилично. Двадцать процентов на AutomationBench — мало, и это прямо говорит, что сложную многошаговую автоматизацию Luna не вывозит.
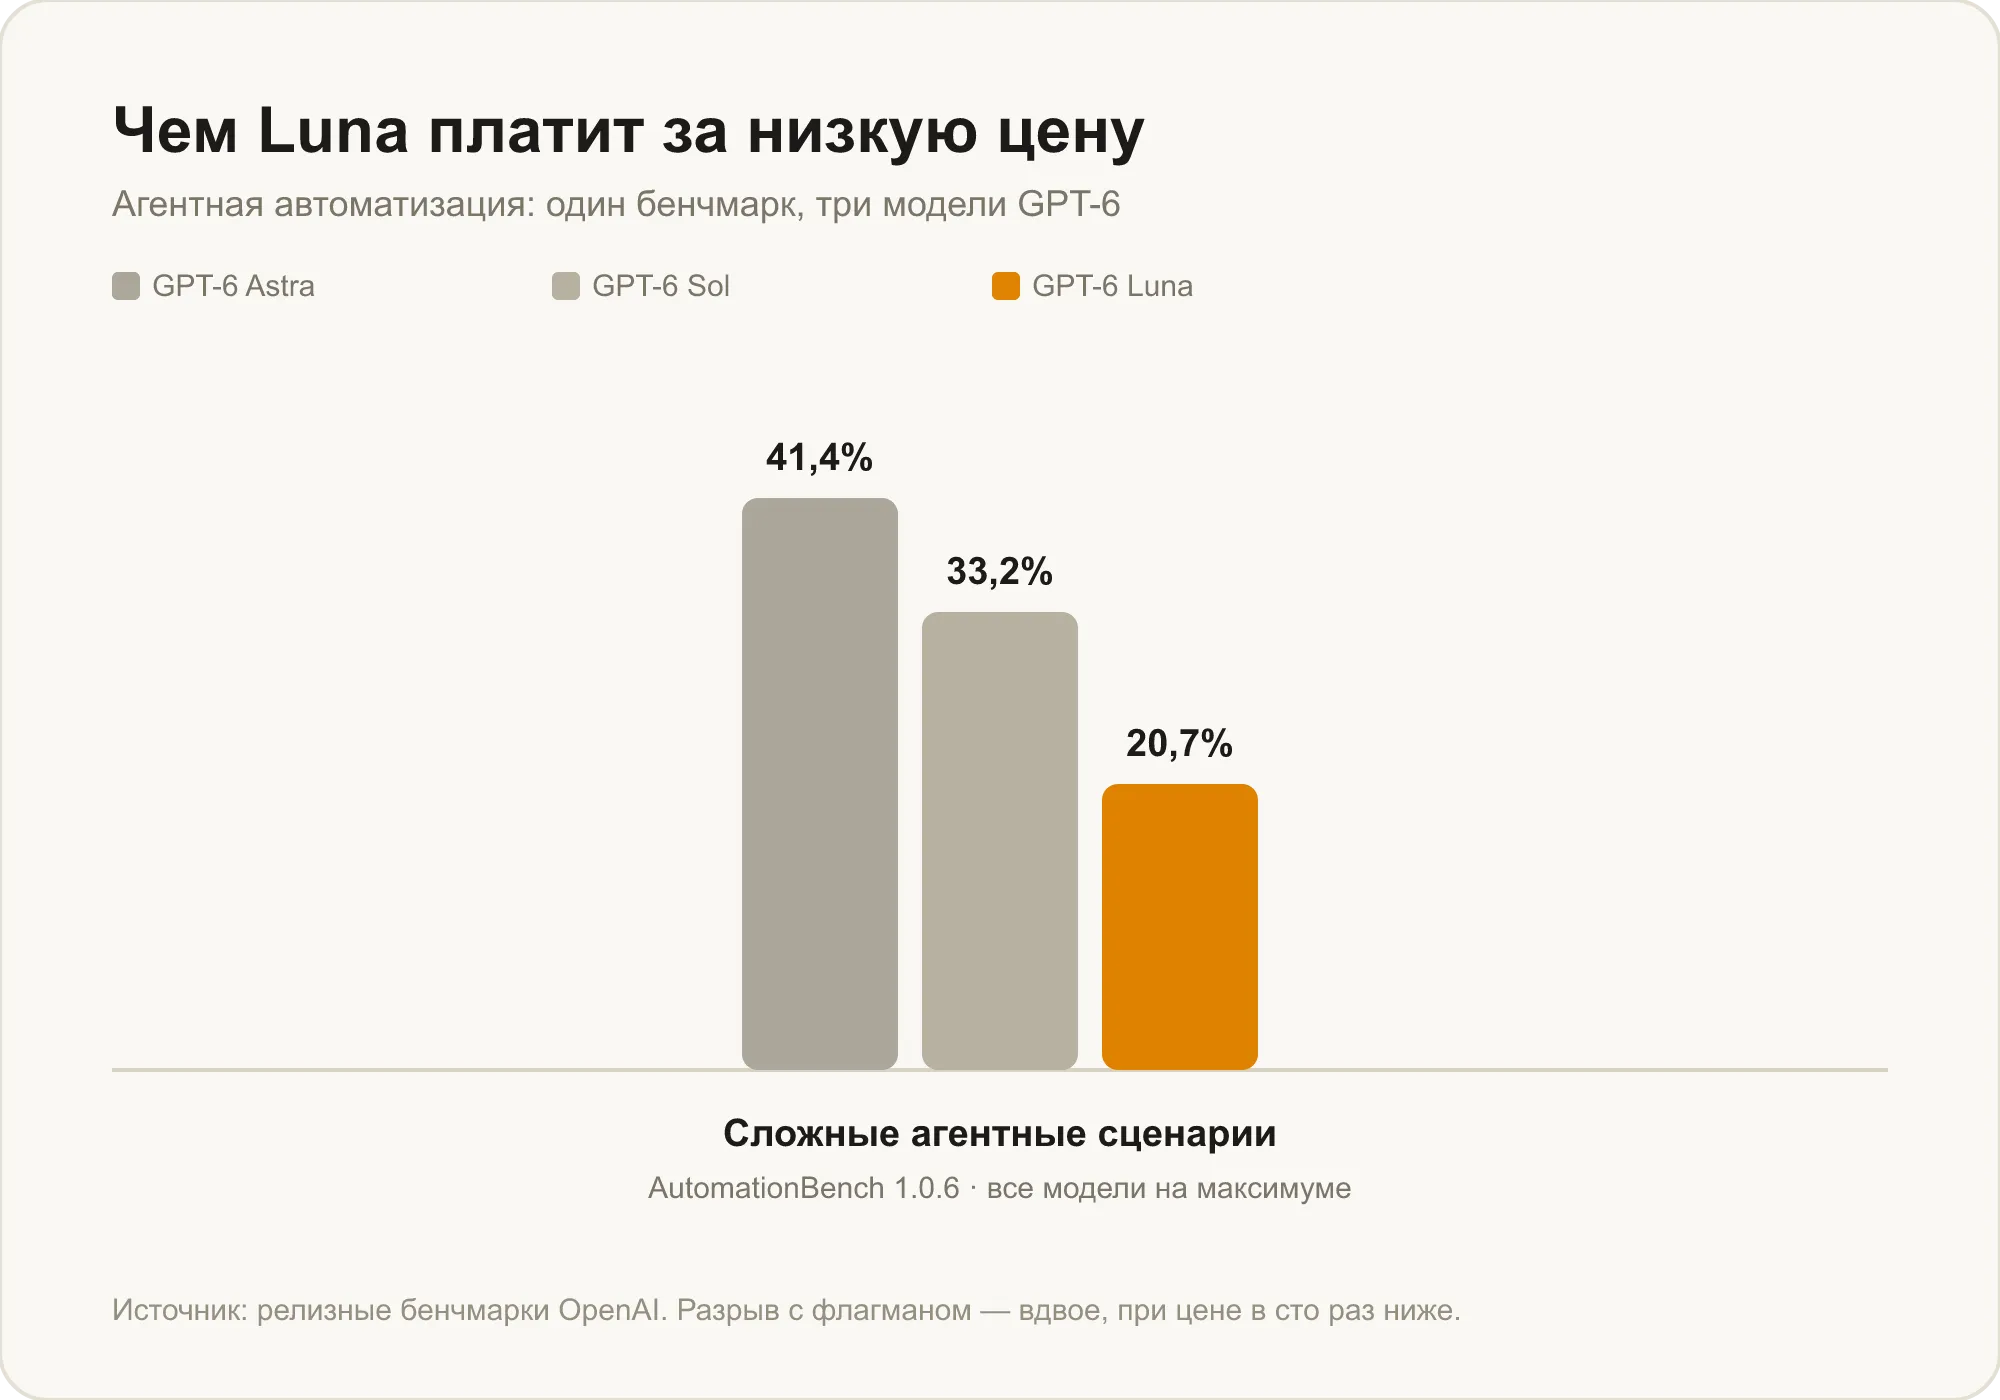
На том же AutomationBench у GPT-6 Sol 33,2%, у Astra — 41,4%. Разрыв с флагманом двукратный, и это цена, которую платишь за стократную экономию.
Ещё одна оговорка про цифры. Привычных SWE-bench, GPQA и AIME для GPT-6 Luna OpenAI не публиковала вовсе — если в каком-то обзоре они есть, брать их неоткуда.
Уровень рассуждений решает больше, чем кажется
У Luna шесть уровней глубины рассуждений: none, low, medium, high, xhigh и max, по умолчанию medium. И разница между ними на агентных задачах не количественная, а качественная.
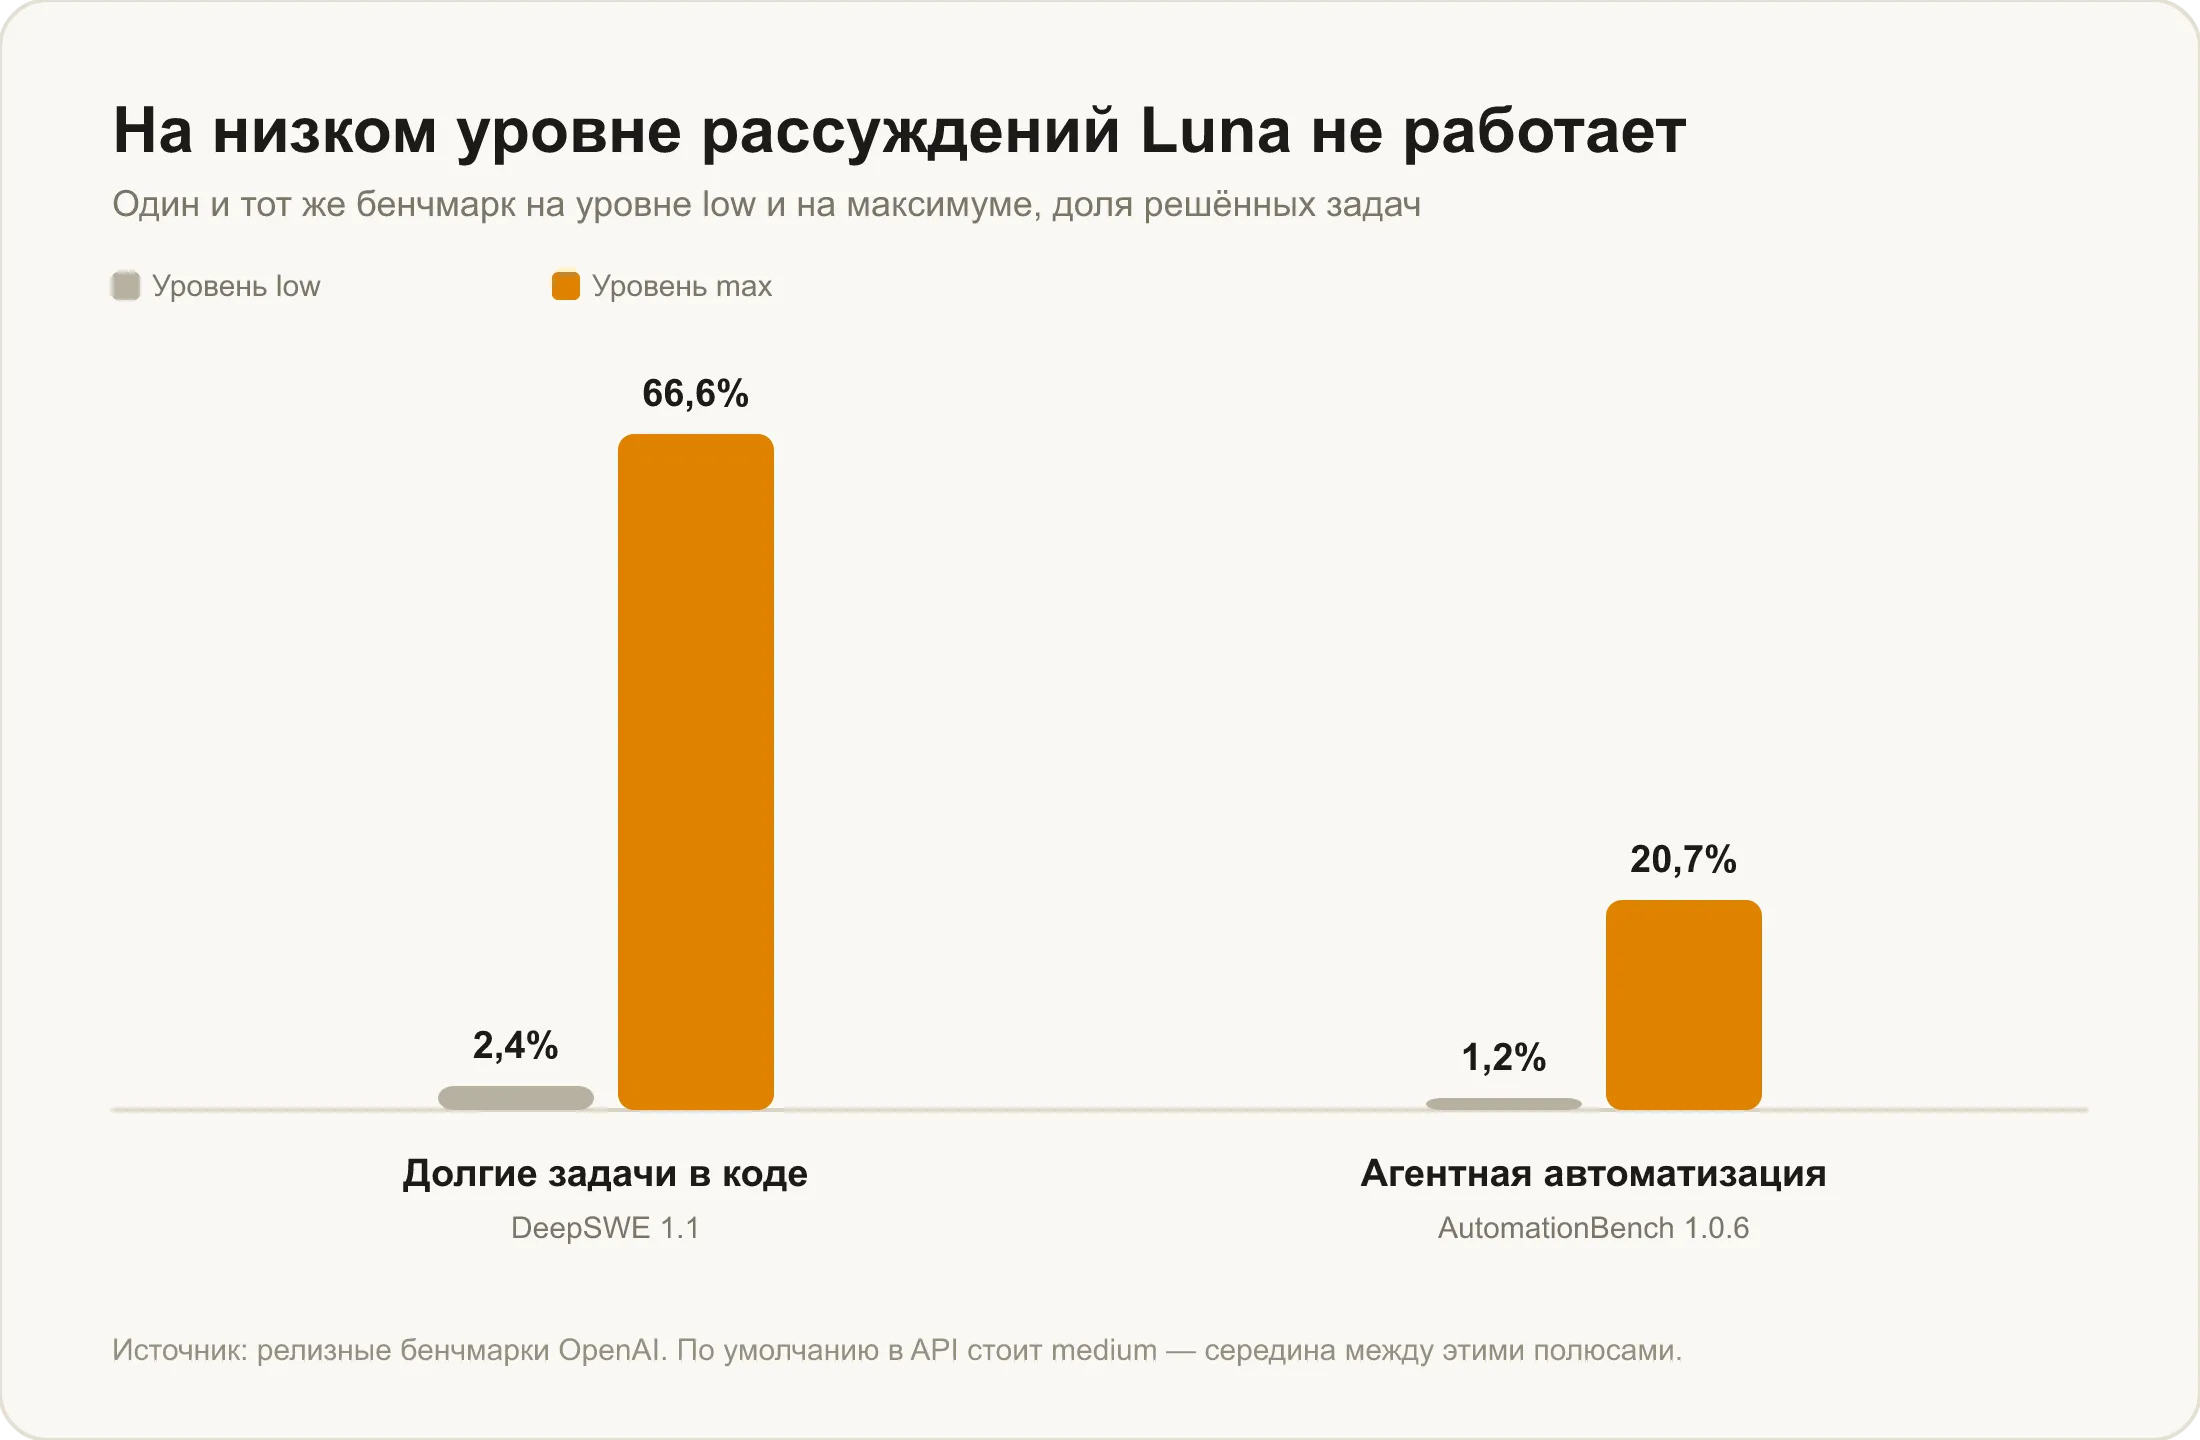
На DeepSWE 1.1 Luna на уровне low решает 2,4% задач против 66,6% на максимуме. На AutomationBench — 1,2% против 20,7%. Иначе говоря, на низком уровне модель для агентной работы просто не работает, и опускать глубину ради скорости в таких сценариях бессмысленно.
Зато на уровне none, когда рассуждения выключены совсем, Luna превращается в быстрый чат-движок для простых вопросов — и для этого класса задач такой режим уместен. У флагмана Astra выключить рассуждения нельзя в принципе, так что здесь у младшей модели есть своё преимущество.
Для каких задач Luna не подходит
Сложный код с длинной цепочкой шагов. Рефакторинг большого репозитория, отладка запутанной логики, доведение инженерной задачи до конца без присмотра — здесь нужен GPT-6 Sol или Astra.
Многошаговая автоматизация. Сценарии, где модель сама планирует, вызывает инструменты и проверяет результат: 20,7% на AutomationBench означают, что до конца доходит примерно каждая пятая задача.
Исследовательская математика и узкая наука. Задачи такого класса — территория флагмана; у Luna их в релизных замерах OpenAI просто нет, и это красноречиво само по себе.
Генерация изображений и видео. Luna выдаёт только текст. Для картинок в каталоге есть отдельные модели.
Короткие сценарии
Разгрести почту. Разложить письма по темам, вытащить из них даты и суммы, отметить, что требует ответа.
Свести длинный документ. Загрузить отчёт или расшифровку целиком и получить сводку по всему тексту, а не по первым страницам.
Обработать пачку однотипных текстов. Сотня отзывов, заявок или анкет — классификация и извлечение полей за один проход.
Проверить формулировку. Переписать абзац, подобрать тон, объяснить термин — быстрые задачи, где тяжёлая модель избыточна.
Частые вопросы
Что умеет GPT-6 Luna? Работать с текстом и изображениями на входе, отвечать текстом, держать в памяти до 1 050 000 токенов и выполнять несложные агентные задачи с вызовом инструментов. Сильные стороны — чат, выжимки, извлечение данных и классификация в больших объёмах.
Справится ли Luna со сложным кодом? С отдельными задачами — да: на DeepSWE 1.1 она решает 66,6%. С длинными инженерными сценариями без присмотра — хуже: на AutomationBench 1.0.6 у неё 20,7% против 33,2% у Sol и 41,4% у Astra.
GPT-6 Luna врёт? Реже, чем прошлое поколение. По внутренним тестам OpenAI обман в задачах по коду упал с 9,5% до 2,8%, а молчание о сломанном инструменте — с 78,3% до 28,7%. Доля фактических ошибок на максимальном уровне рассуждений — 7,6%. Это замеры самой OpenAI, независимо их не проверяли.
Какой уровень рассуждений выбирать? По умолчанию стоит medium, и для большинства задач этого достаточно. Для агентной работы низкие уровни непригодны: на DeepSWE 1.1 Luna на low решает 2,4% задач против 66,6% на максимуме. Для простых вопросов, наоборот, можно выключить рассуждения совсем — уровнем none.
Принимает ли GPT-6 Luna изображения? Да, изображения — штатная модальность входа наряду с текстом. Выход у модели только текстовый.
Чем Luna отличается от Gemini 3.8 Flash? Luna дешевле в 7,5 раза, но уступает по сводному индексу интеллекта и не принимает аудио и видео. Подробное сравнение — в статье GPT-6 Luna против Gemini 3.8 Flash.