
Кратко
- Три главные быстрые дешёвые модели осени 2026 года умещаются в три балла по индексу Artificial Analysis: GLM-5.3-Flash — 42, Gemini 3.8 Flash — 41, DeepSeek V4.1 Flash — 39.
- Цена при этом различается в разы: у GLM-5.3-Flash выходной токен дешевле, чем у Gemini, в семь с половиной раз.
- Козырь Google — скорость: 343,5 токена в секунду против 225,6 у DeepSeek и 89,4 у GLM. Но первый токен Gemini отдаёт через 15 секунд, а DeepSeek — меньше чем за секунду.
- У обеих китайских моделей открытые веса под лицензией MIT, у Gemini 3.8 Flash — нет.
Класс быстрых дешёвых моделей за последний месяц стал самым плотным на рынке: 26 августа вышла GLM-5.3-Flash, 2 сентября — Gemini 3.8 Flash, 10 сентября — DeepSeek V4.1 Flash. Все три держат контекст на миллион токенов и стоят на порядок дешевле флагманов. Разница между ними по уму оказалась меньше, чем принято думать, а по цене — намного больше. Разбираемся, что из этого следует на практике.
Кто участвует и почему именно эти три
Flash, Lite, Mini, Turbo — приставки у всех разные, смысл один: модель, которая стоит в разы дешевле флагмана и отвечает быстрее, а по качеству отстаёт не настолько, чтобы это мешало в большинстве задач. Именно в этом классе сейчас идёт самая жёсткая конкуренция, потому что на него приходится основная масса реальных запросов.
Gemini 3.8 Flash вышла 2 сентября 2026 года, это закрытая модель Google с контекстом 1 048 576 токенов. GLM-5.3-Flash — модель китайской Z.ai от 26 августа, архитектура MoE на 320 миллиардов параметров, из которых при ответе работают 18 миллиардов, веса открыты под MIT. DeepSeek V4.1 Flash вышла 10 сентября, тоже с открытыми весами под MIT. Контекст в миллион токенов есть у всех трёх.
| Параметр | Gemini 3.8 Flash | GLM-5.3-Flash | DeepSeek V4.1 Flash |
|---|---|---|---|
| Разработчик | Z.ai | DeepSeek | |
| Дата выхода | 2 сентября 2026 | 26 августа 2026 | 10 сентября 2026 |
| Индекс Artificial Analysis | 41 | 42 | 39 |
| Цена входа за млн токенов | $0,75 | $0,15 | $0,30 |
| Цена выхода за млн токенов | $3,75 | $0,50 | $1,20 |
| Смешанная ставка | $0,58 | $0,10 | $0,18 |
| Скорость выдачи | 343,5 ток./с | 89,4 ток./с | 225,6 ток./с |
| Ожидание первого токена | 15,01 с | 2,68 с | 0,92 с |
| Контекст | 1 048 576 токенов | 1 млн токенов | 1 млн токенов |
| Веса | закрытые | открытые, MIT | открытые, MIT |
Цифры сняты с карточек моделей Artificial Analysis: Gemini 3.8 Flash, GLM-5.3-Flash, DeepSeek V4.1 Flash.
Предыдущее поколение модели Z.ai мы разбирали отдельно — в статье про GLM-5.2, и там же объясняли, что вообще значит «открытые веса» и зачем они нужны.
Индекс интеллекта: разрыв в три балла на троих
Сводный индекс Artificial Analysis усредняет результат по десяти тестам сразу — от терминальных задач до эрудиции и длинного контекста. На текущей версии индекса расклад такой: GLM-5.3-Flash — 42 балла, Gemini 3.8 Flash — 41, DeepSeek V4.1 Flash — 39.
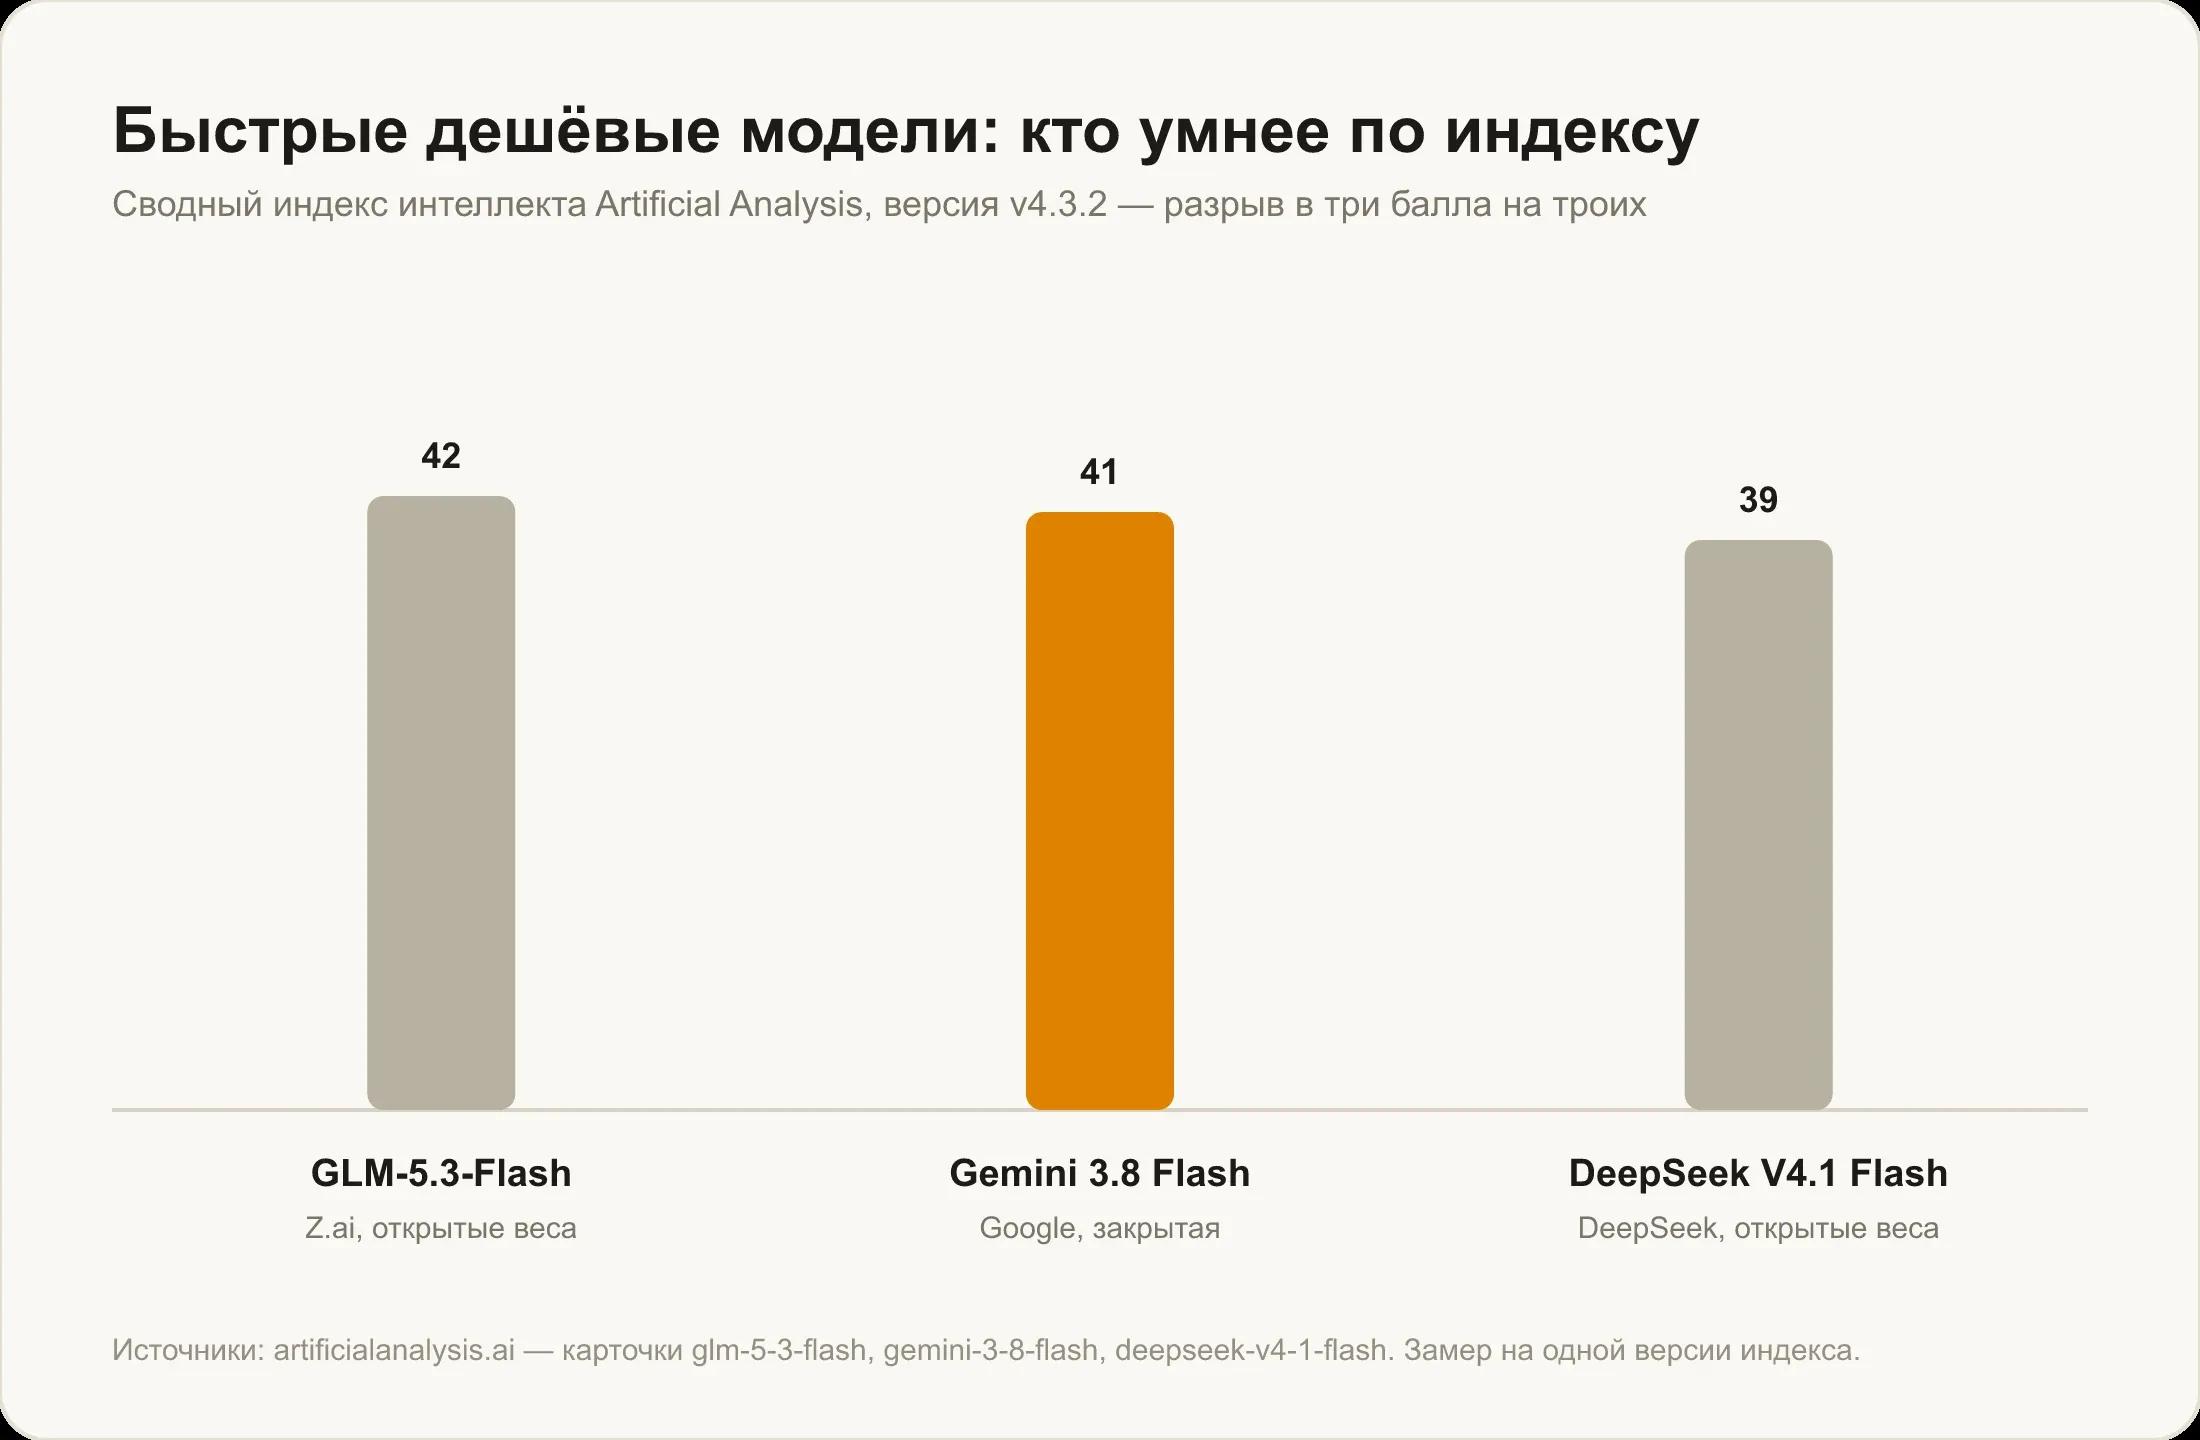
Три балла на трёх моделях — это разброс, который на конкретной задаче почти не чувствуется. Открытая китайская модель формально обходит закрытую модель Google, но объявлять её победителем по одному баллу было бы натяжкой: погрешность подобных сводных метрик того же порядка.
Будь разрыв в уме кратным, выбирать можно было бы по нему одному. Он не кратный, поэтому решают цена, скорость и лицензия.
Цена: разница в пять и семь раз
Gemini 3.8 Flash стоит $0,75 за миллион входных токенов и $3,75 за миллион выходных (прайс Google). DeepSeek V4.1 Flash — $0,30 и $1,20. GLM-5.3-Flash — $0,15 и $0,50.
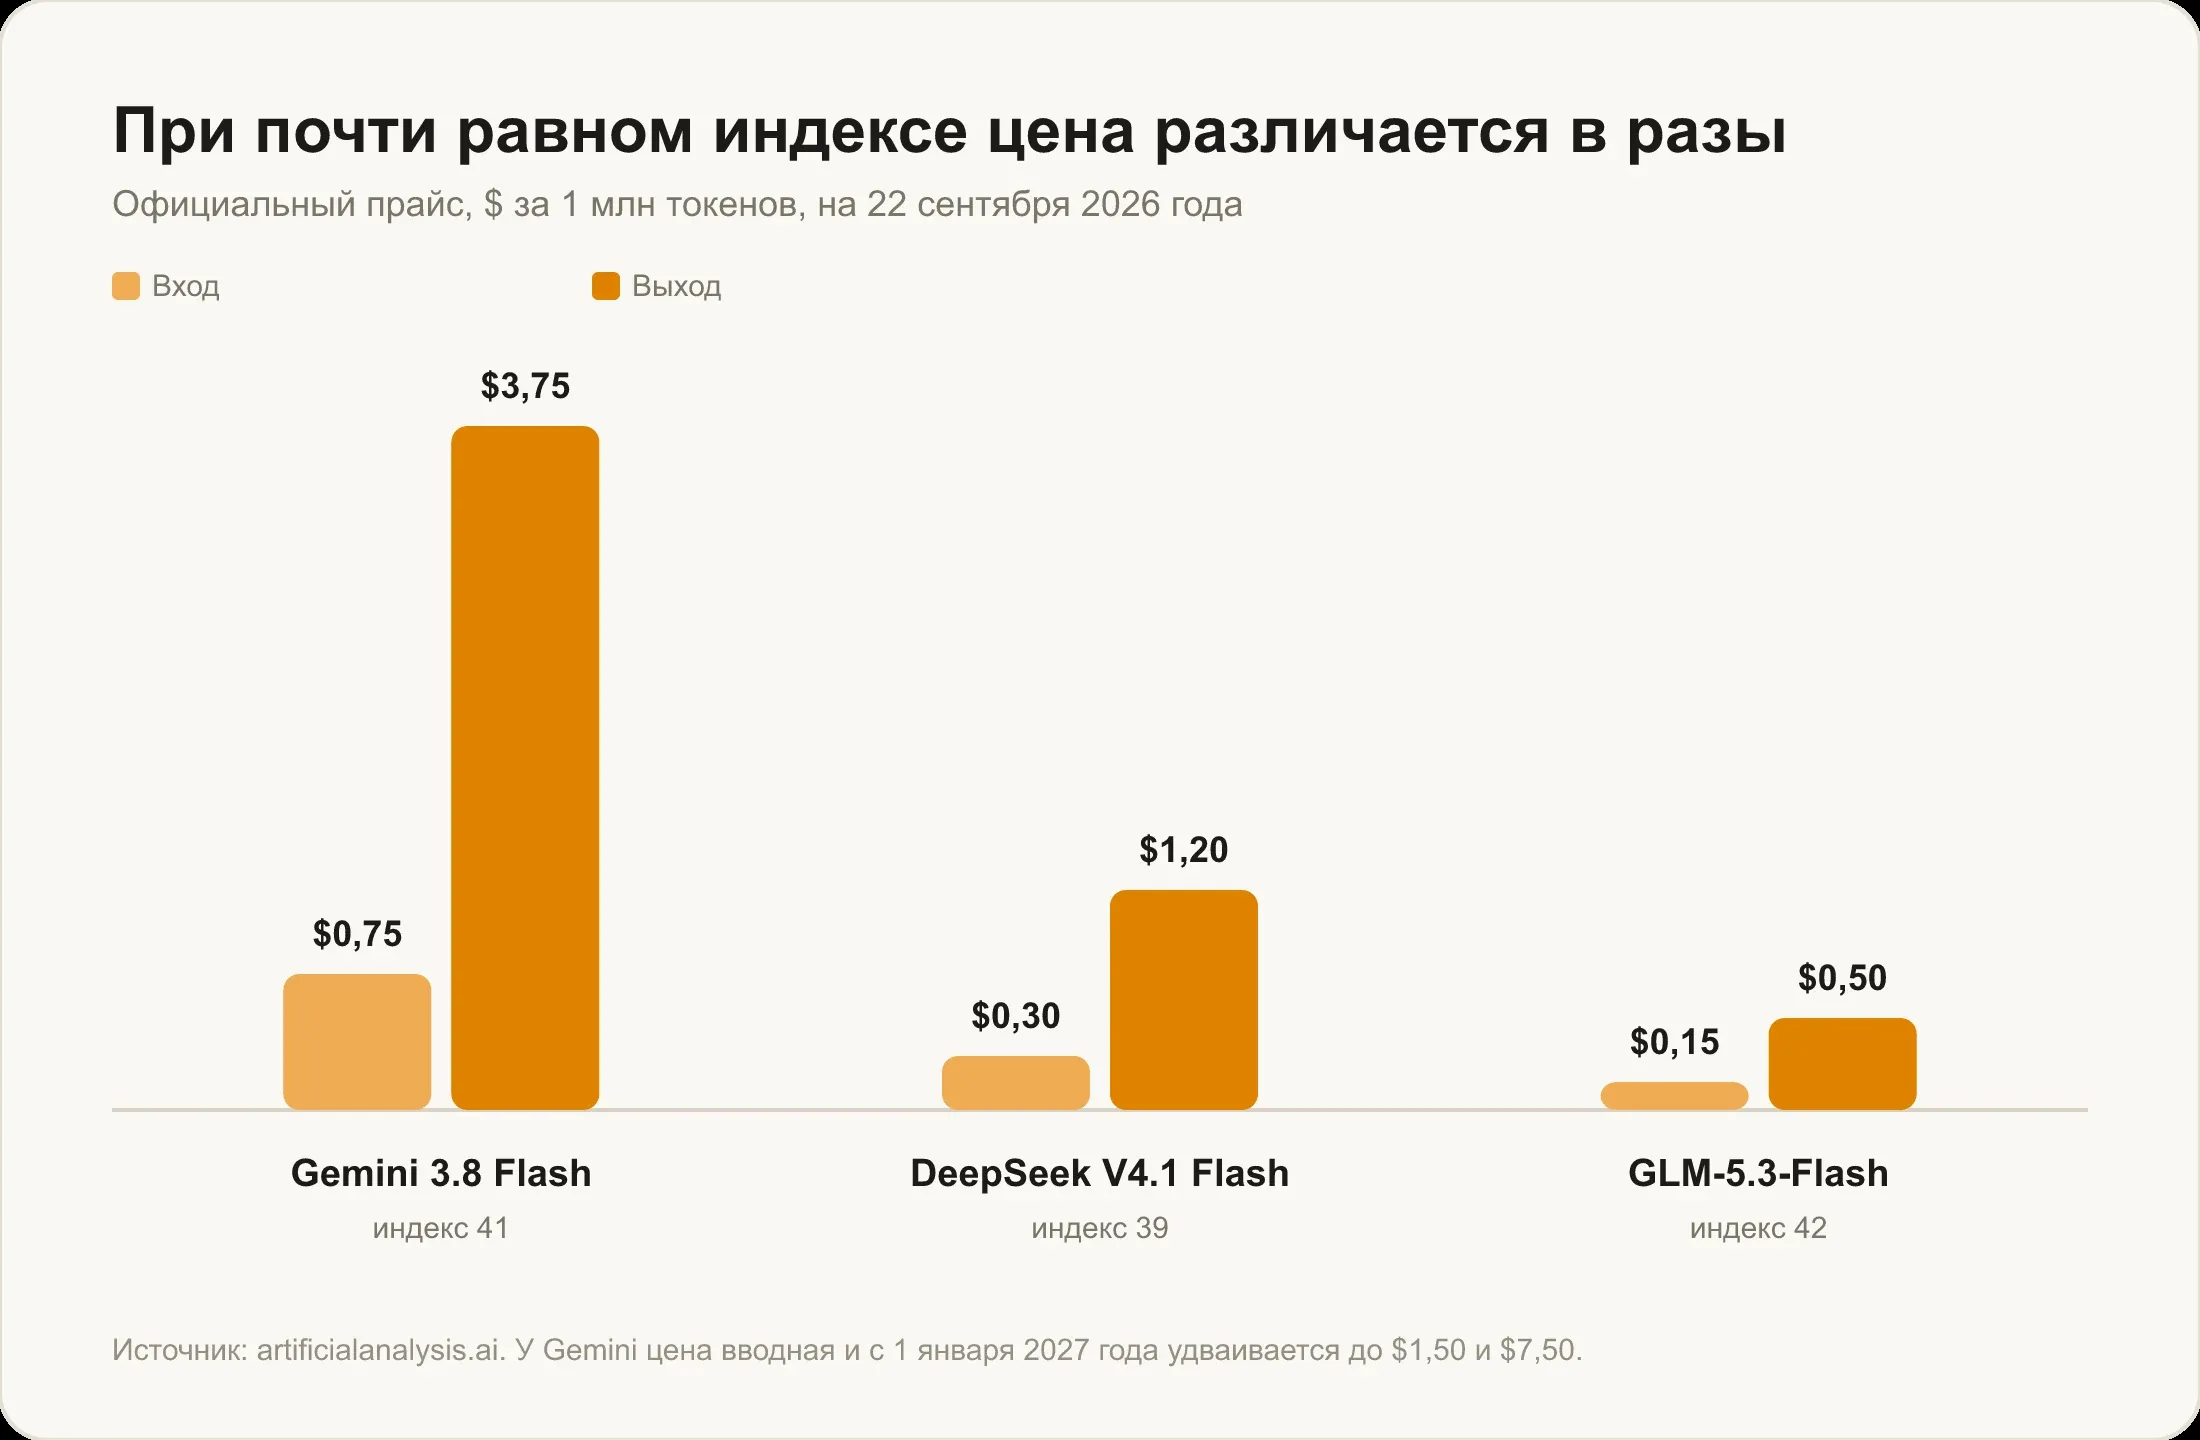
По входу GLM дешевле Gemini впятеро, по выходу — в семь с половиной раз. Artificial Analysis сводит это в одну ставку, считая типичную нагрузку как семь частей чтения из кэша, две части обычного ввода и одну часть вывода: $0,10 за миллион токенов у GLM, $0,18 у DeepSeek и $0,58 у Gemini (Artificial Analysis). Ставка получается ниже цены входного токена именно за счёт кэша: повторный контекст у всех трёх стоит копейки.
И у цены Google есть срок годности. Тариф $0,75 и $3,75 — вводный, он действует до 31 декабря 2026 года, а с 1 января 2027-го удваивается до $1,50 и $7,50. То есть разрыв по входному токену, который сегодня пятикратный, с нового года станет десятикратным, если китайские разработчики не поднимут цены следом.
Скорость: чем Google отыгрывает разницу
Прайсом дело не заканчивается: Gemini 3.8 Flash — самая быстрая модель из всех, что замеряет Artificial Analysis. 343,5 токена в секунду, первое место среди 202 оценённых моделей. DeepSeek V4.1 Flash выдаёт 225,6 токена в секунду, GLM-5.3-Flash — 89,4.
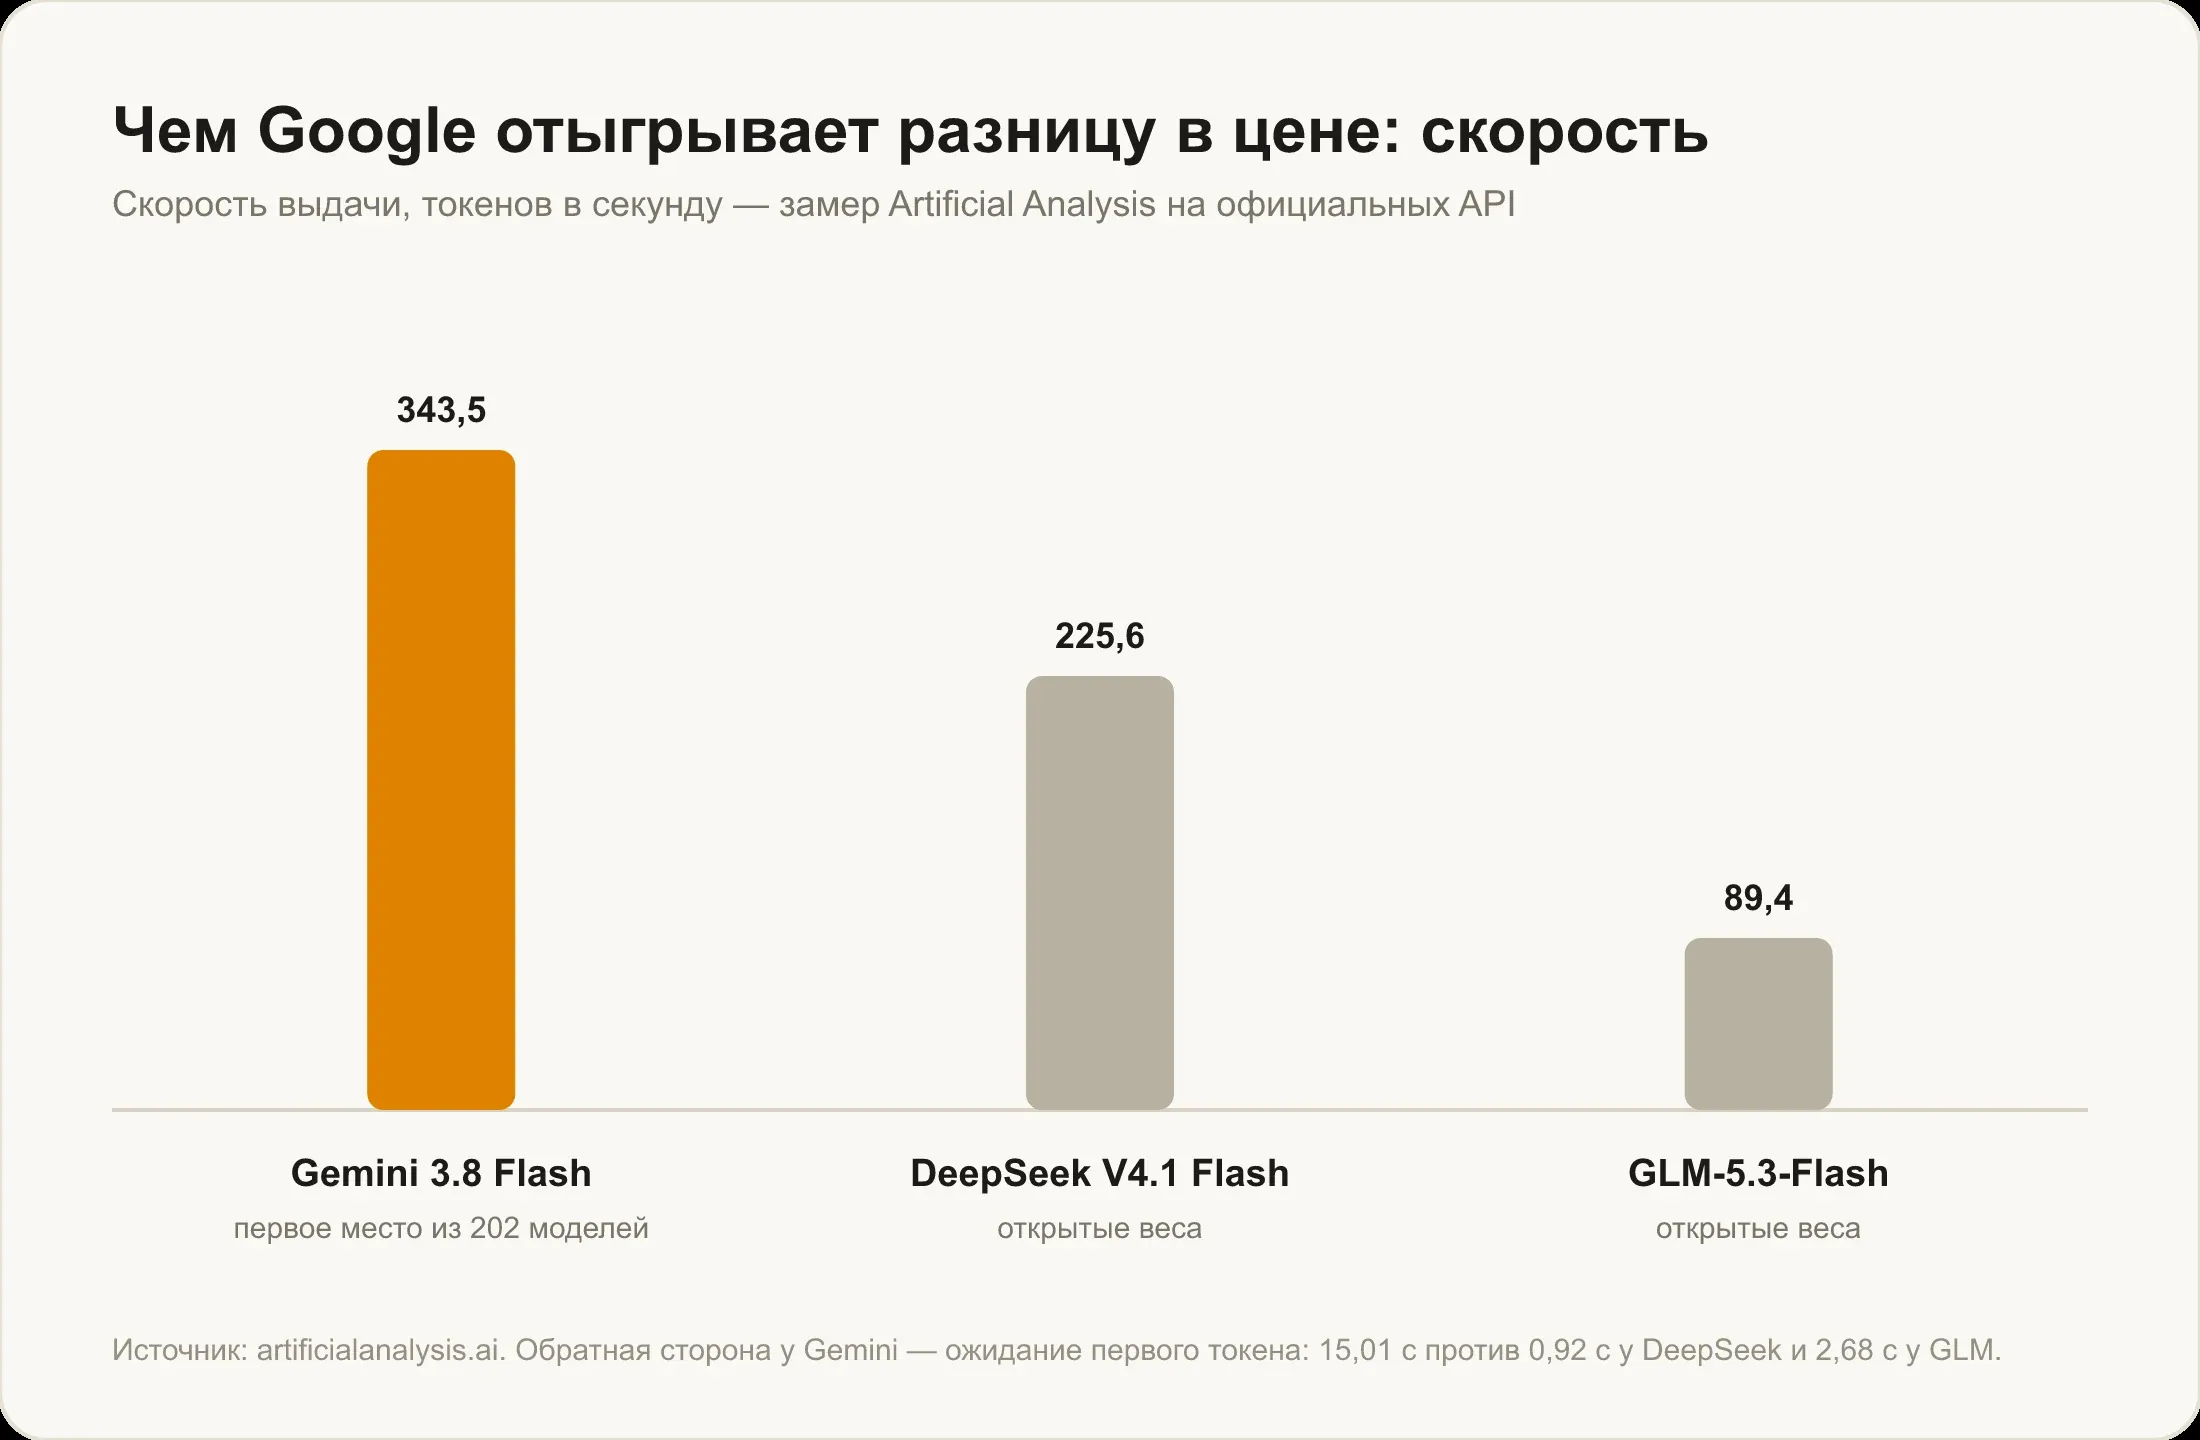
Разница между Gemini и GLM почти четырёхкратная, и на длинном ответе она заметна невооружённым глазом.
Но есть нюанс, который переворачивает картину на коротких запросах. Ожидание первого токена у Gemini 3.8 Flash — 15,01 секунды, у GLM-5.3-Flash — 2,68 секунды, у DeepSeek V4.1 Flash — 0,92 секунды. На вопрос, ответ на который укладывается в пару абзацев, DeepSeek успеет закончить раньше, чем Gemini начнёт. Преимущество Google проявляется только там, где ответ длинный: чем больше текста нужно выдать, тем сильнее высокая скорость перекрывает долгий старт.
Открытые веса против закрытой модели
У GLM-5.3-Flash и DeepSeek V4.1 Flash веса выложены под лицензией MIT: модель можно скачать и запустить на своём железе. У Gemini 3.8 Flash такой возможности нет и не предполагается.
Для обычного пользователя чата это различие почти ничего не меняет: локальный запуск модели такого размера требует серьёзного оборудования. Для компании, которой важно, чтобы данные не покидали контур, различие принципиальное, и оно часто перевешивает пару баллов индекса в любую сторону.
Взамен Google даёт то, чего нет у открытых моделей: Gemini 3.8 Flash встроена в приложение Gemini, в режим AI Mode в Поиске, в Google Sheets и в среды разработки Google. Если вы и так живёте в продуктах Google, модель оказывается под рукой без отдельной интеграции.
Что брать под какую задачу
Длинные ответы и потоковая генерация — сюда Gemini 3.8 Flash подходит лучше всех: она выдаёт текст почти вчетверо быстрее GLM. Чем длиннее ответ, тем сильнее это заметно.
Короткие запросы и диалог — здесь выигрывает DeepSeek V4.1 Flash с её стартом меньше секунды. Ожидание в пятнадцать секунд перед первым словом в живом разговоре раздражает сильнее, чем медленная печать.
Большие объёмы и жёсткий бюджет — GLM-5.3-Flash, при равном индексе и цене в разы ниже. Скорость у неё самая низкая из трёх, но если задачи идут пакетом и ответ не нужен мгновенно, это не аргумент.
Код и агентные сценарии — тут стоит смотреть не на сводный индекс, а на профильные тесты. Google заявляет для 3.8 Flash 73,7% на DeepSWE v1.1 и пишет, что модель обходит большинство более крупных фронтирных моделей в самостоятельном решении инженерных задач. Шире этот вопрос мы разбирали в материале какая нейросеть лучше пишет код.
Данные, которые нельзя отдавать наружу — только открытые веса, то есть GLM или DeepSeek, и только при наличии своего железа.
Оговорка про цифры
Баллы индекса Artificial Analysis сопоставимы только внутри одной версии методики, а её за сентябрь пересобирали дважды. Значения 42, 41 и 39 сняты на текущей версии v4.3.2; на версии, действовавшей в начале сентября, у Gemini 3.8 Flash было 59 баллов, и это то же самое качество, просто на другой шкале.
По той же причине не стоит сравнивать эти цифры с баллами из наших прежних материалов про GPT-6 Astra или Claude Fable 5.1 — там старая шкала. И отдельно: результаты вроде GPQA Diamond или SWE-bench Verified, которые для Gemini 3.8 Flash встречаются на сайтах-агрегаторах, Google не публиковала, первоисточника у них нет.
Все цифры в статье актуальны на 22 сентября 2026 года.
Как сравнить модели самому
Самый честный тест — одна и та же задача, заданная нескольким моделям подряд. Индекс усредняет десять чужих тестов, а вам нужна одна ваша задача, и на ней расстановка сил вполне может оказаться другой.
Gemini 3.8 Flash добавлена в каталог моделей Veruna AI и открыта на подписке Pro и выше — актуальные условия смотрите на странице тарифов. Модели в чате переключаются в одном окне, без VPN и иностранной карты, с оплатой в рублях, так что прогнать один и тот же запрос через несколько моделей и сравнить ответы можно не открывая второй сервис. Как именно устроен доступ из России, разобрано в статье как пользоваться Gemini 3.8 Flash. А если непонятно, с чего начинать выбор, есть общий разбор — как выбрать нейросеть под задачу.
Частые вопросы
Что умнее: Gemini 3.8 Flash или GLM 5.3 Flash? По сводному индексу Artificial Analysis GLM-5.3-Flash набирает 42 балла против 41 у Gemini 3.8 Flash. Разрыв в один балл — в пределах погрешности такой метрики, так что по уму модели практически равны, а различаются ценой, скоростью и лицензией.
Какая из трёх моделей дешевле? GLM-5.3-Flash: $0,15 за миллион входных токенов и $0,50 за миллион выходных. Это впятеро дешевле Gemini 3.8 Flash по входу и в семь с половиной раз по выходу. DeepSeek V4.1 Flash посередине — $0,30 и $1,20.
Какая модель быстрее? По скорости выдачи Gemini 3.8 Flash: 343,5 токена в секунду, первое место среди 202 моделей в замере Artificial Analysis. Но первый токен она отдаёт через 15 секунд, а DeepSeek V4.1 Flash — через 0,92 секунды, поэтому на коротких ответах быстрее оказывается DeepSeek.
У какой из моделей открытые веса? У GLM-5.3-Flash и DeepSeek V4.1 Flash, обе под лицензией MIT. Gemini 3.8 Flash закрытая, доступна только через сервисы Google и через платформы, которые к ним подключены.
Какой контекст у этих моделей? У всех трёх — миллион токенов. У Gemini 3.8 Flash точное значение 1 048 576 токенов на входе и отдельный лимит на ответ в 65 536 токенов.