
Кратко
- Muse Spark 1.3 от Meta (Meta признана экстремистской организацией, её деятельность запрещена на территории РФ) вышла 2 сентября 2026 года, Grok 4.7 от SpaceXAI — 21 сентября. Обе заявлены как модели под долгие агентные задачи, которые решаются часами.
- Контекст у Muse Spark 1.3 вдвое больше: 1 048 576 токенов против 500 000. Максимальный ответ у неё 943 718 токенов, а у Grok 4.7 лимит ответа вообще не публикуется.
- Токены у Muse Spark 1.3 дешевле: $1,25 и $4,25 против $2 и $6. Разрыв по итоговой стоимости задачи ещё заметнее, потому что Grok 4.7 тратит на рассуждения заметно больше токенов.
- Сравнить их в терминале невозможно: Meta замерила Terminal-Bench версии 2.1, SpaceXAI — версии 4.0. Это разные тесты, и любая таблица, где эти цифры стоят рядом, вводит в заблуждение.
Muse Spark 1.3 и Grok 4.7 вышли с интервалом в три недели и метят в одно и то же: многошаговые задачи, где модель работает сама и долго. Прямого сравнения от разработчиков нет и не могло быть: карточка Meta вышла за девятнадцать дней до релиза Grok 4.7, а SpaceXAI в своих таблицах сравнивает себя с флагманами OpenAI и Anthropic. Поэтому сопоставление приходится собирать из двух карточек и независимых замеров. Дальше — по пунктам, с прочерками там, где сопоставимых цифр не существует.
Характеристики рядом
| Параметр | Muse Spark 1.3 | Grok 4.7 |
|---|---|---|
| Разработчик | Meta | SpaceXAI |
| Дата выхода | 2 сентября 2026 | 21 сентября 2026 |
| Контекстное окно | 1 048 576 токенов | 500 000 токенов |
| Максимальный ответ | 943 718 токенов | не публикуется |
| Вход | текст, картинки, файлы, аудио, видео | текст, картинки |
| Выход | только текст | только текст |
| Рассуждения | не отключаются, 6 уровней, по умолчанию medium | не отключаются, 4 уровня, по умолчанию high |
| Цена ввода | $1,25 за млн токенов | $2 за млн токенов |
| Цена вывода | $4,25 за млн токенов | $6 за млн токенов |
| Чтение из кэша | $0,15 за млн токенов | $0,50 за млн токенов |
| Дата знаний | не раскрыта | примерно май-июнь 2026 |
| Правки в коде (DeepSWE v1.1) | 75,4% | 71,0% |
Первое, что бросается в глаза, — разрыв в мультимодальности. Muse Spark 1.3 принимает на вход файлы, аудио и видео, Grok 4.7 только текст и картинки. Правда, у аудио в Muse Spark есть оговорка в карточке модели на OpenRouter: понимание звука поддержано не полностью и качество ответов может проседать.
Второе — лимит ответа. 943 718 токенов за один вызов против непубликуемого значения у Grok 4.7, которая делит выход с промптом внутри общего окна в 500 тысяч. Если нужен очень длинный документ одним куском, выбор тут очевиден.
Код: разница в четыре пункта
DeepSWE v1.1, тест на правки в реальных кодовых базах, — единственный бенчмарк, по которому опубликованы результаты обеих моделей в сопоставимом виде.
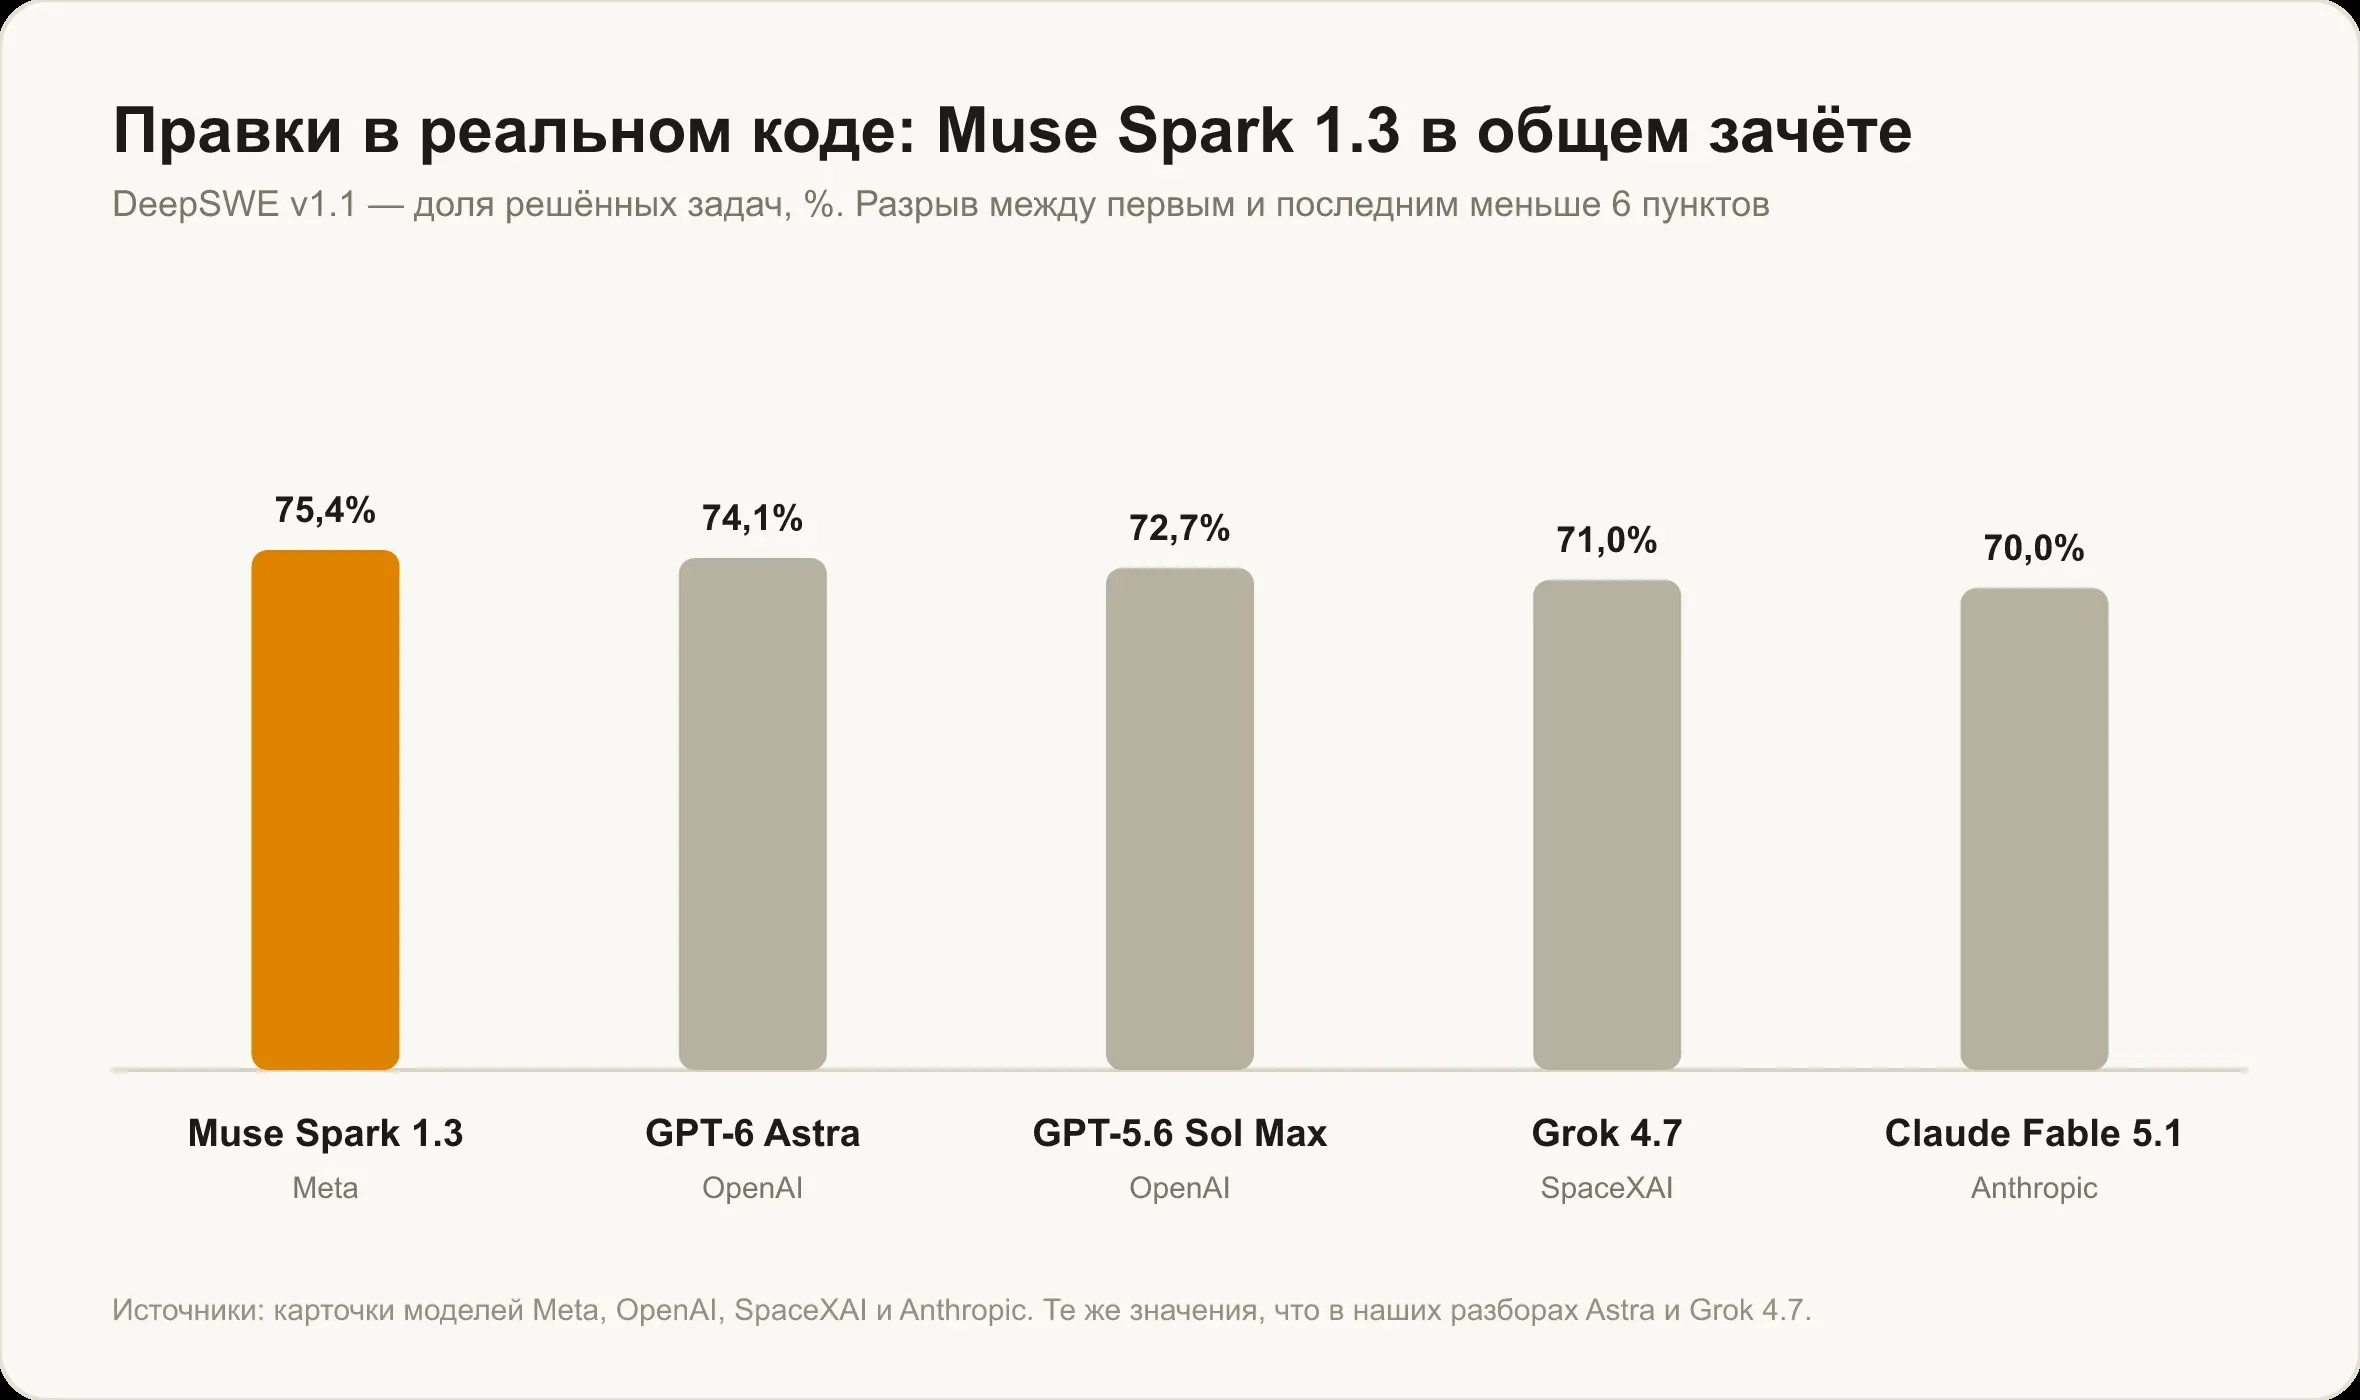
У Muse Spark 1.3 — 75,4%, у Grok 4.7 — 71,0%. Четыре с лишним пункта в пользу модели Meta, и при этом её токены ещё и дешевле.
Оговорка, без которой цифры читаются неправильно: обе величины — самоотчёты разработчиков. У теста есть публичный лидерборд, который прогоняет все модели через одинаковую обвязку, и ни одной из этих двух моделей на нём нет. Про Muse Spark 1.3 там нет записи даже спустя три недели после релиза, хотя предыдущая версия 1.2 на борде присутствует с результатом 55%. Подробно эту историю мы разобрали в материале про релиз Muse Spark 1.3.
Терминал: сравнить нельзя
Самая частая ошибка в чужих сравнениях этих двух моделей — таблица, где 88,8% Muse Spark стоят рядом с 38,0% Grok 4.7. Разрыв выглядит фантастическим, и это должно настораживать.
Дело в том, что это разные тесты. Meta замеряла Terminal-Bench версии 2.1, SpaceXAI — версии 4.0. Между версиями набор задач и их сложность меняются, поэтому проценты между собой несопоставимы. Косвенно это видно и по стороннему замеру: у Claude Fable 5.1 на Terminal-Bench 4.0 результат 55,8%, а у Muse Spark 1.3 на версии 2.1 — 88,8%, и вывод «Muse Spark в полтора раза лучше Fable в терминале» отсюда не следует.
Что здесь можно сказать честно: ни одна из двух моделей не имеет независимого подтверждения своего терминального результата. У Grok 4.7 официальные 38,0% получены с фирменной обвязкой SpaceXAI, а сторонний прогон дал около 26% для голой модели и 33% в составе агента. Про Muse Spark 1.3 на её версии теста независимых прогонов нет вообще: версия 2.1 к моменту релиза уже устарела, публичный лидерборд Terminal-Bench перешёл на 4.0.
Про расхождение у Grok мы писали отдельно в разборе что умеет Grok 4.7.
Деньги: где дешевизна настоящая
По прайсу Muse Spark 1.3 дешевле: $1,25 и $4,25 против $2 и $6. Разница не драматичная, обе модели стоят в разы меньше флагманов OpenAI и Anthropic.
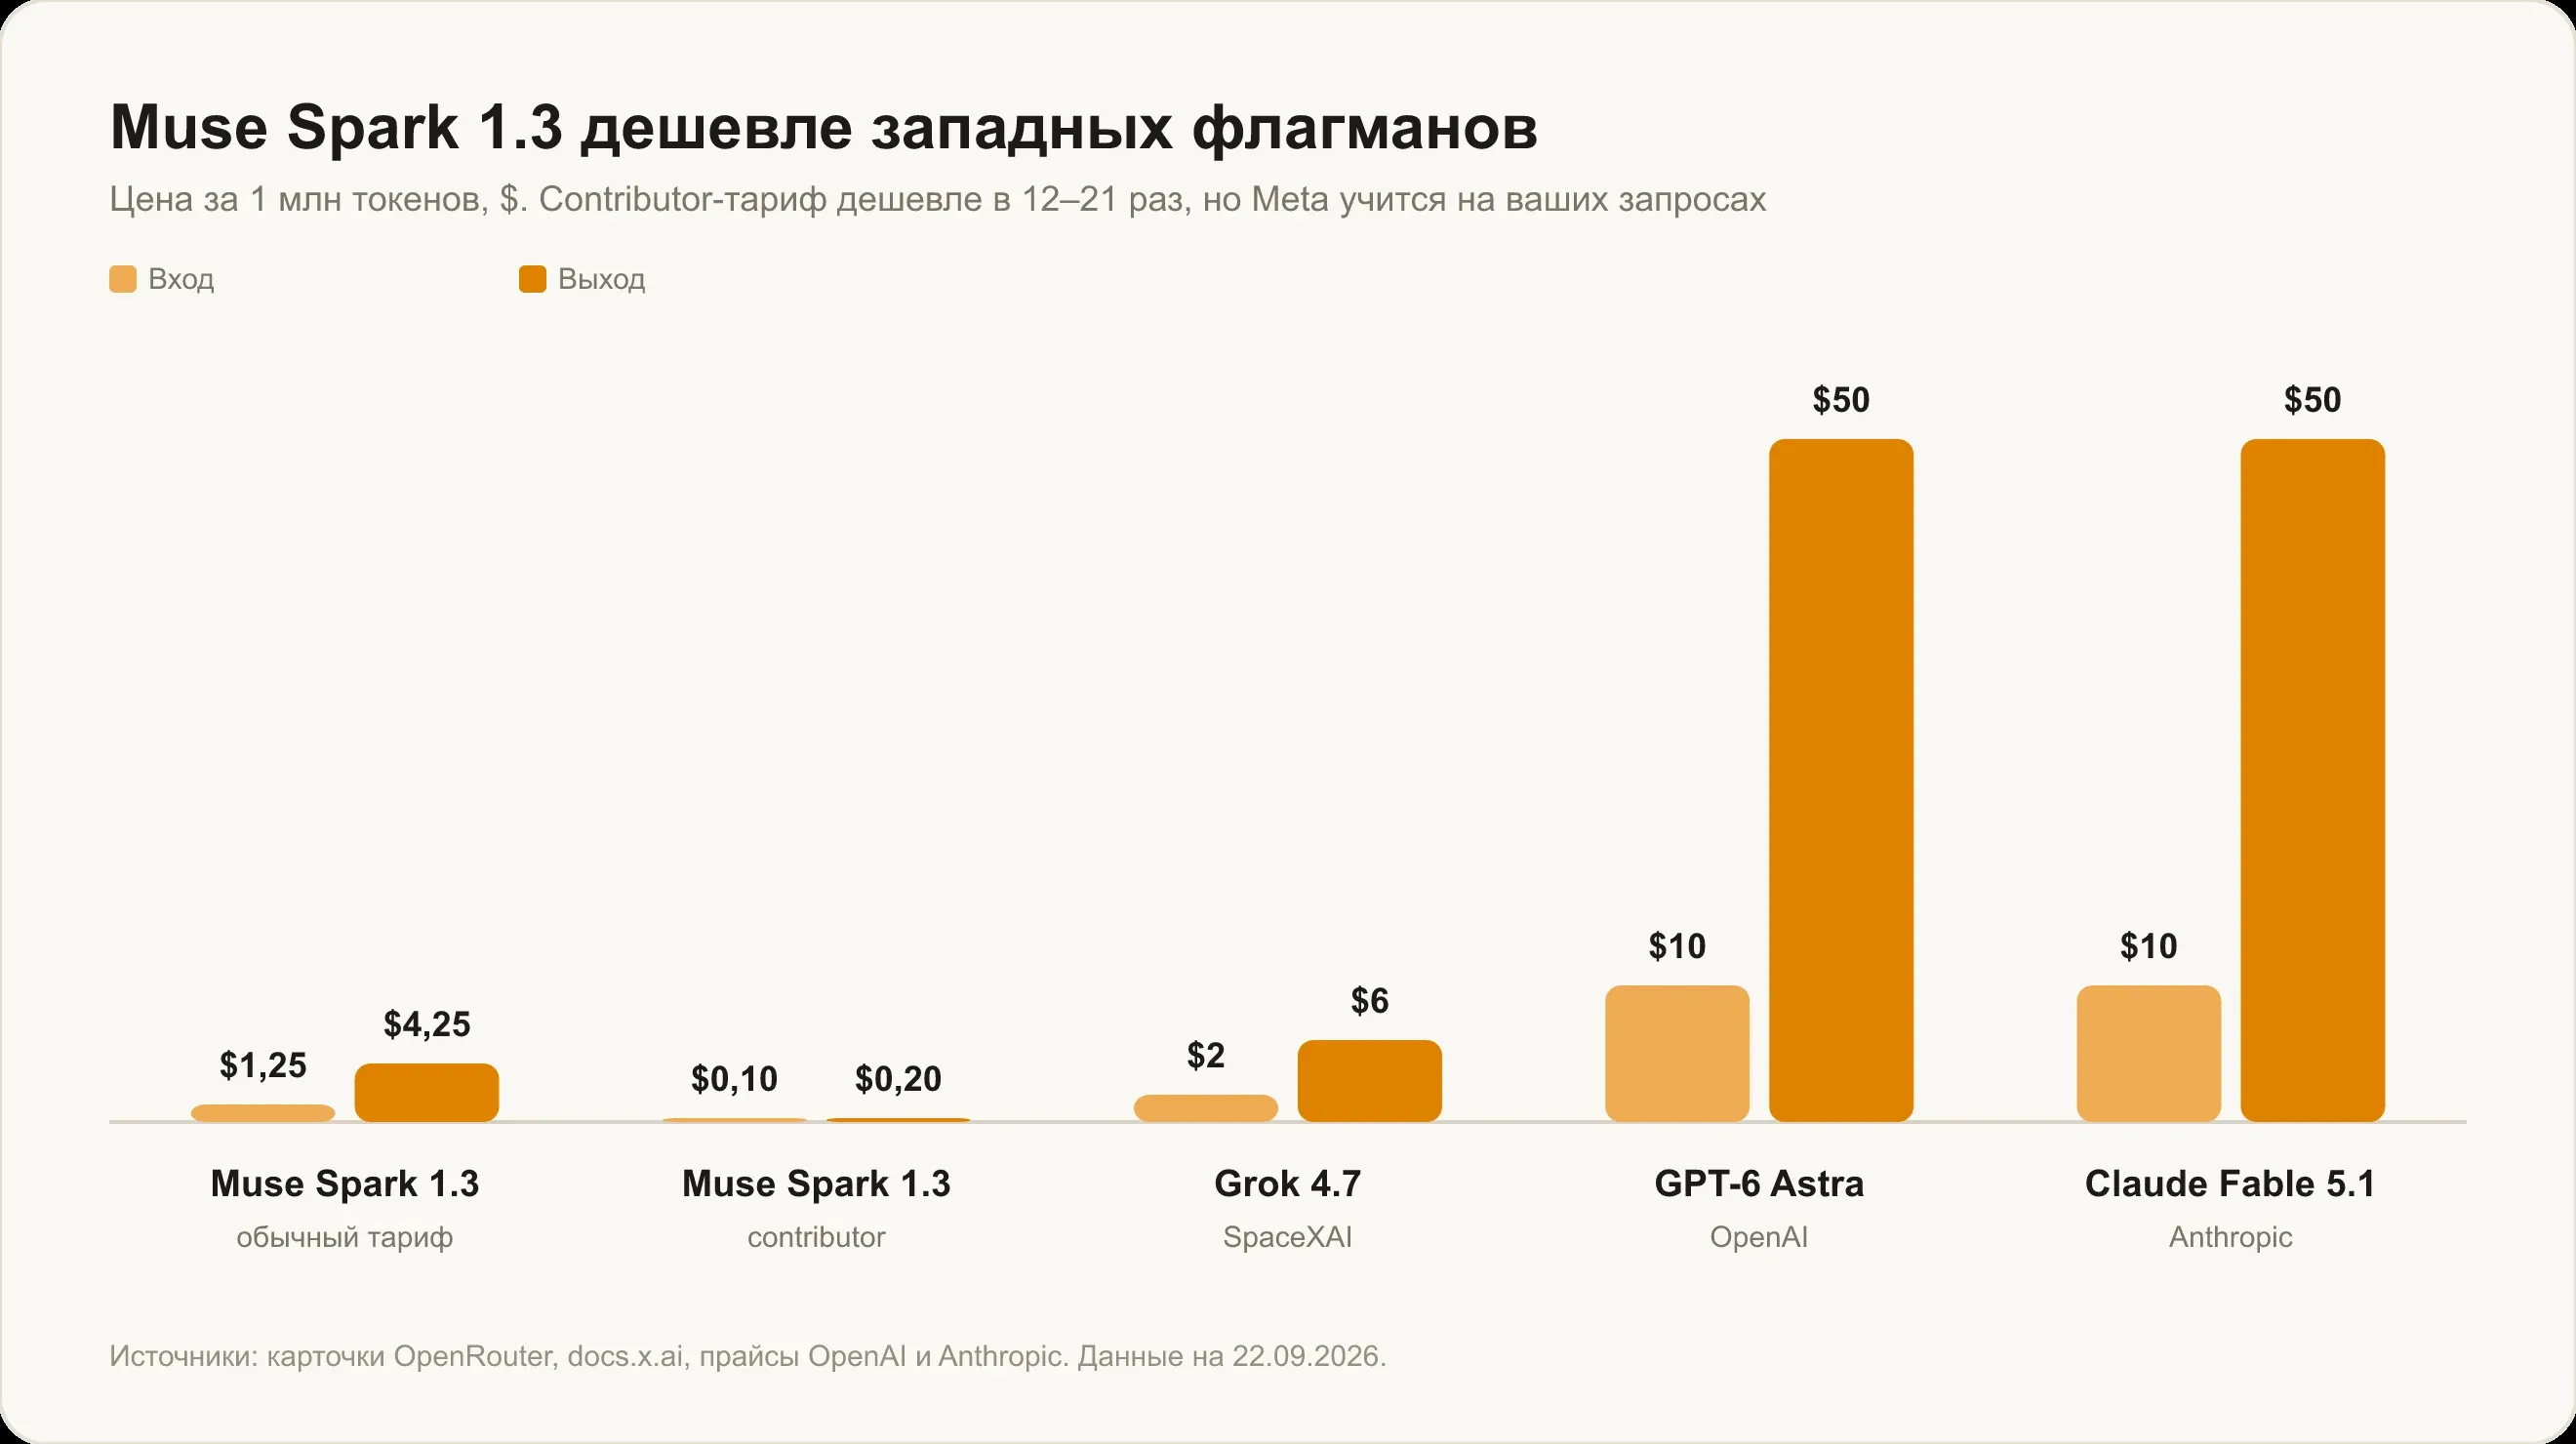
Но прайс за токен и счёт за работу — разные вещи, и тут разрыв больше. Grok 4.7 тратит на рассуждения около 81 тысячи токенов на задачу, больше чем вдвое против примерно 36 тысяч у предыдущей версии, и это съедает её дешёвый тариф.
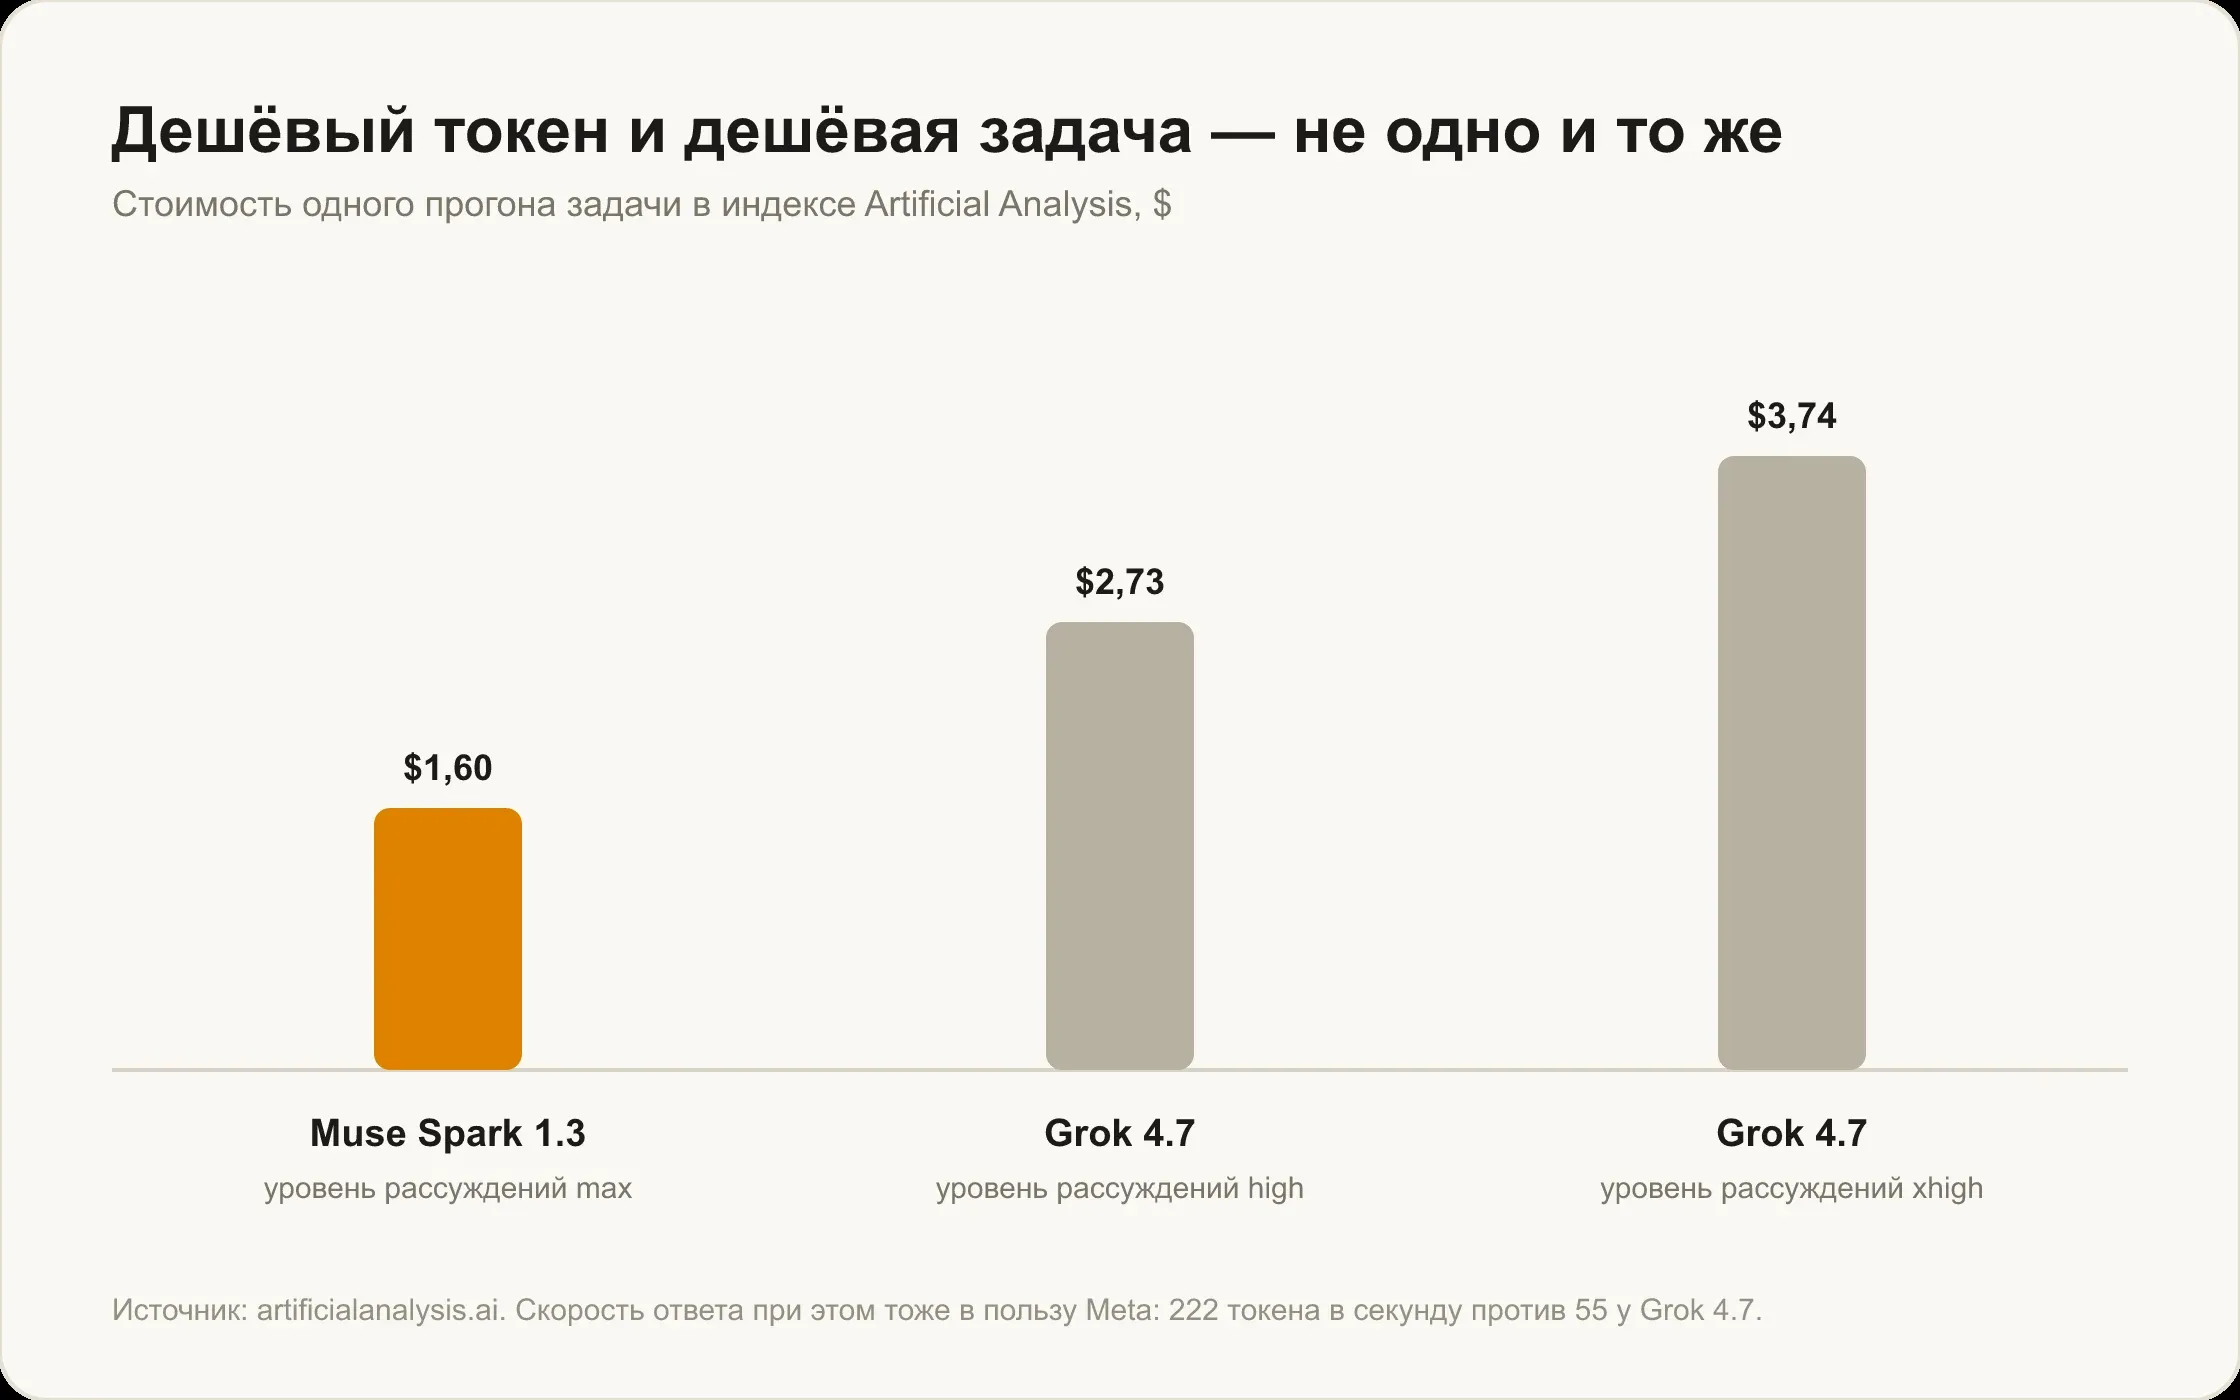
По замеру Artificial Analysis один прогон задачи в сводном индексе обходится в $1,60 у Muse Spark 1.3 на максимальном уровне рассуждений против $2,73 у Grok 4.7 на уровне high и $3,74 на xhigh. То есть по деньгам за результат модель Meta выходит дешевле в 1,7 раза против high и в 2,3 раза против xhigh. Это стоимость прогона сводного индекса, а не задачи DeepSWE: с ценниками из других наших разборов напрямую не сравнивается.
Есть и ещё два пункта в её пользу. Скорость: 222 токена в секунду на уровне max против 55,3 у Grok 4.7 на уровне high, разница вчетверо. И тариф: у Grok 4.7 при промпте свыше 200 тысяч токенов цена удваивается до $4 и $12, причём пересчитывается весь запрос целиком. У Muse Spark 1.3 такого порога нет, а контекст вдвое больше.
Про арифметику дешёвых токенов и дорогих задач у Grok мы писали подробнее в сравнении Grok 4.7 и GPT-6 Astra.
Где Grok 4.7 всё-таки впереди
Во-первых, у Grok 4.7 больше независимых замеров. Artificial Analysis прогнала её тесты сама и опубликовала подробный разбор, включая неприятные для разработчика цифры. У Muse Spark 1.3 такого разбора нет: цифры её карточки никто пока не воспроизвёл.
Во-вторых, узкие профессиональные задачи. На инженерных расчётах по электротехнике Grok 4.7 берёт 64,0%, обходя флагманы OpenAI и Anthropic, а на агентных юридических задачах её преимущество кратное. У Muse Spark 1.3 подобных замеров в карточке просто нет: там только кодинг, агентность и длинный контекст, ни математики, ни узких отраслевых тестов.
В-третьих, сводный индекс. В общем зачёте Artificial Analysis обе модели идут рядом: Muse Spark 1.3 тринадцатая из 202 оценённых, Grok 4.7 шестнадцатая. Разрыв есть, но он меньше, чем можно было бы предположить по разнице в кодинге.
И в-четвёртых, у Grok 4.7 понятна дата знаний, примерно май-июнь 2026 года. Meta для своей линейки дату отсечки не публикует вообще, и для задач, где важна свежесть фактов, это минус.
Что выбрать под задачу
Длинный документ или большая кодовая база на входе. Muse Spark 1.3: контекст вдвое больше, по поиску фактов в длинном тексте у неё 98,5% на диапазоне 256–512 тысяч токенов. У Grok 4.7 по длинному контексту независимый замер, наоборот, фиксирует откат относительно предыдущей версии.
Очень длинный ответ на выходе. Только Muse Spark 1.3: 943 718 токенов за вызов, у Grok 4.7 выход делит общее окно вместе с промптом.
Файлы, аудио или видео на входе. Muse Spark 1.3, у Grok 4.7 этих модальностей нет. С поправкой на то, что аудио у модели Meta поддержано не полностью.
Инженерный расчёт или юридический разбор. Grok 4.7: это её сильные стороны по замерам разработчика, а у конкурента таких тестов в карточке нет.
Задача, где важна проверяемость цифр. Grok 4.7: её результаты хотя бы частично прогнала независимая сторона, пусть и получила цифры скромнее заявленных.
Короткий бытовой вопрос. Ни та ни другая. У обеих рассуждения не отключаются, и на простом запросе это только лишнее ожидание. В чате, где модели переключаются в одном окне, разумнее взять что-нибудь полегче.
Как сравнить их самому
Обе модели есть в каталоге Veruna AI — сервиса, который даёт доступ сразу ко многим нейросетям в одном чате, без VPN, без иностранной карты и с оплатой в рублях. Grok 4.7 уже открыта на подписке Pro и выше, Muse Spark 1.3 будет открыта там же; условия смотрите на странице тарифов.
Самый честный способ выбрать — дать обеим одну и ту же задачу и сравнить ответы: бенчмарки меряют усреднённую сложность, а не вашу кодовую базу и не ваш документ. Про то, как подключиться к каждой из моделей, у нас есть отдельные разборы: как пользоваться Muse Spark 1.3 и как пользоваться Grok 4.7.
Частые вопросы
Что лучше, Muse Spark 1.3 или Grok 4.7? Зависит от задачи. У Muse Spark 1.3 вдвое больше контекст, дешевле токены, выше скорость и лучше результат в правках кода: 75,4% против 71,0% на DeepSWE v1.1. У Grok 4.7 больше независимых замеров, известна дата знаний и есть сильные результаты в инженерных и юридических задачах, которых у конкурента просто не измеряли.
Можно ли сравнивать их результаты в терминале? Нет. Meta замеряла Terminal-Bench версии 2.1, SpaceXAI — версии 4.0. Это разные наборы задач, и проценты между версиями несопоставимы.
Какая из них дешевле? Muse Spark 1.3 и по прайсу ($1,25 и $4,25 против $2 и $6), и по счёту за работу: один прогон задачи в индексе Artificial Analysis обходится в $1,60 против $2,73 у Grok 4.7. Плюс у Grok при промпте от 200 тысяч токенов тариф удваивается.
У какой модели больше контекст? У Muse Spark 1.3: 1 048 576 токенов против 500 000 у Grok 4.7. Разница вдвое. Лимит на длину одного ответа у Muse Spark 943 718 токенов, у Grok 4.7 он не публикуется.
Можно ли отключить рассуждения? Ни у той ни у другой. У Muse Spark 1.3 шесть уровней глубины от minimal до max, по умолчанию medium. У Grok 4.7 четыре уровня от low до xhigh, по умолчанию high. Режима без раздумий нет ни у одной.